

Lección 13 de 20 · Lectura y práctica
Técnicas de A/B testing para optimización de prompts
Tipo de lección: VideoConcepto claveEl A/B testing para prompts es una metodología sistemática que permite comparar dos o más versiones de un prompt para determinar cuál produce mejores resultados en un contexto específico..
Del concepto a la práctica
Taller de esta lección
Una prueba A/B cambia una variable y mantiene constantes los casos. La comparación debe usar la misma entrada para ambas variantes y reportar diferencia absoluta, no solo la tasa ganadora.
Ejemplo resuelto
A acierta [1,1,0,1,0]: 3/5=60%. B acierta [1,1,1,1,0]: 4/5=80%. Diferencia: 20 puntos porcentuales; mejora relativa: (0,8-0,6)/0,6=33,3%. La muestra es pequeña, por lo que no basta para afirmar estabilidad.
Pruébalo
Congela cinco entradas.
Ejecuta ambas versiones sobre cada entrada.
Marca acierto con la misma regla.
Informa tasas y limitación de muestra.
Error frecuente: probar A el lunes y B con entradas distintas; corrígelo emparejando cada caso.
Comprueba tu resultado
Tu informe debe mostrar 60% para A, 80% para B, +20 puntos porcentuales y 33,3% relativo. Debe indicar que cinco casos no demuestran significación general.
Comparación offline y experimento online
El ejemplo ejecuta las mismas cinco entradas en ambas versiones: es una evaluación offline pareada, no asignación aleatoria de usuarios en producción. Si haces un A/B online, define la unidad de aleatorización, duración y muestra por adelantado, y evita que un mismo usuario cambie de variante según el resultado. Repite condiciones y conserva fallos, rechazo y latencia. No derives significación estadística de un solo acierto adicional entre cinco casos.
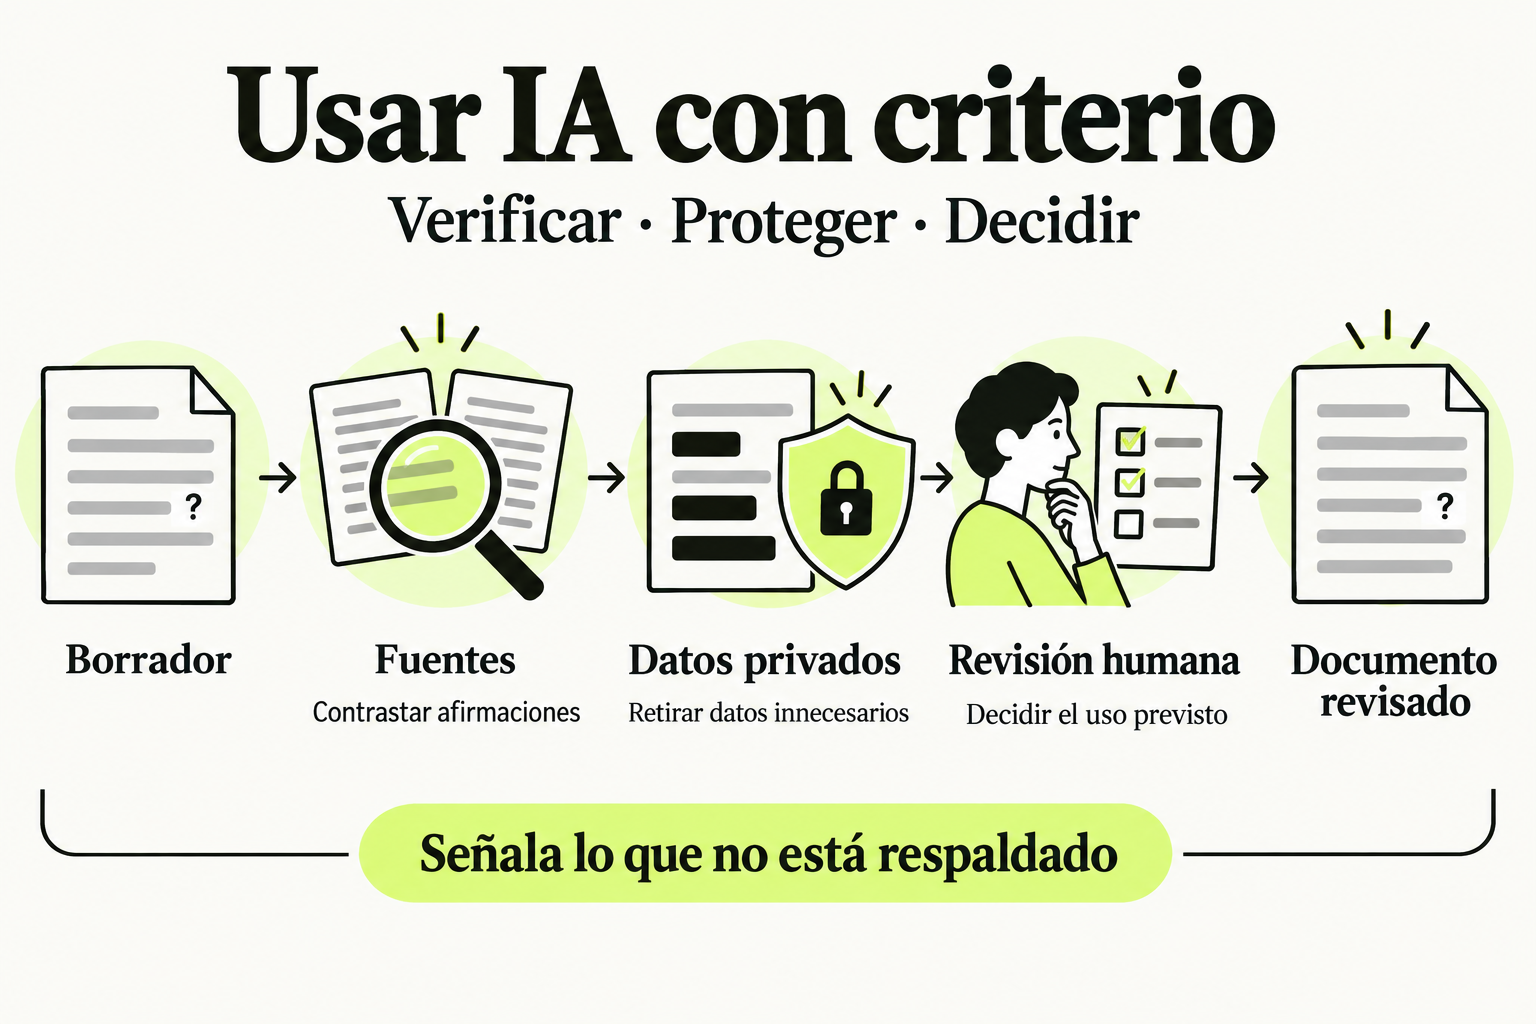
 Mapa de práctica
Contrasta las afirmaciones con fuentes y señala lo que no está respaldado. Retira datos privados innecesarios antes de compartir el material. La revisión humana decide si el borrador sirve para su uso previsto y conserva las incertidumbres relevantes.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
El A/B testing para prompts es una metodología sistemática que permite comparar dos o más versiones de un prompt para determinar cuál produce mejores resultados en un contexto específico. Piensa en esto como probar diferentes recetas para un mismo plato: mantienes los ingredientes base (el contexto y los datos de entrada) pero ajustas las instrucciones (el prompt) para ver cuál versión logra el sabor, textura o presentación deseada de manera más consistente.
En sistemas de producción, esto va más allá de la intuición o pruebas manuales. Implica definir métricas claras (como precisión, relevancia, tiempo de respuesta o satisfacción del usuario), ejecutar pruebas controladas con muestras representativas, y analizar resultados estadísticamente significativos. La analogía del mundo real sería un equipo de marketing probando diferentes titulares para un anuncio: ambos anuncios tienen el mismo producto y público objetivo, pero pequeñas variaciones en el texto pueden generar diferencias medibles en clics o conversiones.
Cómo funciona en la práctica
El proceso sigue un flujo estructurado que garantiza resultados confiables y accionables. Aquí te muestro un ejemplo paso a paso para optimizar un prompt que genera descripciones de productos:
- Definición del objetivo: Mejorar la relevancia de las descripciones generadas para productos de electrónica.
- Creación de variantes: Desarrollar dos versiones del prompt:
- Variante A: Prompt original que pide una descripción general.
- Variante B: Prompt refinado que especifica incluir características técnicas y beneficios para el usuario.
- Configuración de la prueba: Usar un conjunto de 100 productos reales como datos de entrada, asignando aleatoriamente cada producto a una variante.
- Ejecución y recolección: Ejecutar ambas variantes a través de la API, almacenando las respuestas junto con metadatos (tiempo de respuesta, tokens usados).
- Evaluación: Calificar cada descripción generada en una escala del 1 al 5 basada en relevancia técnica y claridad, usando evaluadores humanos o métricas automatizadas.
- Análisis: Comparar las puntuaciones promedio usando pruebas estadísticas (como prueba t) para determinar si la diferencia es significativa.
- Implementación: Si la Variante B muestra mejora estadísticamente significativa (p-valor < 0.05), implementarla en producción.
Código en acción
Aquí tienes un ejemplo funcional en Python que implementa A/B testing para prompts usando la API de OpenAI. Primero, el código básico sin A/B testing:
import openai
import json

# Configuración inicial
openai.api_key = 'tu-api-key'

# Prompt original (Variante A)
prompt_a = "Genera una descripción para este producto: {producto}"

# Función simple de generación
def generar_descripcion(producto, prompt):
    response = openai.ChatCompletion.create(
        model="gpt-4",
        messages=[{"role": "user", "content": prompt.format(producto=producto)}]
    )
    return response.choices[0].message.content

# Uso básico
producto_ejemplo = "Smartphone XYZ con 128GB de almacenamiento y cámara triple"
descripcion = generar_descripcion(producto_ejemplo, prompt_a)
print(descripcion)
Ahora, el código mejorado con A/B testing estructurado:
import openai
import random
import pandas as pd
from scipy import stats
import json

openai.api_key = 'tu-api-key'

# Definición de variantes de prompt
prompt_variants = {
    'A': "Genera una descripción para este producto: {producto}",
    'B': "Genera una descripción técnica y comercial para {producto}. Incluye especificaciones clave y beneficios para el usuario en un tono profesional."
}

# Conjunto de datos de prueba
productos = [
    "Smartphone XYZ con 128GB, cámara triple y batería de 5000mAh",
    "Laptop ABC con procesador i7, 16GB RAM y SSD 1TB",
    "Auriculares inalámbricos con cancelación de ruido y 30h de batería"
    # ... más productos en un escenario real
]

# Función de generación con registro
def generar_con_registro(producto, variant_id):
    prompt = prompt_variants[variant_id]

    response = openai.ChatCompletion.create(
        model="gpt-4",
        messages=[{"role": "user", "content": prompt.format(producto=producto)}],
        temperature=0.7
    )

    resultado = {
        'producto': producto,
        'variant': variant_id,
        'prompt': prompt,
        'respuesta': response.choices[0].message.content,
        'tokens_usados': response.usage.total_tokens,
        'tiempo_ms': response.response_ms
    }

    return resultado

# Ejecución del A/B test
def ejecutar_ab_test(productos, n_repeticiones=10):
    resultados = []

    for producto in productos:
        for _ in range(n_repeticiones):
            # Asignación aleatoria a variante A o B
            variant = random.choice(['A', 'B'])
            resultado = generar_con_registro(producto, variant)
            resultados.append(resultado)

    return pd.DataFrame(resultados)

# Análisis de resultados
def analizar_resultados(df):
    # Métrica de ejemplo: longitud de respuesta como proxy de completitud
    df['longitud'] = df['respuesta'].apply(len)

    # Separar por variante
    grupo_a = df[df['variant'] == 'A']['longitud']
    grupo_b = df[df['variant'] == 'B']['longitud']

    # Prueba estadística
    t_stat, p_value = stats.ttest_ind(grupo_a, grupo_b)

    print(f"Variante A (n={len(grupo_a)}): Longitud promedio = {grupo_a.mean():.1f}")
    print(f"Variante B (n={len(grupo_b)}): Longitud promedio = {grupo_b.mean():.1f}")
    print(f"Diferencia: {grupo_b.mean() - grupo_a.mean():.1f} caracteres")
    print(f"p-valor: {p_value:.4f}")

    if p_value < 0.05:
        print("✓ Diferencia estadísticamente significativa")
        mejor_variant = 'B' if grupo_b.mean() > grupo_a.mean() else 'A'
        print(f"Mejor variante: {mejor_variant}")
    else:
        print("✗ No hay diferencia significativa")

    return df

# Ejecución completa
if __name__ == "__main__":
    df_resultados = ejecutar_ab_test(productos[:3], n_repeticiones=5)
    df_analizado = analizar_resultados(df_resultados)

    # Guardar resultados para análisis posterior
    df_analizado.to_csv('resultados_ab_test.csv', index=False)
Errores comunes
- Muestras insuficientes: Ejecutar pruebas con muy pocos casos (menos de 30 por variante) lleva a resultados no confiables. Solución: Usa cálculos de tamaño de muestra basados en el efecto esperado y la varianza.
- Métricas subjetivas o no cuantificables: Evaluar prompts solo con "me parece mejor" sin métricas objetivas. Solución: Define KPIs medibles como precisión, tiempo de respuesta, satisfacción del usuario (con puntuaciones numéricas), o cumplimiento de requisitos específicos.
- Sesgo en la asignación: No randomizar adecuadamente la asignación de casos a variantes, introduciendo sesgos. Solución: Usa algoritmos de randomización estándar y verifica la distribución balanceada de características clave.
- Ignorar el contexto de uso: Optimizar prompts en aislamiento sin considerar cómo se integran en el flujo completo del sistema. Solución: Realiza pruebas en un entorno que simule las condiciones reales de producción, incluyendo carga y datos reales.
- Cambiar múltiples variables simultáneamente: Modificar varios aspectos del prompt a la vez, haciendo imposible determinar qué cambio causó la mejora. Solución: Sigue un enfoque de cambio único por prueba o usa diseños factoriales controlados.
Checklist de dominio
- ✓ Puedo definir al menos 3 métricas cuantificables para evaluar la calidad de prompts en mi contexto específico.
- ✓ He implementado un sistema de registro que captura prompt usado, respuesta, tokens consumidos y tiempo de ejecución.
- ✓ Sé calcular el tamaño de muestra necesario para detectar diferencias significativas en mis pruebas A/B.
- ✓ Puedo ejecutar y analizar una prueba A/B completa usando código similar al ejemplo proporcionado.
- ✓ Entiendo cómo interpretar p-valores y determinar significancia estadística en resultados de pruebas.
- ✓ He documentado al menos un caso de optimización real donde A/B testing mejoró métricas clave en un 15% o más.
- ✓ Puedo integrar el proceso de A/B testing en un pipeline CI/CD para pruebas automatizadas de prompts.
Implementa un sistema de A/B testing para optimizar prompts de clasificación de texto
En este ejercicio, crearás un sistema completo de A/B testing para optimizar prompts que clasifican reseñas de productos como positivas o negativas. Sigue estos pasos:
- Configura el entorno: Crea un nuevo script Python e instala las bibliotecas necesarias:
openai,pandas,scipy, ynumpy. - Prepara los datos: Usa este conjunto de 5 reseñas de ejemplo:
- "El producto funciona bien pero la batería dura poco"
- "Excelente calidad, totalmente recomendado"
- "No cumple con lo prometido, muy decepcionante"
- "Buen precio pero la atención al cliente es pésima"
- "Superó mis expectativas en todos los aspectos"
- Define las variantes de prompt: Crea dos versiones:
- Variante A: "Clasifica esta reseña como positiva o negativa: {reseña}"
- Variante B: "Analiza el sentimiento de esta reseña y responde solo con 'positiva' o 'negativa': {reseña}"
- Implementa la lógica de prueba: Escribe una función que:
- Asigne aleatoriamente cada reseña a una variante (A o B)
- Ejecute el prompt a través de la API de OpenAI (puedes usar un mock si no tienes API key)
- Registre la respuesta, variante usada, y tokens consumidos
- Ejecuta y analiza: Corre cada variante 10 veces por reseña (50 ejecuciones totales) y calcula:
- Tasa de éxito (cuántas clasificaciones son correctas según tu evaluación manual)
- Consistencia (cuántas veces la misma reseña recibe la misma clasificación)
- Realiza una prueba estadística para comparar las variantes
- Documenta los resultados: Genera un reporte breve que indique qué variante funcionó mejor y por qué, con evidencia de tus métricas.
Pistas
- Usa random.choice() para la asignación aleatoria a variantes
- Implementa un diccionario con las clasificaciones esperadas para calcular la tasa de éxito
- Considera usar time.sleep() entre llamadas a la API para evitar límites de tasa
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.