

Lección 14 de 20 · Lectura y práctica
Práctica: Implementación de sistema de evaluación de prompts
Concepto claveLa evaluación sistemática de prompts es el proceso de medir cuantitativamente la calidad y consistencia de las instrucciones que envías a modelos como GPT o Claude. Imagina que eres un chef probando recetas: no solo.
Del concepto a la práctica
Taller de esta lección
Un evaluador automatizado convierte casos en decisiones repetibles. Cada caso necesita entrada, salida esperada, salida obtenida y regla; los resultados deben conservarse para detectar regresiones al cambiar la plantilla.
Ejemplo resuelto
Casos: bug→bug, idea→feature, ¿cómo uso esto?→consulta. Si la variante devuelve bug, feature, feature, obtiene 2/3. La evaluación no inventa una cuarta clase ni convierte una respuesta parecida en acierto sin una regla previa.
Pruébalo
Crea seis casos equilibrados.
Define comparación exacta por etiqueta.
Ejecuta dos versiones.
Guarda fila, versión y estado.
Error frecuente: evaluar solo el promedio; corrígelo mostrando resultados por categoría y revisando cada fallo.
Comprueba tu resultado
Con tres casos anteriores, la tasa debe ser 66,7%. Para los tres casos del ejemplo, tu tabla contiene seis filas al probar dos versiones; para los seis casos de la práctica, contiene doce, y cada fila debe conservar la etiqueta esperada.
Etiqueta el fixture que estás contando
Seis casos por dos versiones produce doce ejecuciones, mientras tres por dos produce seis. Cada fila debe conservar caso_id y versión, y la referencia no cambia entre variantes. Incluye salida inválida como fallo y reporta cantidad por categoría. Si el evaluador usa otro modelo como juez, fija sus criterios y revisa una muestra humana: su puntuación no es una verdad automática.
 Mapa de práctica
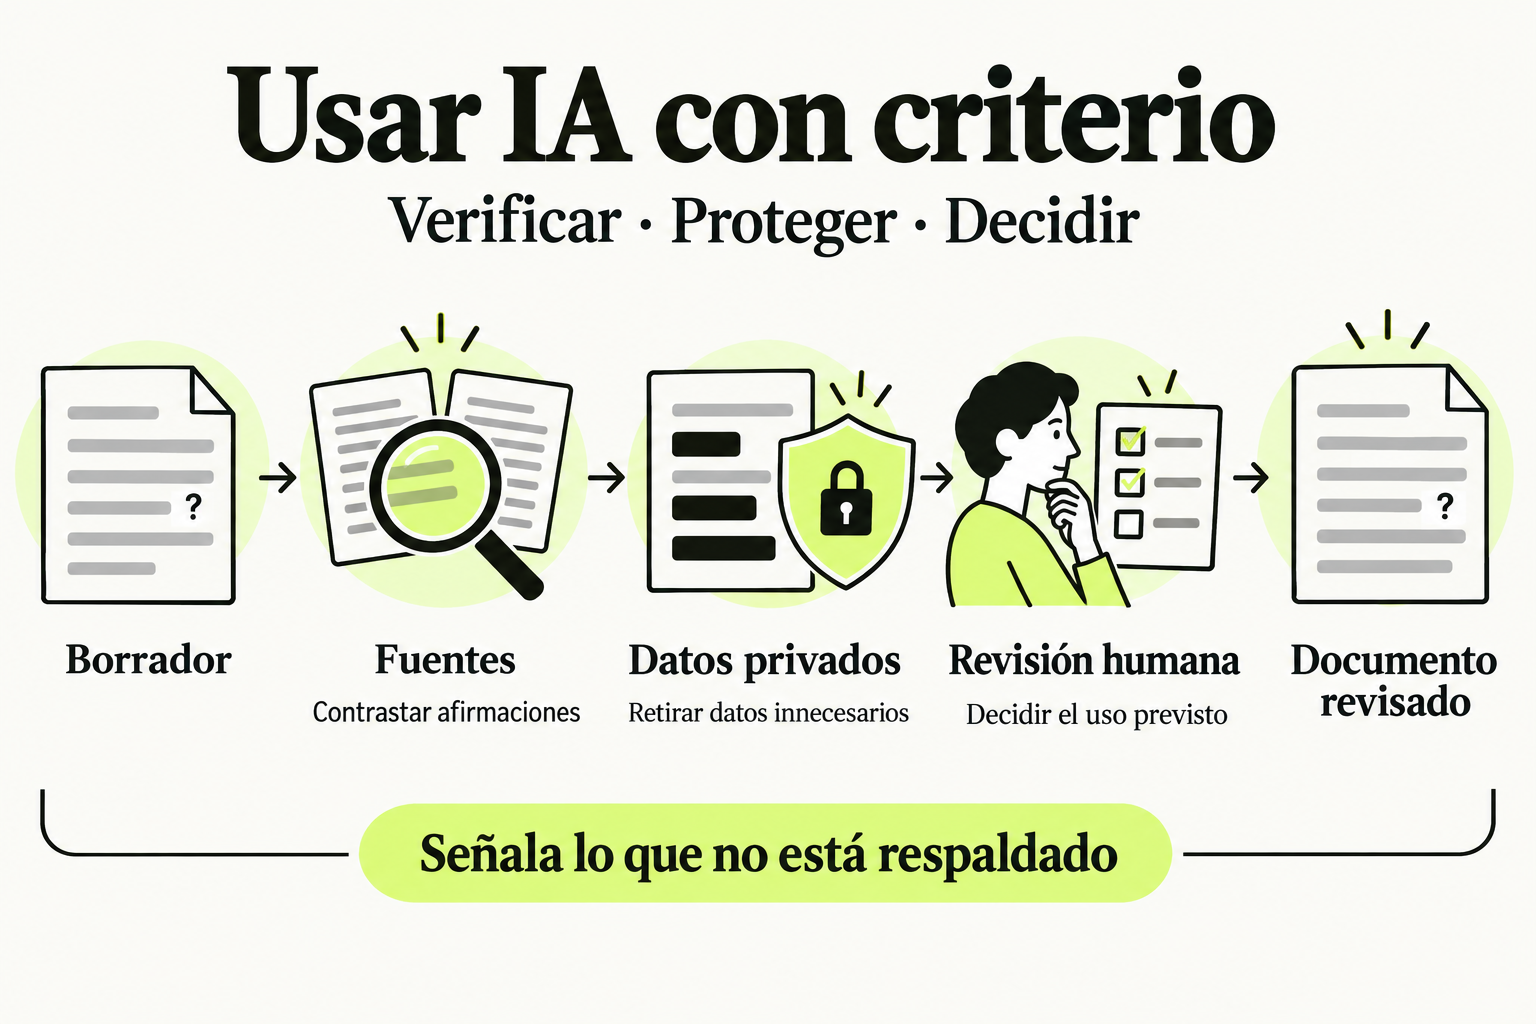
Contrasta las afirmaciones con fuentes y señala lo que no está respaldado. Retira datos privados innecesarios antes de compartir el material. La revisión humana decide si el borrador sirve para su uso previsto y conserva las incertidumbres relevantes.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
La evaluación sistemática de prompts es el proceso de medir cuantitativamente la calidad y consistencia de las instrucciones que envías a modelos como GPT o Claude. Imagina que eres un chef probando recetas: no solo importa que el plato sepa bien una vez, sino que sea reproducible, eficiente en ingredientes y se adapte a diferentes comensales. En producción, un sistema de evaluación te permite comparar versiones de prompts, detectar regresiones y optimizar costos.
La evaluación va más allá de probar manualmente algunos casos. Se basa en métricas objetivas como exactitud, relevancia, latencia y costo por token. Por ejemplo, al refactorizar un prompt para extraer datos de facturas, debes verificar que mantenga >95% de precisión mientras reduce tokens en un 20%. Sin un sistema, estarías "volando a ciegas" en cada despliegue.
Cómo funciona en la práctica
Implementar un sistema de evaluación sigue un flujo estructurado. Primero, defines un conjunto de prueba representativo de casos reales. Para un sistema de clasificación de tickets de soporte, esto incluiría ejemplos de cada categoría (bug, feature request, consulta) con sus respuestas esperadas.
Luego, automatizas la ejecución de prompts contra este conjunto usando la API. Capturas las respuestas y las comparas con las esperadas mediante scripts. Finalmente, generas un reporte con métricas clave. Un paso común es crear un pipeline de CI/CD que ejecute estas pruebas antes de fusionar cambios a producción.
Código en acción
Aquí un ejemplo básico usando Python y la API de OpenAI para evaluar dos versiones de un prompt de resumen:
import openai
import json
from typing import List, Dict

# Configuración
openai.api_key = "tu-api-key"
MODEL = "gpt-4"

def evaluate_prompt(prompt: str, test_cases: List[Dict]) -> Dict:
    """Evalúa un prompt contra casos de prueba."""
    results = {
        "total_cases": len(test_cases),
        "correct": 0,
        "total_tokens": 0,
        "responses": []
    }

    for case in test_cases:
        full_prompt = f"{prompt}\n\nTexto: {case['input']}"

        try:
            response = openai.ChatCompletion.create(
                model=MODEL,
                messages=[{"role": "user", "content": full_prompt}],
                max_tokens=100
            )

            answer = response.choices[0].message.content.strip()
            tokens_used = response.usage.total_tokens

            # Métrica simple: coincidencia exacta con esperado
            is_correct = (answer == case['expected'])

            results["total_tokens"] += tokens_used
            if is_correct:
                results["correct"] += 1
            results["responses"].append({
                "input": case['input'],
                "expected": case['expected'],
                "actual": answer,
                "tokens": tokens_used,
                "correct": is_correct
            })
        except Exception as e:
            print(f"Error en caso {case['input'][:50]}: {e}")

    results["accuracy"] = results["correct"] / results["total_cases"] if results["total_cases"] > 0 else 0
    results["avg_tokens"] = results["total_tokens"] / results["total_cases"] if results["total_cases"] > 0 else 0

    return results

# Casos de prueba para resumen
test_cases = [
    {
        "input": "La reunión de hoy cubrió el lanzamiento del nuevo producto, que estará disponible en junio. El equipo de marketing presentó el plan.",
        "expected": "Lanzamiento de producto en junio; equipo de marketing presentó plan."
    },
    {
        "input": "El informe financiero del Q2 muestra un crecimiento del 15% en ingresos. Las ventas internacionales lideraron con un 25% de aumento.",
        "expected": "Crecimiento del 15% en ingresos en Q2; ventas internacionales subieron 25%."
    }
]

# Prompt original (versión A)
prompt_a = "Resume el siguiente texto en una oración concisa:"

# Prompt optimizado (versión B)
prompt_b = "Extrae los puntos clave del texto y preséntalos en una frase breve. Ignora detalles menores:"

print("Evaluando Prompt A:")
results_a = evaluate_prompt(prompt_a, test_cases)
print(f"Precisión: {results_a['accuracy']:.2%}, Tokens promedio: {results_a['avg_tokens']:.1f}")

print("\nEvaluando Prompt B:")
results_b = evaluate_prompt(prompt_b, test_cases)
print(f"Precisión: {results_b['accuracy']:.2%}, Tokens promedio: {results_b['avg_tokens']:.1f}")
Refactorización para mejor escalabilidad. El código anterior es básico; en producción, añadirías manejo de errores, logging y métricas avanzadas:
class PromptEvaluator:
    """Clase para evaluación robusta de prompts."""

    def __init__(self, api_key: str, model: str = "gpt-4"):
        self.client = openai.OpenAI(api_key=api_key)
        self.model = model

    def run_evaluation(self, prompt: str, test_cases: List[Dict],
                       metrics: List[str] = ["accuracy", "token_efficiency"]) -> Dict:
        """Ejecuta evaluación con métricas configurables."""
        # Implementación extendida con métricas personalizadas
        # Ejemplo: token_efficiency = (precisión * 100) / tokens_promedio
        pass

# Uso mejorado
evaluator = PromptEvaluator(api_key="tu-api-key")
# Cargar casos desde JSON
with open("test_cases.json", "r") as f:
    test_suite = json.load(f)

report = evaluator.run_evaluation(prompt_b, test_suite)
print(json.dumps(report, indent=2))
Errores comunes
- Conjunto de prueba no representativo: Usar solo ejemplos fáciles que no reflejan casos reales. Solución: Incluye casos límite y variados; actualiza periódicamente.
- Evaluar solo una métrica: Enfocarse solo en precisión ignorando costo o latencia. Solución: Define un score compuesto (ej: 70% precisión, 30% eficiencia).
- No automatizar: Hacer pruebas manuales que no escalan. Solución: Integra en pipeline CI/CD con herramientas como GitHub Actions.
- Ignorar la variabilidad: Asumir que el modelo siempre responde igual. Solución: Ejecuta cada caso múltiples veces y calcula desviación estándar.
- Falta de baseline: Comparar prompts sin una línea base inicial. Solución: Guarda resultados del prompt actual como referencia para mejoras.
Checklist de dominio
- Tengo un conjunto de prueba con al menos 20 casos representativos de mi dominio.
- He definido 3+ métricas clave (ej: precisión, tokens/prompt, satisfacción del usuario).
- Automaticé la ejecución de evaluaciones con scripts reutilizables.
- Comparé al menos dos versiones de un prompt usando datos cuantitativos.
- Documenté los criterios de aceptación para cambios en prompts (ej: +5% precisión, -10% tokens).
- Integré la evaluación en mi flujo de desarrollo (ej: pre-commit hooks o CI).
- Establecí un proceso para revisar y expandir el conjunto de prueba cada mes.
Implementa un sistema de evaluación para prompts de clasificación
En este ejercicio, crearás un sistema para evaluar prompts que clasifiquen consultas de usuarios en categorías. Sigue estos pasos:
- Prepara el entorno: Crea un proyecto Python con las librerías
openaiypytest. Configura tu API key en una variable de entorno. - Define casos de prueba: En un archivo JSON, define 10 consultas de ejemplo con su categoría esperada (ej: "soporte_técnico", "facturación", "ventas"). Incluye 2-3 casos ambiguos.
- Implementa la función de evaluación: Escribe una función que tome un prompt y el archivo JSON, ejecute cada caso mediante la API, y calcule:
- Precisión (respuestas correctas / total)
- Tokens promedio por consulta
- Tiempo promedio de respuesta
- Compara dos prompts: Crea dos versiones de un prompt de clasificación (ej: uno breve y uno detallado con ejemplos). Ejecuta la evaluación para ambos y genera un reporte comparativo.
- Automatiza: Configura un script que ejecute esta evaluación al hacer
python evaluate.pyy muestre los resultados en formato tabla.
Entrega: Código Python, archivo JSON de casos, y un README con instrucciones de ejecución.
Pistas
- Usa
time.time()para medir latencia de cada llamada a la API. - Para casos ambiguos, considera usar coincidencia parcial (ej: si la respuesta contiene la categoría esperada).
- Guarda los resultados en un archivo CSV para análisis posterior.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.