

Lección 12 de 20 · Lectura y práctica
Monitoreo y logging de interacciones con APIs
Concepto claveEl monitoreo y logging de interacciones con APIs de IA es el proceso sistemático de registrar, analizar y supervisar todas las solicitudes y respuestas entre tu aplicación y modelos como GPT o Claude. Imagina que.
Del concepto a la práctica
Taller de esta lección
Un log útil permite explicar qué ocurrió sin almacenar más datos de los necesarios. Registra identificador, versión, tiempos, tamaños, estado y error resumido; omite claves y redacta el contenido sensible antes de persistirlo.
Ejemplo resuelto
Evento: {"id":"r17","version":"v2","latencia_ms":640,"entrada_tokens":90,"salida_tokens":24,"estado":"ok"}. El análisis puede calcular latencia media y tokens sin guardar el mensaje original. Un fallo registra estado:"error" y una categoría, no una credencial.
Pruébalo
Define el esquema mínimo.
Genera dos eventos correctos y uno fallido.
Calcula media solo sobre los correctos.
Busca patrones por versión.
Error frecuente: imprimir el prompt completo con datos personales; corrígelo usando identificadores y redacción previa.
Comprueba tu resultado
Debe haber tres eventos, ninguno con una clave o texto sensible. La latencia media se calcula con los dos estados ok, y el fallo queda visible sin alterar esa media.
Incluye errores en otra métrica
Usa r17=640 ms ok, r18=760 ms ok y r19=900 ms error. Media de éxitos=(640+760)/2=700 ms; tasa de error=1/3; media de todas=(640+760+900)/3=766,67 ms. Etiqueta qué conjunto mides para no esconder fallos rápidos o lentos. Registra hit/miss y tiempo de servicio separados del tiempo de proveedor; una respuesta en caché no consume necesariamente otra llamada. Un hash de texto personal tampoco vuelve anónimo automáticamente el registro.
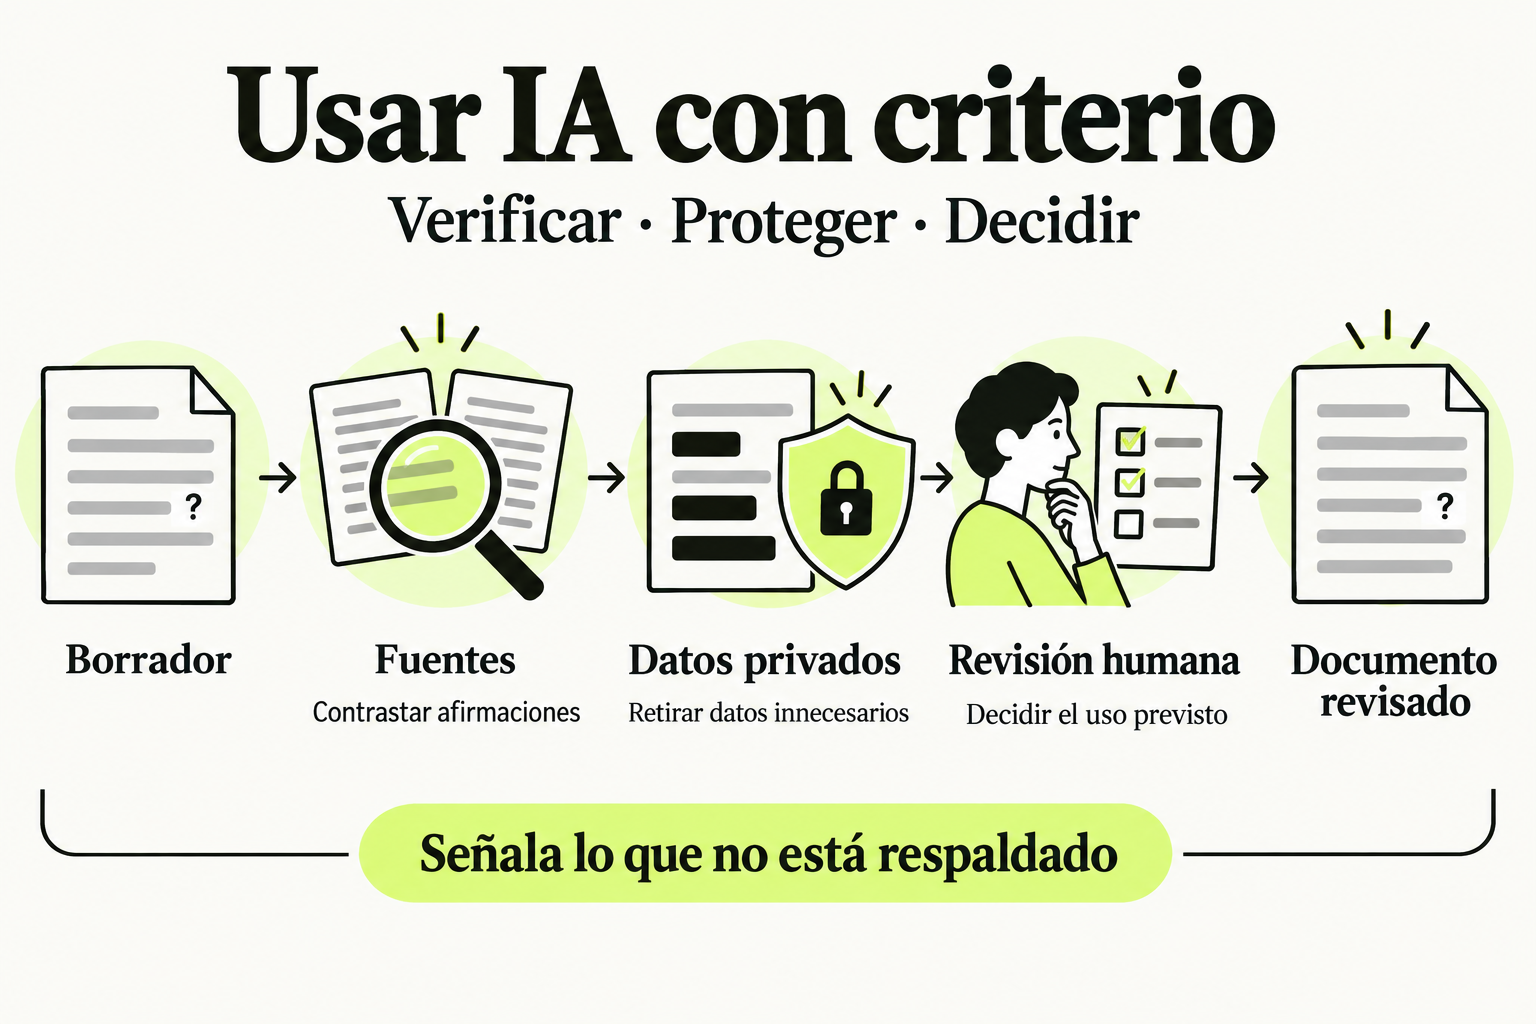
 Mapa de práctica
Contrasta las afirmaciones con fuentes y señala lo que no está respaldado. Retira datos privados innecesarios antes de compartir el material. La revisión humana decide si el borrador sirve para su uso previsto y conserva las incertidumbres relevantes.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
El monitoreo y logging de interacciones con APIs de IA es el proceso sistemático de registrar, analizar y supervisar todas las solicitudes y respuestas entre tu aplicación y modelos como GPT o Claude. Imagina que eres el director de una obra de teatro: necesitas ver qué actores (prompts) funcionan mejor, cuándo fallan las escenas (errores), y cómo reacciona el público (usuarios) para mejorar continuamente la función.
En producción, esto va más allá de simplemente guardar logs. Se trata de crear un sistema de telemetría que capture métricas clave como latencia, costos, calidad de respuestas, y patrones de uso. Es similar a cómo un hospital monitorea signos vitales: no solo registra la temperatura, sino que analiza tendencias para prevenir problemas antes de que ocurran.
Cómo funciona en la práctica
Un sistema robusto de logging sigue estos pasos:
- Interceptación: Captura cada solicitud y respuesta antes/durante/después del envío a la API.
- Enriquecimiento: Añade metadatos como timestamp, usuario, versión del prompt, y contexto de la aplicación.
- Almacenamiento: Guarda en una base de datos estructurada (no solo archivos de texto) para análisis posterior.
- Análisis: Procesa los datos para identificar patrones, anomalías, y oportunidades de optimización.
Ejemplo: Una aplicación de soporte al cliente que usa Claude para responder consultas. Sin logging, solo sabes si falló o no. Con logging estructurado, puedes ver que las preguntas sobre "facturación" tienen un 40% más de latencia, o que cierto prompt genera respuestas confusas los lunes por la mañana.
Código en acción
Implementación básica con decorador en Python:
import json
import time
from functools import wraps
from datetime import datetime

class APILogger:
    def __init__(self, storage_backend="database"):
        self.storage_backend = storage_backend

    def log_interaction(self, prompt, response, metadata=None):
        log_entry = {
            "timestamp": datetime.utcnow().isoformat(),
            "prompt": prompt,
            "response": response,
            "metadata": metadata or {},
            "latency": self._calculate_latency()
        }
        # En producción, aquí guardarías en DB/Elasticsearch/etc
        print(f"[LOG] {json.dumps(log_entry, ensure_ascii=False)}")
        return log_entry

    def _calculate_latency(self):
        # Método simplificado
        return time.time() - getattr(self, '_start_time', time.time())

def log_api_call(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        logger = APILogger()
        logger._start_time = time.time()

        # Capturar prompt original
        prompt = kwargs.get('prompt') or (args[0] if args else "")

        try:
            response = func(*args, **kwargs)
            logger.log_interaction(
                prompt=prompt,
                response=response,
                metadata={
                    "function": func.__name__,
                    "status": "success"
                }
            )
            return response
        except Exception as e:
            logger.log_interaction(
                prompt=prompt,
                response=str(e),
                metadata={
                    "function": func.__name__,
                    "status": "error",
                    "error_type": type(e).__name__
                }
            )
            raise
    return wrapper

# Uso
@log_api_call
def call_gpt_api(prompt, model="gpt-4"):
    # Simulación de llamada a API
    return f"Respuesta simulada para: {prompt}"

# Test
result = call_gpt_api("¿Cómo optimizar prompts?")
print(f"Resultado: {result}")
Mejora con estructura para producción:
import structlog
from openai import OpenAI
from contextlib import contextmanager

# Configuración profesional con structlog
logger = structlog.get_logger()

class ProductionAPIMonitor:
    def __init__(self, api_client):
        self.client = api_client
        self.metrics = {
            "total_calls": 0,
            "errors": 0,
            "avg_latency": 0
        }

    @contextmanager
    def track_call(self, prompt_data):
        """Context manager para monitoreo completo"""
        start_time = time.time()
        call_id = f"call_{self.metrics['total_calls']}"

        try:
            logger.info("api_call_start",
                       call_id=call_id,
                       prompt_hash=hash(prompt_data[:100]),  # No loguear datos sensibles completos
                       model="gpt-4")

            yield  # Aquí ocurre la llamada real a la API

            latency = time.time() - start_time
            self.metrics['total_calls'] += 1
            self.metrics['avg_latency'] = (
                (self.metrics['avg_latency'] * (self.metrics['total_calls'] - 1) + latency)
                / self.metrics['total_calls']
            )

            logger.info("api_call_success",
                       call_id=call_id,
                       latency_ms=round(latency * 1000, 2),
                       cost_estimate=self._estimate_cost(prompt_data))

        except Exception as e:
            self.metrics['errors'] += 1
            logger.error("api_call_failed",
                        call_id=call_id,
                        error=str(e),
                        prompt_preview=prompt_data[:50])
            raise

    def _estimate_cost(self, prompt):
        # Estimación básica basada en tokens
        return len(prompt) / 4 * 0.00003  # Aproximación para GPT-4

# Uso en producción
client = OpenAI(api_key="tu_key")
monitor = ProductionAPIMonitor(client)

with monitor.track_call("Prompt de ejemplo para logging"):
    # Llamada real a la API
    response = client.chat.completions.create(
        model="gpt-4",
        messages=[{"role": "user", "content": "Prompt de ejemplo"}]
    )
    print(f"Respuesta: {response.choices[0].message.content}")

print(f"Métricas: {monitor.metrics}")
Errores comunes
- Loggear datos sensibles completos: Nunca guardes prompts con información personal (PII) en logs. Usa hashing o truncamiento. Solución:
prompt_hash = hash(prompt[:100])y guarda solo el hash. - Logs no estructurados: Usar
print()o archivos de texto plano hace imposible el análisis. Solución: Usa JSON estructurado y bases de datos como Elasticsearch. - Falta de contexto: Loggear solo el prompt y respuesta sin metadatos. Solución: Añade siempre user_id, session_id, timestamp, versión de la aplicación.
- Ignorar métricas de negocio: Solo medir latencia técnica. Solución: Añade métricas como "satisfacción del usuario" (thumbs up/down) o "resolución en primer intento".
- No planificar la retención: Guardar todo para siempre es caro e inútil. Solución: Define políticas (ej: 30 días para logs detallados, 1 año para agregados).
Checklist de dominio
- ¿Tu sistema captura automáticamente cada interacción con la API, incluyendo fallos?
- ¿Los logs incluyen metadatos suficientes para reproducir y depurar problemas?
- ¿Tienes alertas configuradas para latencia anómala o tasa de errores elevada?
- ¿Puedes identificar qué prompts tienen mejor/peor rendimiento en coste-calidad?
- ¿Tu almacenamiento de logs escala con el crecimiento del tráfico?
- ¿Cumples con regulaciones de privacidad (GDPR, etc.) en tu logging?
- ¿Tienes dashboards para visualizar métricas clave en tiempo real?
Implementa un sistema de logging para optimización de prompts
En este ejercicio, crearás un sistema de logging que te permita identificar oportunidades de optimización de prompts en producción.
- Configura el entorno:
- Crea un proyecto Python nuevo con virtualenv
- Instala dependencias:
pip install openai structlog python-dotenv - Configura tu API key en un archivo .env
- Implementa el logger básico:
- Crea una clase
PromptOptimizationLoggerque herede del ejemplo de la lección - Añade un método
log_quality_score()que permita a los usuarios calificar respuestas (1-5) - Guarda los logs en un archivo JSON estructurado
- Crea una clase
- Agrega análisis automático:
- Implementa una función que analice los logs semanalmente
- Identifica automáticamente los 3 prompts con peor calificación promedio
- Calcula el costo promedio por prompt categorizado por tema (usa keywords simples)
- Crea un dashboard simple:
- Genera un archivo HTML que muestre:
- Top 5 prompts más caros
- Top 5 prompts con mejor/peor calificación
- Evolución del costo promedio por semana
- Usa tablas HTML básicas, no necesitas JavaScript
- Genera un archivo HTML que muestre:
- Prueba con datos reales:
- Simula 50 llamadas a API con diferentes prompts
- Asigna calificaciones aleatorias (pero consistentes con patrones)
- Verifica que tu análisis identifique correctamente los problemas
Entregable: Código Python completo + archivo HTML del dashboard + informe de análisis de 1 página con recomendaciones de optimización basadas en tus logs.
Pistas
- Usa el patrón de decorator para no modificar tu código de llamadas a API existente
- Para análisis de temas, extrae las primeras 3-5 palabras clave del prompt con split() simple
- Guarda los logs con rotación diaria para no sobrecargar archivos
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.