

Lección 11 de 20 · Lectura y práctica
Estrategias de caching y reutilización de prompts
Concepto claveEl caching de prompts es una técnica que almacena respuestas previamente generadas por modelos de lenguaje para reutilizarlas en solicitudes idénticas o similares, similar a cómo un navegador web guarda en caché.
Del concepto a la práctica
Taller de esta lección
Una caché segura requiere una identidad completa de solicitud. La clave debe incluir versión de plantilla, modelo lógico, idioma y entrada normalizada; de lo contrario una respuesta antigua puede parecer válida para otra configuración.
Ejemplo resuelto
Para plantilla clasifica-v2, idioma es y texto normalizado llegó tarde, la clave conceptual es clasifica-v2|modelo-demo|es|llegó tarde. Si cambia a v3, la clave cambia aunque el texto sea igual. Un diccionario local puede simular el comportamiento.
Pruébalo
Normaliza espacios y minúsculas.
Construye la clave con cuatro componentes.
Guarda una respuesta y repite la consulta.
Cambia idioma o versión y verifica un fallo de caché.
Error frecuente: usar solo el texto como clave; corrígelo incorporando toda variable que altere la salida.
Comprueba tu resultado
La segunda consulta idéntica debe ser hit. Cambiar es por en o v2 por v3 debe producir miss; ninguna respuesta debe mezclarse entre versiones.
Caché de respuestas y caché de prefijos
La caché del ejemplo guarda una respuesta de tu aplicación. La caché de prompts del proveedor reutiliza cómputo de un prefijo y no promete una respuesta idéntica. Para una respuesta añade esquema, parámetros relevantes, contexto recuperado/versiones y ámbito autorizado de usuario o tenant a una clave serializada sin colisiones. No conviertas a minúsculas textos donde la capitalización cambie significado, ni elimines espacios relevantes de código. Define TTL y evita guardar respuestas rechazadas. Un hit de otra persona no puede saltarse la autorización.
 Mapa de práctica
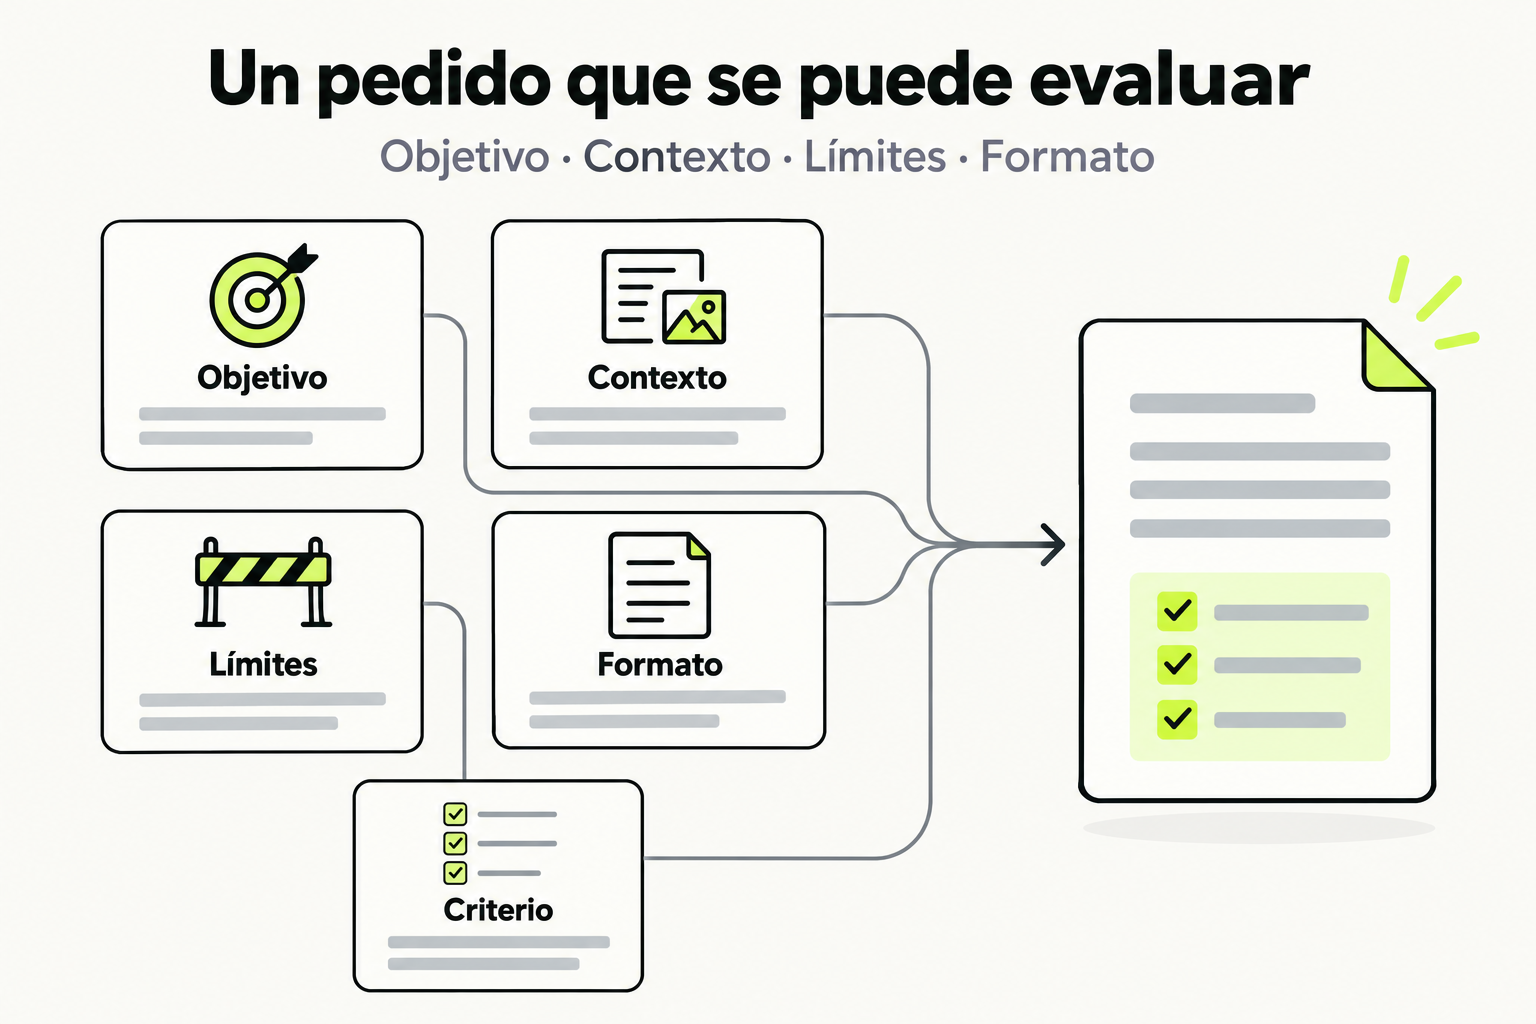
Un pedido útil explica qué resultado se busca y aporta el contexto necesario. Los límites y el formato reducen ambigüedades. Un criterio observable permite revisar el resultado y pedir un ajuste concreto.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
El caching de prompts es una técnica que almacena respuestas previamente generadas por modelos de lenguaje para reutilizarlas en solicitudes idénticas o similares, similar a cómo un navegador web guarda en caché imágenes y páginas para cargarlas más rápido en visitas repetidas. En sistemas de producción, esto reduce costos de API, mejora la latencia y aumenta la consistencia de las respuestas.
La reutilización de prompts va más allá del simple almacenamiento en caché: implica diseñar prompts modulares y parametrizados que puedan adaptarse a diferentes contextos sin necesidad de reescribirlos desde cero. Piensa en esto como tener plantillas de correo electrónico que personalizas con variables específicas para cada destinatario, manteniendo la estructura base intacta.
Cómo funciona en la práctica
Imagina que desarrollas un asistente de soporte técnico que responde preguntas frecuentes. Sin caching, cada usuario que pregunta "¿Cómo restablezco mi contraseña?" genera una nueva llamada a la API, incurriendo en costos y latencia. Con caching, la primera respuesta se almacena y se sirve instantáneamente a usuarios posteriores.
Paso a paso:
- Un usuario envía un prompt (ejemplo: "Explica el proceso de restablecimiento de contraseña paso a paso").
- El sistema calcula un hash único del prompt (usando SHA-256 o similar).
- Verifica si el hash existe en la caché (Redis, Memcached, o base de datos).
- Si existe, devuelve la respuesta almacenada; si no, llama a la API, almacena la respuesta con el hash y luego la devuelve.
- Para prompts parametrizados, se normalizan variables (ejemplo: reemplazar nombres de usuarios con placeholders) antes de hashear.
Código en acción
Ejemplo de implementación básica de caching con Python y Redis:
import hashlib
import json
import redis
from openai import OpenAI

# Configuración
client = OpenAI(api_key="tu_api_key")
redis_client = redis.Redis(host='localhost', port=6379, db=0)

def get_cached_response(prompt, model="gpt-4"):
    # Crear hash único del prompt
    prompt_hash = hashlib.sha256(prompt.encode()).hexdigest()
    cache_key = f"prompt_cache:{model}:{prompt_hash}"

    # Intentar obtener de caché
    cached_response = redis_client.get(cache_key)
    if cached_response:
        return json.loads(cached_response)

    # Llamar a la API si no está en caché
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}]
    )
    result = response.choices[0].message.content

    # Almacenar en caché con TTL de 1 hora
    redis_client.setex(cache_key, 3600, json.dumps(result))
    return result

# Uso
prompt = "Explica la teoría de la relatividad en términos simples"
response = get_cached_response(prompt)
print(response)
Ejemplo de prompt reutilizable con parametrización:
# Antes: Prompt estático y repetitivo
def generate_welcome_email(name):
    prompt = f"Escribe un correo de bienvenida para {name} que sea cálido y profesional"
    # Llamada a API cada vez
    return call_api(prompt)

# Después: Prompt modular reutilizable
template = """Escribe un correo de bienvenida para {nombre} que sea cálido y profesional.
Incluye:
- Saludo personalizado
- Breve introducción a nuestros servicios
- Próximos pasos sugeridos
- Firma del equipo"""

def generate_welcome_email_optimized(name):
    prompt = template.format(nombre=name)
    # Puede usar caching con hash normalizado
    normalized_prompt = template.format(nombre="{nombre}")
    return get_cached_response(normalized_prompt, context={"nombre": name})
Errores comunes
- Cachear prompts con datos sensibles: Almacenar prompts que incluyen información personal (ejemplo: "Resume el historial médico de Juan Pérez") puede violar regulaciones como GDPR. Solución: Normalizar prompts reemplazando datos sensibles con placeholders antes de hashear.
- TTL (Time To Live) infinito: No establecer expiración en caché puede servir respuestas obsoletas si la información base cambia. Solución: Definir TTL basado en la volatilidad de los datos (ejemplo: 1 hora para FAQs, 24 horas para contenido estático).
- Ignorar el contexto: Cachear prompts idénticos sin considerar diferencias en contexto (ejemplo: mismo prompt en español vs. inglés) lleva a respuestas incorrectas. Solución: Incluir metadatos como idioma o versión del modelo en la clave de caché.
- Sobrecarga por granularidad excesiva: Crear cachés separadas para variaciones mínimas (ejemplo: "Hola" vs "Hola!") reduce la eficiencia. Solución: Normalizar prompts eliminando espacios extras y puntuación irrelevante antes de hashear.
Checklist de dominio
- ¿Implementas hashing de prompts para claves de caché únicas y eficientes?
- ¿Utilizas un sistema de almacenamiento en caché escalable como Redis o Memcached?
- ¿Defines TTL apropiados basados en la frecuencia de actualización del contenido?
- ¿Normalizas prompts para manejar variaciones menores y datos sensibles?
- ¿Diseñas prompts modulares con parámetros para maximizar reutilización?
- ¿Monitoreas hit rates de caché para ajustar estrategias?
- ¿Validas que las respuestas cacheadas sigan siendo relevantes ante cambios en el modelo o datos?
Implementa un sistema de caching con prompts parametrizados
En este ejercicio, crearás un sistema que cachea respuestas de GPT para prompts de recomendación de productos, optimizando para reutilización con diferentes parámetros.
- Configura el entorno: Instala las bibliotecas necesarias:
openai,redis(o usa un cliente en memoria como diccionario para simulación), yhashlib. - Crea una función de caching: Implementa una función similar a
get_cached_responsedel ejemplo, pero que normalice prompts reemplazando nombres de productos y categorías con placeholders antes de hashear (ejemplo: cambiar "recomienda laptops gaming" a "recomienda {producto} {categoría}"). - Diseña un prompt parametrizado: Crea una plantilla para recomendaciones que acepte parámetros como tipo de producto, presupuesto y características. Ejemplo: "Recomienda {producto} para {uso} con un presupuesto de {presupuesto}. Incluye 3 opciones."
- Implementa la lógica de reutilización: Escribe código que use la plantilla para generar prompts, aplique normalización, verifique caché, y llame a la API solo si es necesario. Almacena respuestas con un TTL de 30 minutos.
- Prueba con datos variados: Ejecuta solicitudes con diferentes parámetros (ejemplo: producto="laptop", uso="gaming", presupuesto="1000 USD") y verifica que el caching funcione para prompts normalizados similares.
Pistas
- Usa expresiones regulares o métodos de string para reemplazar valores dinámicos con placeholders durante la normalización.
- Considera incluir el modelo de lenguaje (ejemplo: gpt-4) en la clave de caché para evitar mezclar respuestas de diferentes versiones.
- Para simular Redis, puedes usar un diccionario Python con expiración manual basada en timestamps.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.