

Machine Learning Práctico con Scikit-Learn
Domina Scikit-Learn desde técnicas avanzadas de preprocesamiento hasta modelos ensemble y optimización de hiperparámetros. Aprende a construir pipelines completos y resolver problemas reales de machine learning. Es un curso en español con 4 módulos y 16 lecciones. Puedes revisar el temario completo antes de elegir entre la compra individual y la matrícula al catálogo.
Responsable de formación: Gerardo Salazar, product builder e ingeniero de software.
Toda la escuela: US$100 en un solo pago, sin suscripción ni renovaciones. Incluye los 132 cursos y los futuros. También seis cuotas mensuales de US$20 (US$120 en total) o compra individual. Elige la opción que te venga mejor.
Aprende con un caso concreto
Lo que vas a poner en práctica
- Construir pipelines reproducibles con transformaciones numéricas y categóricas sin fuga de información.
- Comparar ensembles y búsquedas de hiperparámetros mediante particiones, métricas y presupuestos explícitos.
- Seleccionar, transformar y evaluar características considerando interpretabilidad, desbalance y generalización.
- Completar un sistema de predicción de churn con informe técnico y criterios de selección verificables.
Este curso sigue un caso conductor: construir, revisar y justificar un sistema de predicción de churn para una empresa ficticia de suscripciones. No se trata de ejecutar una búsqueda de modelos sin contexto, sino de mantener un contrato reproducible desde la tabla inicial hasta la decisión final. El recorrido comienza con pipelines y preprocesamiento porque cualquier comparación posterior pierde valor si las imputaciones, escalas o codificaciones se ajustan usando información de evaluación.
En el primer módulo trabajarás con ColumnTransformer, ramas de transformación y validación cruzada. Aprenderás a separar columnas numéricas y categóricas, encapsular reglas reutilizables y elegir una estrategia de partición coherente con el problema. La lección de evaluación comprueba si puedes detectar fuga de información, distinguir validación de prueba y justificar una métrica.
El segundo módulo estudia ensembles. Random Forest y Extra Trees permiten comparar aleatoriedad y complejidad bajo un protocolo común. Después revisarás el principio de gradient boosting y las diferencias de tratamiento que pueden existir entre implementaciones. La optimización de hiperparámetros se plantea como un presupuesto experimental: defines una métrica, un espacio y una validación antes de interpretar el mejor resultado. La evaluación exige leer configuraciones y resultados, no memorizar nombres.
El tercer módulo se concentra en la representación de los datos. Compararás métodos filter, wrapper y embedded atendiendo a cuándo se seleccionan las variables y qué riesgo de fuga introducen. PCA se estudiará como transformación lineal ajustable, mientras que t-SNE y UMAP se tratarán como herramientas de exploración visual, no como pruebas automáticas de calidad predictiva. También medirás el efecto del desbalance con matrices de confusión, recall y precisión de la clase minoritaria, aplicando muestreo únicamente dentro del entrenamiento.
El proyecto integrador reúne estas decisiones. Primero definirás churn, fecha de corte, unidad de observación y ventana de resultado. Luego auditarás duplicados, nulos, clases y variables que solo aparecen después del corte. Construirás un pipeline completo, compararás una referencia sencilla con modelos más complejos y reservarás una evaluación final que no participe en la selección. La interpretación deberá distinguir rendimiento observado de capacidad esperada fuera de la muestra.
El trabajo final consiste en un informe y un artefacto reproducible para un conjunto ficticio de cuentas. Debe incluir el diccionario de datos, la partición, el pipeline, la configuración de búsqueda, una tabla de métricas y la elección razonada del modelo. No basta con presentar el porcentaje mayor: tendrás que explicar el coste de falsos negativos, el efecto de la clase minoritaria, el tiempo de entrenamiento y las limitaciones del experimento.
Comprobarás tu progreso mediante salidas verificables. Cada lección pide una pequeña transformación, cálculo, comparación o decisión que pueda revisarse con los datos aportados. En el examen final deberás identificar fugas, reconstruir el orden correcto de un flujo y defender una selección usando evidencia. El criterio central es la trazabilidad: otra persona debe poder repetir tus pasos, obtener resultados compatibles y saber qué parte sigue siendo una hipótesis que requiere nueva evaluación.
 Mapa de práctica
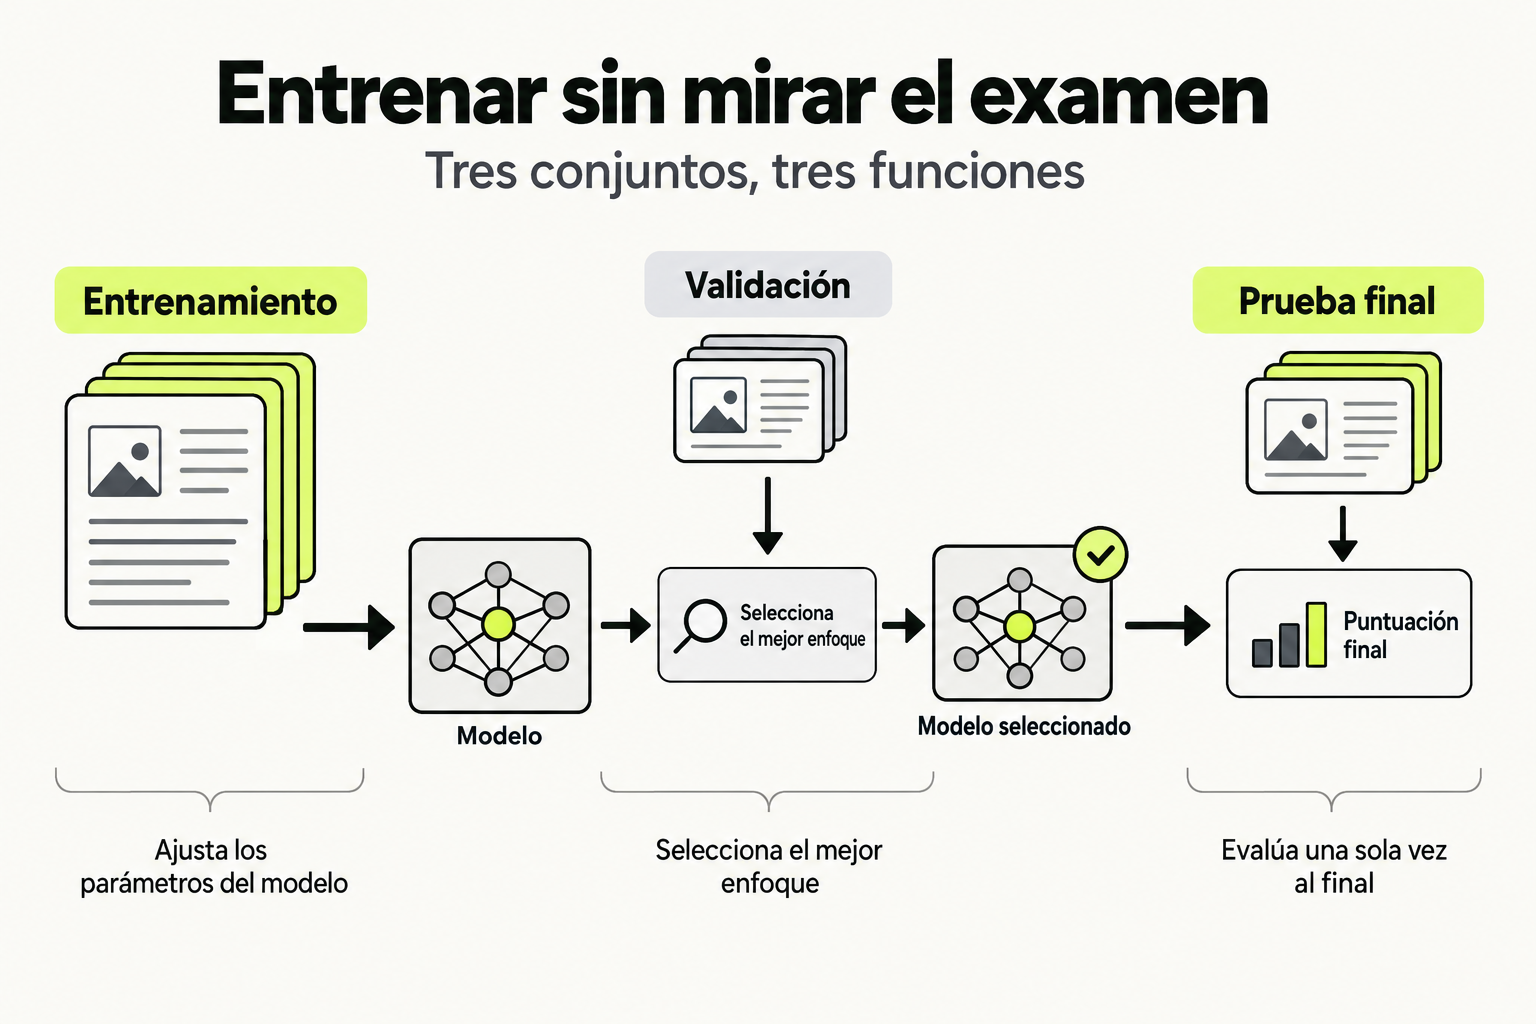
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Proyecto final
Sistema reproducible de predicción de churn
Construye un flujo local para estimar si una cuenta no renovará durante los 30 días posteriores a una fecha de corte ficticia. Define el objetivo sin usar información futura, prepara variables dentro de un pipeline, compara una referencia con al menos dos modelos y selecciona una configuración usando una validación documentada.
Qué entregar
- Diccionario de datos con unidad de observación, fecha de corte, etiqueta y exclusiones.
- Código reproducible del pipeline y de la búsqueda de hiperparámetros.
- Tabla con particiones, métricas, matriz de confusión y tiempo de entrenamiento.
- Informe breve con limitaciones, decisión final y comprobaciones contra fuga de información.
Cómo comprobarlo
- La etiqueta y las variables respetan la ventana temporal definida.
- Las transformaciones se ajustan solo dentro de los datos de entrenamiento de cada partición.
- La comparación usa la misma métrica, separación y clase positiva para todos los modelos.
- La elección final considera errores, desbalance, complejidad y evidencia reproducible.
Fuentes para profundizar
Temario completo
16 lecciones
Vista previa del programa. Las clases se desbloquean al comprar el curso o con la matrícula.
Fundamentos Avanzados de Pipelines y Preprocesamiento
- Pipeline API Avanzada con ColumnTransformer
- Transformadores Personalizados y FeatureUnions
- Estrategias Avanzadas de Validación Cruzada
- Evaluación de Conocimiento: Pipelines y Preprocesamiento
Algoritmos Ensemble y Optimización de Hiperparámetros
- Random Forest y Extra Trees en Profundidad
- Gradient Boosting: XGBoost, LightGBM y CatBoost
- Búsqueda de Hiperparámetros: GridSearchCV, RandomizedSearchCV y Optuna
- Evaluación de Conocimiento: Algoritmos Ensemble
Feature Engineering Avanzado y Selección de Modelos
- Selección de Características: Filter, Wrapper y Embedded Methods
- Reducción de Dimensionalidad: PCA, t-SNE y UMAP
- Manejo de Datos Desbalanceados y Técnicas de Samplinge
- Evaluación de Conocimiento: Feature Engineering
Proyecto Integrador: Sistema de Predicción de Churn
- Análisis Exploratorio y Preparación de Datos para Churn
- Construcción de Pipeline Completo con Optimización
- Evaluación de Modelos y Selección Final
- Examen Final: Proyecto Integrador de Machine Learning
Por qué Cursalo
APLICA
Aprende haciendo
Cada lección convierte una explicación concreta en una tarea útil que puedes repetir.
TU RITMO
Avanza sin presión
Tu progreso queda guardado para continuar exactamente desde donde lo dejaste.
APOYO
Todo en un mismo lugar
Lecciones, prompts, materiales y tutor con IA reunidos para ayudarte mientras practicas.
Lecturas del programa
Explora estas lecciones públicas y vuelve al curso para consultar las opciones de acceso y guardar tu progreso.
Preguntas frecuentes
¿Cómo accedo al curso Machine Learning Práctico con Scikit-Learn?
Puedes adquirir el curso Machine Learning Práctico con Scikit-Learn con una compra única y conservar el acceso a ese curso, o acceder al catálogo con una membresía mensual, anual o de por vida, según las condiciones de cada plan. Consulta las condiciones y los precios actualizados en /precios.
¿Qué incluye Machine Learning Práctico con Scikit-Learn?
Es un curso completo en español con 4 módulos y 16 lecciones. El temario público muestra cada lección; los materiales adicionales se identifican dentro del curso cuando están disponibles.
¿Necesito conocimientos previos para hacer Machine Learning Práctico con Scikit-Learn?
Revisa el temario público para comprobar el punto de partida y la progresión de Machine Learning Práctico con Scikit-Learn. Puedes avanzar a tu ritmo desde el panel y volver a la última lección visitada.
¿El curso Machine Learning Práctico con Scikit-Learn entrega certificado?
Las rutas certificables permiten emitir un certificado de finalización cuando completas sus requisitos y tienes el acceso correspondiente. Cada certificado emitido cuenta con una página pública de verificación.
¿En qué idioma está y para qué países sirve?
Está en español y se estudia online. Puedes acceder desde Latinoamérica, España u otro país con conexión a internet; el checkout muestra los importes en USD.
¿Qué formato tiene el curso?
El formato actual es lectura y práctica. Consulta las lecciones y sus recursos; no se ofrece como un curso completo de video.
¿Puedo revisar el programa antes de pagar?
Sí. El temario y esta ficha son públicos. Compara el contenido y los requisitos con tu objetivo antes de elegir una compra individual o un acceso a toda la escuela en /precios.
Reseñas de estudiantes
Reseñas de estudiantes
Otros cursos de IA
Ver todo el catálogo →- Accesibilidad Web (WCAG)Aprende a crear sitios web accesibles para todas las personas. Estándares WCAG 2.2, herramientas de auditoría, HTML semántico, ARIA, contraste de colores y navegación por teclado.
- Arquitectura de Micro-frontends con Module Federation de WebpackEste curso avanzado te guiará en el diseño e implementación de arquitecturas de micro-frontends utilizando Module Federation de Webpack. Aprenderás a desplegar aplicaciones frontend distribuidas entre equipos, optimizando la colaboración y escalabilidad. Cada módulo incluye ejercicios prácticos para construir componentes.
- Automatización con Make: conecta tus apps sin códigoAprende a crear flujos de trabajo automáticos potentes conectando tus aplicaciones favoritas sin escribir código. Este curso intermedio te guiará desde los patrones de automatización esenciales hasta escenarios avanzados con lógica condicional y manejo de errores.
- Automatización de Procesos con PythonAprende a optimizar tu productividad automatizando tareas repetitivas con Python. Domina herramientas para manipular archivos, interactuar con APIs web y programar ejecuciones automáticas que te ahorrarán horas de trabajo.