

Lección 5 de 16 · Lectura y práctica
Random Forest y Extra Trees en Profundidad
Compara Random Forest y Extra Trees controlando complejidad, partición de datos y métricas, sin confundir importancia con causalidad.
Del concepto a la práctica
Taller de esta lección
La comparación justa entre Random Forest y Extra Trees mantiene datos, semilla, profundidad, hojas mínimas y métrica. La diferencia estudiada es cómo se seleccionan divisiones aleatorias; una importancia alta describe asociación con el modelo, no causalidad.
Ejemplo resuelto
X_train = [[1, 10], [2, 20], [3, 30], [4, 40], [5, 50], [6, 60]]
y_train = [0, 0, 0, 1, 1, 1]
X_valid = [[2, 15], [5, 55]]
y_valid = [0, 1]
from sklearn.ensemble import RandomForestClassifier, ExtraTreesClassifier
config = dict(n_estimators=50, max_depth=3, min_samples_leaf=2, random_state=7)
modelos = {"rf": RandomForestClassifier(**config), "et": ExtraTreesClassifier(**config)}
for nombre, modelo in modelos.items():
    modelo.fit(X_train, y_train)
    print(nombre, modelo.score(X_valid, y_valid))
Congela la separación.
Usa la misma configuración inicial.
Registra puntuación y tiempo de ajuste.
Cambia una variable experimental cada vez.
Error frecuente: declarar ganador porque tiene mayor importancia de variables. Corrígelo comparando la métrica reservada y su variabilidad.
Pruébalo
Usa una tabla local con seis filas y dos variables, y calcula ambos score sobre las mismas dos filas de validación.
Comprueba tu resultado
El informe debe contener dos puntuaciones, una por modelo, y aclarar que no permiten afirmar causalidad.
Las filas son una demostración pequeña del contrato; sus métricas no representan un rendimiento comercial. En la práctica de churn, añade una partición temporal o por cuenta conforme al escenario y usa datos suficientes para estimar dispersión.
La aleatoriedad difiere tanto en los umbrales de división como en el muestreo por defecto: RandomForest usa bootstrap=True y ExtraTrees bootstrap=False. Registra esos valores además de la configuración común; mantener profundidad y semilla no vuelve idéntico el protocolo de muestreo. Si quieres aislar umbrales, iguala bootstrap conscientemente y compara bajo la misma partición, sin prometer una mejora universal.
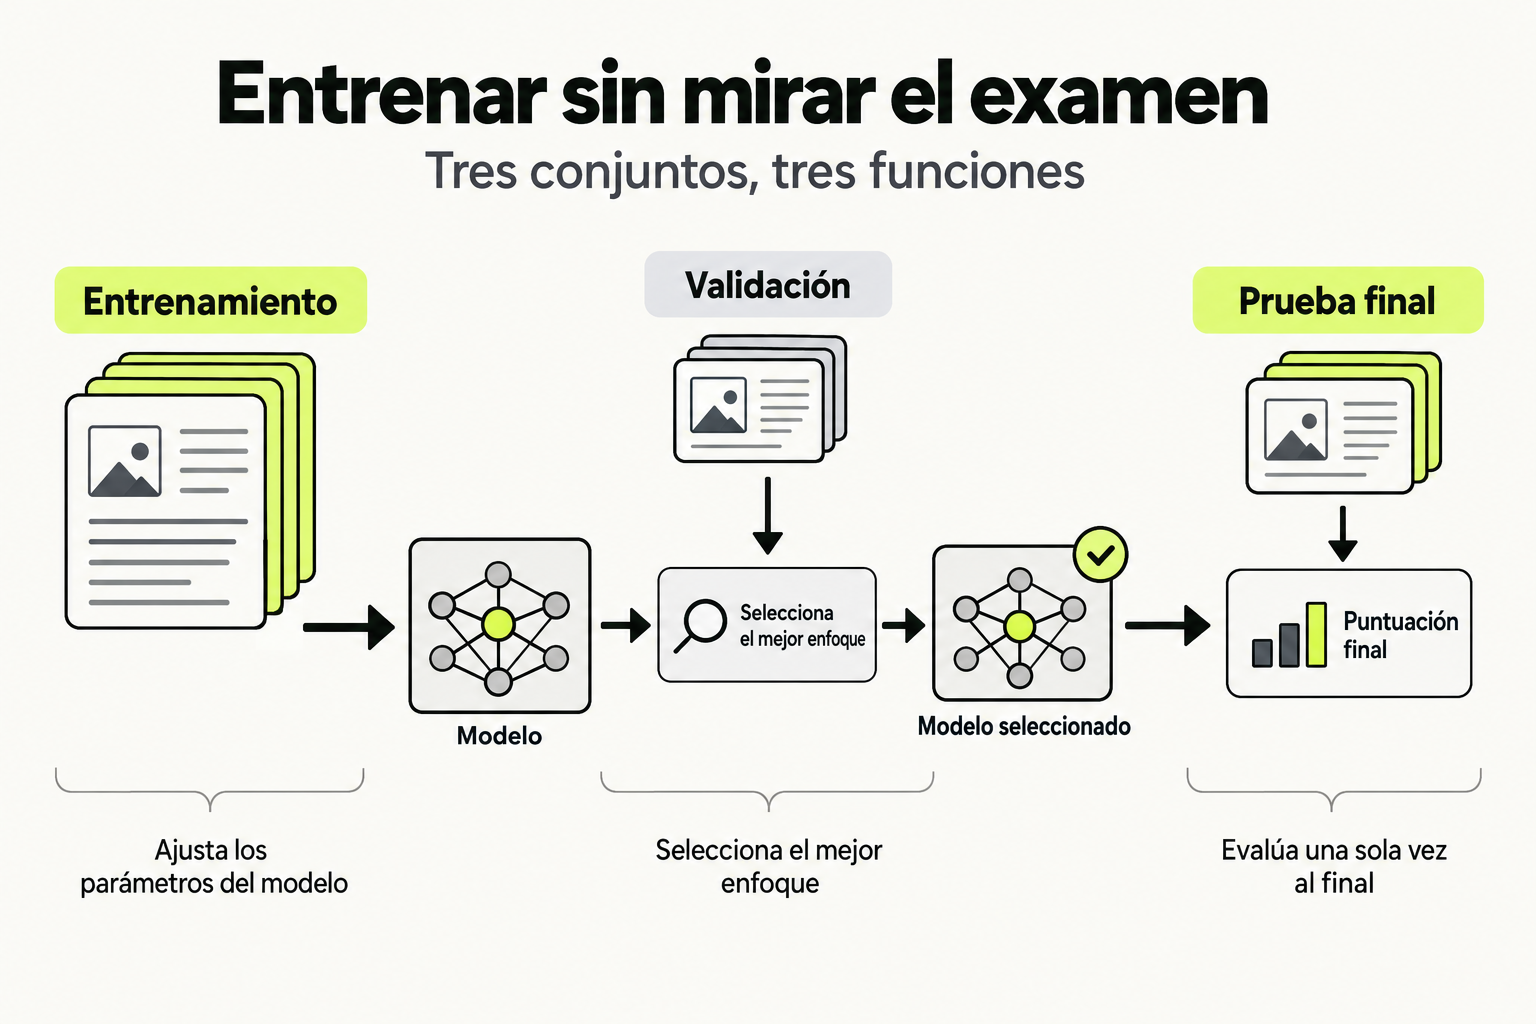
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Dos conjuntos de árboles, una misma pregunta
Random Forest y Extra Trees combinan árboles con mecanismos distintos de aleatoriedad. Para aprender la diferencia, usa la misma tarea y la misma separación. No cambies a la vez el dataset, la profundidad y la métrica: después no podrás explicar qué produjo el cambio observado.
Configuraciones sencillas para comparar
from sklearn.ensemble import RandomForestClassifier, ExtraTreesClassifier

modelos = {
    "forest": RandomForestClassifier(
        n_estimators=100, max_depth=6,
        min_samples_leaf=5, random_state=7,
    ),
    "extra": ExtraTreesClassifier(
        n_estimators=100, max_depth=6,
        min_samples_leaf=5, random_state=7,
    ),
}
# Ajusta ambos sobre el mismo X_train, y_train.
# Evalúa sobre el mismo conjunto de validación reservado.
Estos parámetros son un punto de partida didáctico, no una recomendación óptima. Revisa las versiones instaladas y los valores por defecto, incluido el muestreo. Mantén fuera del ajuste las filas de validación y test. Si hay grupos o tiempo, diseña la separación para ese contexto.
Una comparación que puedas explicar
| Registro | Por qué importa |
|---|---|
| Filas y clases por conjunto | Detectar una separación diferente o desbalanceada |
| Profundidad y tamaño de hoja | Entender capacidad y sobreajuste |
| Métrica de entrenamiento y validación | Ver una diferencia entre memorizar y generalizar |
| Tiempo observado | Evaluar coste real del entorno |
| Semilla y versión | Repetir la configuración |
- Construye una referencia sencilla para la misma etiqueta.
- Ejecuta ambas configuraciones y registra resultados propios.
- Cambia solo la profundidad y observa el entrenamiento y la validación.
- Prueba una segunda semilla y describe si tu conclusión cambia.
- Documenta una situación en la que no usarías el resultado para una decisión real.
Importancia de variables: una pista, no una explicación causal
Una variable importante para predecir no demuestra que intervenir sobre ella cambie el resultado. Correlaciones, categorías numerosas y variables redundantes pueden alterar el reparto de importancia. Si exploras importancia por permutación, hazlo en datos reservados y explica qué pérdida estás midiendo; no lo conviertas en una lista de causas.
Criterios de revisión
- Los conjuntos y métricas son iguales para los dos modelos.
- La configuración y versión se pueden reconstruir.
- Explicas al menos una diferencia entre entrenamiento y validación.
- No presentas una precisión no ejecutada ni una conclusión causal.
- El test final no se usó para escoger profundidad o modelo.
Referencias para comprobar la implementación
Documentación consultada el 2 de octubre de 2026. Comprueba también las versiones y condiciones de tu proyecto.
Sigue con Machine Learning Práctico con Scikit-Learn
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.