

Lección 1 de 16 · Lectura y práctica
Pipeline API Avanzada con ColumnTransformer
Pipeline API Avanzada con ColumnTransformer Esta leccion pertenece al curso Machine Learning Práctico con Scikit-Learn y esta pensada para que avances con criterio profesional, no solo con teoria. Primero entiende el concepto,.
Del concepto a la práctica
Taller de esta lección
ColumnTransformer permite asignar tratamientos distintos sin separar manualmente las tablas. En una tabla de clientes, meses_activa y saldo pueden imputarse y escalarse, mientras plan se codifica; el identificador queda fuera.
Ejemplo resuelto
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.impute import SimpleImputer
from sklearn.pipeline import Pipeline
num = Pipeline([("imp", SimpleImputer(strategy="median")), ("esc", StandardScaler())])
cat = Pipeline([("imp", SimpleImputer(strategy="most_frequent")), ("oh", OneHotEncoder(handle_unknown="ignore"))])
pre = ColumnTransformer([("num", num, ["meses_activa", "saldo"]), ("cat", cat, ["plan"])])
import pandas as pd
entrenamiento = pd.DataFrame({"meses_activa": [2, 4], "saldo": [None, 100.0], "plan": ["basico", "pro"], "cuenta_id": [1, 2]})
evaluacion = pd.DataFrame({"meses_activa": [3, 5], "saldo": [80.0, 120.0], "plan": ["pro", "premium"], "cuenta_id": [3, 4]})
pre.fit(entrenamiento)
print(pre.transform(evaluacion).shape)  # (2, 4)
Define columnas por función, no por posición accidental.
Encapsula cada tratamiento.
Une las ramas con nombres claros.
Ajusta el conjunto completo solo dentro de un
Pipelinecon el estimador.
Error frecuente: imputar antes de dividir. Corrígelo haciendo que fit ocurra únicamente durante el entrenamiento.
Pruébalo
Usa las cuatro filas indicadas: dos de entrenamiento y dos de evaluación. La imputación aprende del entrenamiento y el plan premium aparece solo en evaluación. Ajusta el preprocesador con las primeras dos y transforma las otras dos.
Comprueba tu resultado
La transformación no falla ante el plan nuevo, conserva las dos filas de evaluación y no contiene cuenta_id.
La salida tiene dos columnas numéricas y dos indicadores de los planes aprendidos. Los indicadores de premium quedan en cero. Este ajuste aislado permite inspeccionar la forma; para seleccionar un estimador con validación cruzada, incorpora un preprocesador nuevo dentro del pipeline completo, de modo que cada pliegue aprenda su propio estado.
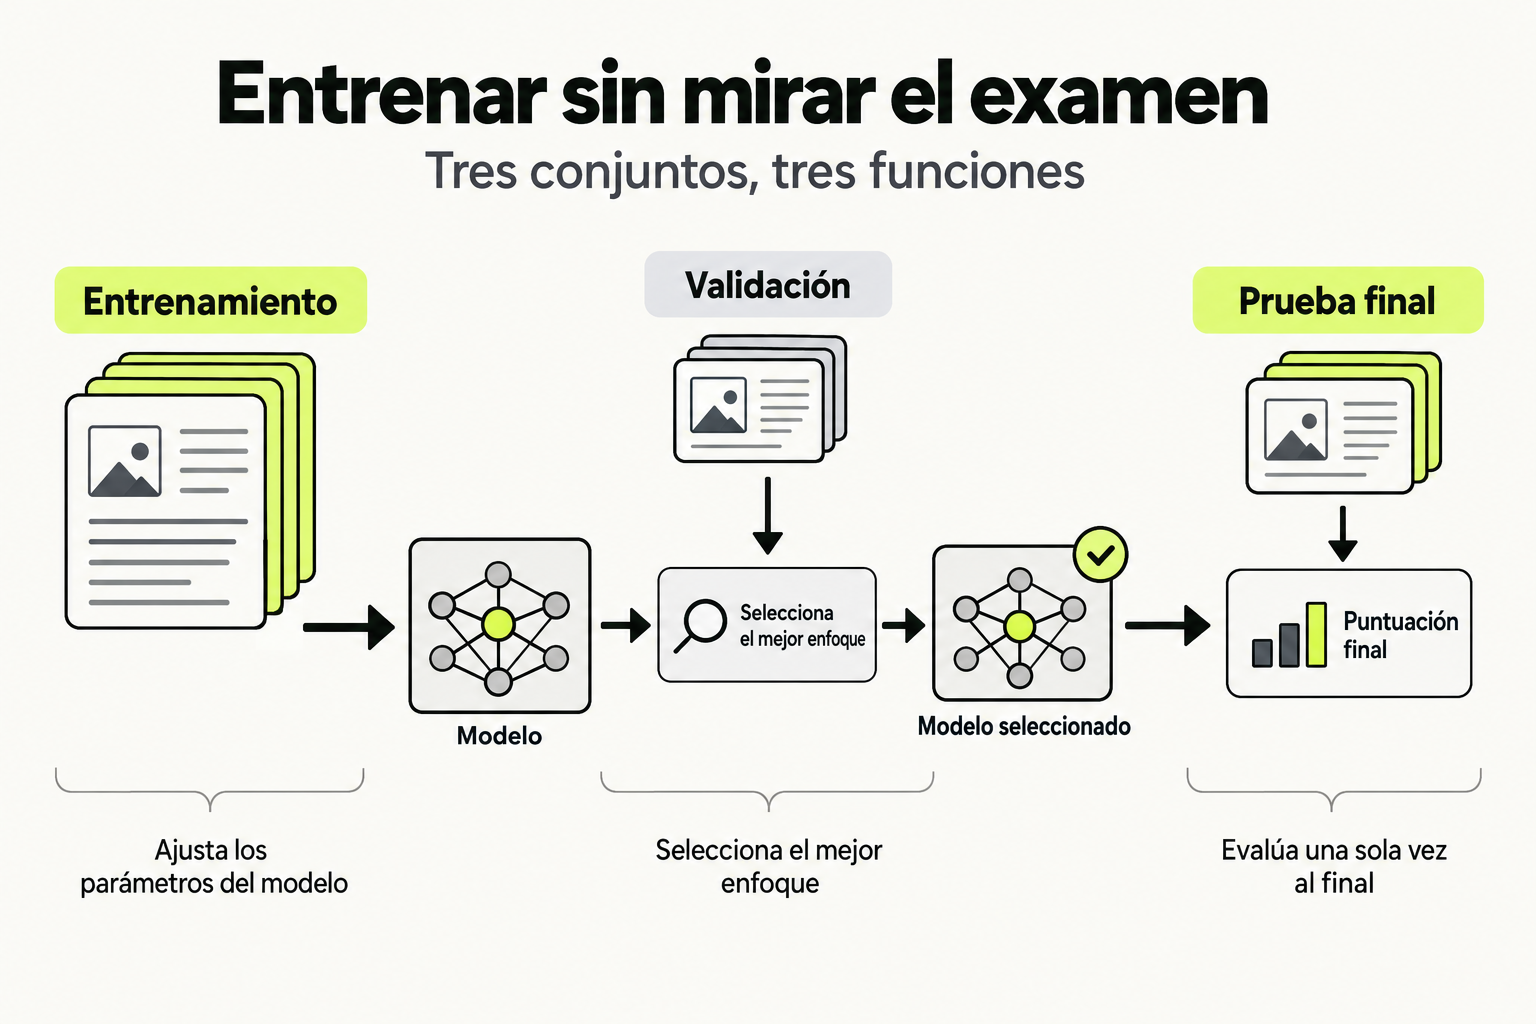
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Pipeline API Avanzada con ColumnTransformer
Esta leccion pertenece al curso Machine Learning Práctico con Scikit-Learn y esta pensada para que avances con criterio profesional, no solo con teoria. Primero entiende el concepto, despues aplicalo en una situacion concreta y finalmente deja evidencia de lo que aprendiste.
Objetivo practico
Al terminar, deberias poder explicar el tema con tus palabras, reconocer cuando usarlo y construir una version simple que sirva como base para un proyecto real.
Pasos recomendados
- Lee el concepto y escribi una definicion breve.
- Identifica un caso de uso laboral donde aparezca este problema.
- Construye un ejemplo pequeno y documenta las decisiones.
- Compara tu resultado con el checklist de la leccion.
Sigue con Machine Learning Práctico con Scikit-Learn
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.