

Lección 10 de 14 · Lectura y práctica
Transformación y agregación
Transformando datos Filtrado import pandas as pd # Condicion simple df[df['edad'] > 25] # Condiciones multiples df[(df['edad'] > 25) & (df['ciudad'] == 'Madrid')] df[(df['edad'] 30)] # isin: multiples.
Del concepto a la práctica
Taller de esta lección
Una agregación debe conservar la relación entre el grupo y la medida. Si cada fila representa una venta, sum responde cuánto se vendió; mean responde el importe medio por fila. Elegir la función equivocada cambia la pregunta, aunque el código funcione.
Ejemplo resuelto
import pandas as pd

ventas = pd.DataFrame({
    'categoria': ['libro', 'libro', 'juego'],
    'importe': [12, 18, 25],
    'unidades': [1, 2, 1]
})
resumen = ventas.groupby('categoria', as_index=False).agg(
    importe_total=('importe', 'sum'),
    unidades_total=('unidades', 'sum')
)
print(resumen)
Se agrupa por categoría sin usar el índice como columna.
Se suman importes y unidades por separado.
Libro produce 30 de importe y 3 unidades.
Juego produce 25 de importe y 1 unidad.
Un error frecuente es dividir el importe total entre el número de categorías y llamarlo promedio por venta. Corrígelo usando mean sobre la columna de importe cuando esa sea la unidad requerida.
Pruébalo
Añade una venta de juego con importe 10 y una unidad y calcula de nuevo ambas sumas.
Comprueba tu resultado
Libro permanece en 30 y 3; juego debe quedar en 35 de importe y 2 unidades.
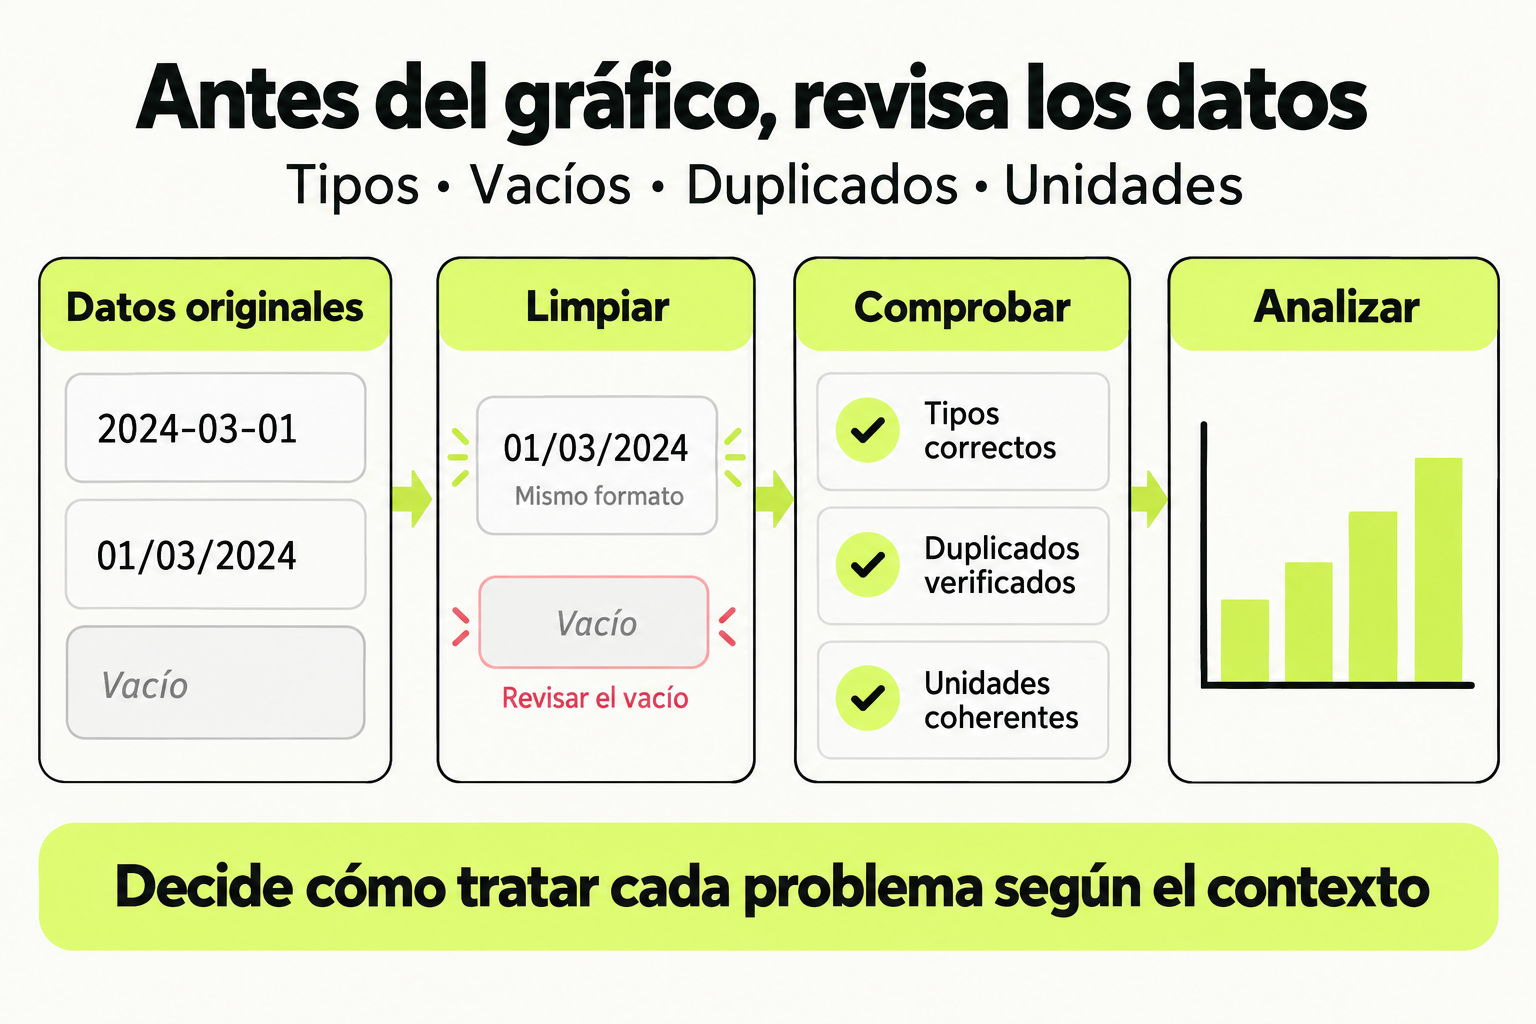
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Transformando datos
Filtrado
import pandas as pd

# Condicion simple
df[df['edad'] > 25]

# Condiciones multiples
df[(df['edad'] > 25) & (df['ciudad'] == 'Madrid')]
df[(df['edad'] < 20) | (df['edad'] > 30)]

# isin: multiples valores
df[df['ciudad'].isin(['Madrid', 'Barcelona'])]

# query: sintaxis SQL-like
df.query('edad > 25 and ciudad == "Madrid"')
Ordenamiento
# Por una columna
df.sort_values('edad')
df.sort_values('edad', ascending=False)

# Por multiples columnas
df.sort_values(['ciudad', 'edad'], ascending=[True, False])

# Por indice
df.sort_index()
Agregar y modificar columnas
# Nueva columna
df['edad_en_meses'] = df['edad'] * 12

# Con funcion
df['categoria'] = df['edad'].apply(lambda x: 'joven' if x < 30 else 'adulto')

# Con condiciones
df['nivel'] = np.where(df['puntos'] > 100, 'alto', 'bajo')

# Multiples condiciones
condiciones = [
    df['edad'] < 18,
    df['edad'] < 30,
    df['edad'] >= 30
]
valores = ['menor', 'joven', 'adulto']
df['grupo'] = np.select(condiciones, valores)
GroupBy: Agregaciones
# Agrupar y agregar
df.groupby('ciudad')['edad'].mean()
df.groupby('ciudad')['edad'].agg(['mean', 'min', 'max', 'count'])

# Multiples columnas
df.groupby(['ciudad', 'genero'])['salario'].mean()

# Multiples agregaciones
df.groupby('ciudad').agg({
    'edad': 'mean',
    'salario': ['min', 'max', 'sum'],
    'nombre': 'count'
})
Pivot Tables
# Tabla pivot (como Excel)
pd.pivot_table(
    df,
    values='ventas',
    index='producto',
    columns='mes',
    aggfunc='sum'
)

# Cross tabulation
pd.crosstab(df['genero'], df['ciudad'])
Sigue con Python para Data Science
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.