

Lección 9 de 14 · Lectura y práctica
Limpieza de datos
Limpia un dataset ficticio reproducible, usa la API actual y registra los valores que todavía requieren revisión.
Del concepto a la práctica
Taller de esta lección
Limpiar no significa borrar todo lo incómodo: significa convertir representaciones inconsistentes y dejar explícito lo que sigue desconocido. Una copia de trabajo protege los datos originales y un conteo antes y después muestra el efecto de cada decisión.
Ejemplo resuelto
import pandas as pd

base = pd.DataFrame({
    'cliente': [' Ana ', 'ANA', 'Luis'],
    'edad': ['30', 'sin dato', '41']
})
df = base.copy()
df['cliente'] = df['cliente'].str.strip().str.lower()
df['edad'] = pd.to_numeric(df['edad'], errors='coerce')
print(df['edad'].isna().sum(), df['cliente'].nunique())
# 1 2
Se recortan espacios y se normaliza el nombre.
La edad no convertible se vuelve ausente, no cero.
Queda un valor ausente y dos clientes distintos.
La copia permite comparar con
basesi hace falta.
Un error frecuente es rellenar toda edad ausente con la media sin justificarlo. Corrígelo conservando NaN hasta que exista una regla basada en el contexto.
Pruébalo
Agrega {'cliente': ' Luis ', 'edad': '41'} y calcula ausentes de edad y nombres únicos.
Comprueba tu resultado
Debe haber una edad ausente y dos nombres únicos: ana y luis; el segundo luis no añade otro valor.
El nombre normalizado es una etiqueta de este ejemplo, no una clave que demuestre identidad de persona. Personas distintas pueden compartir nombre: conserva una clave estable antes de deduplicar registros reales.
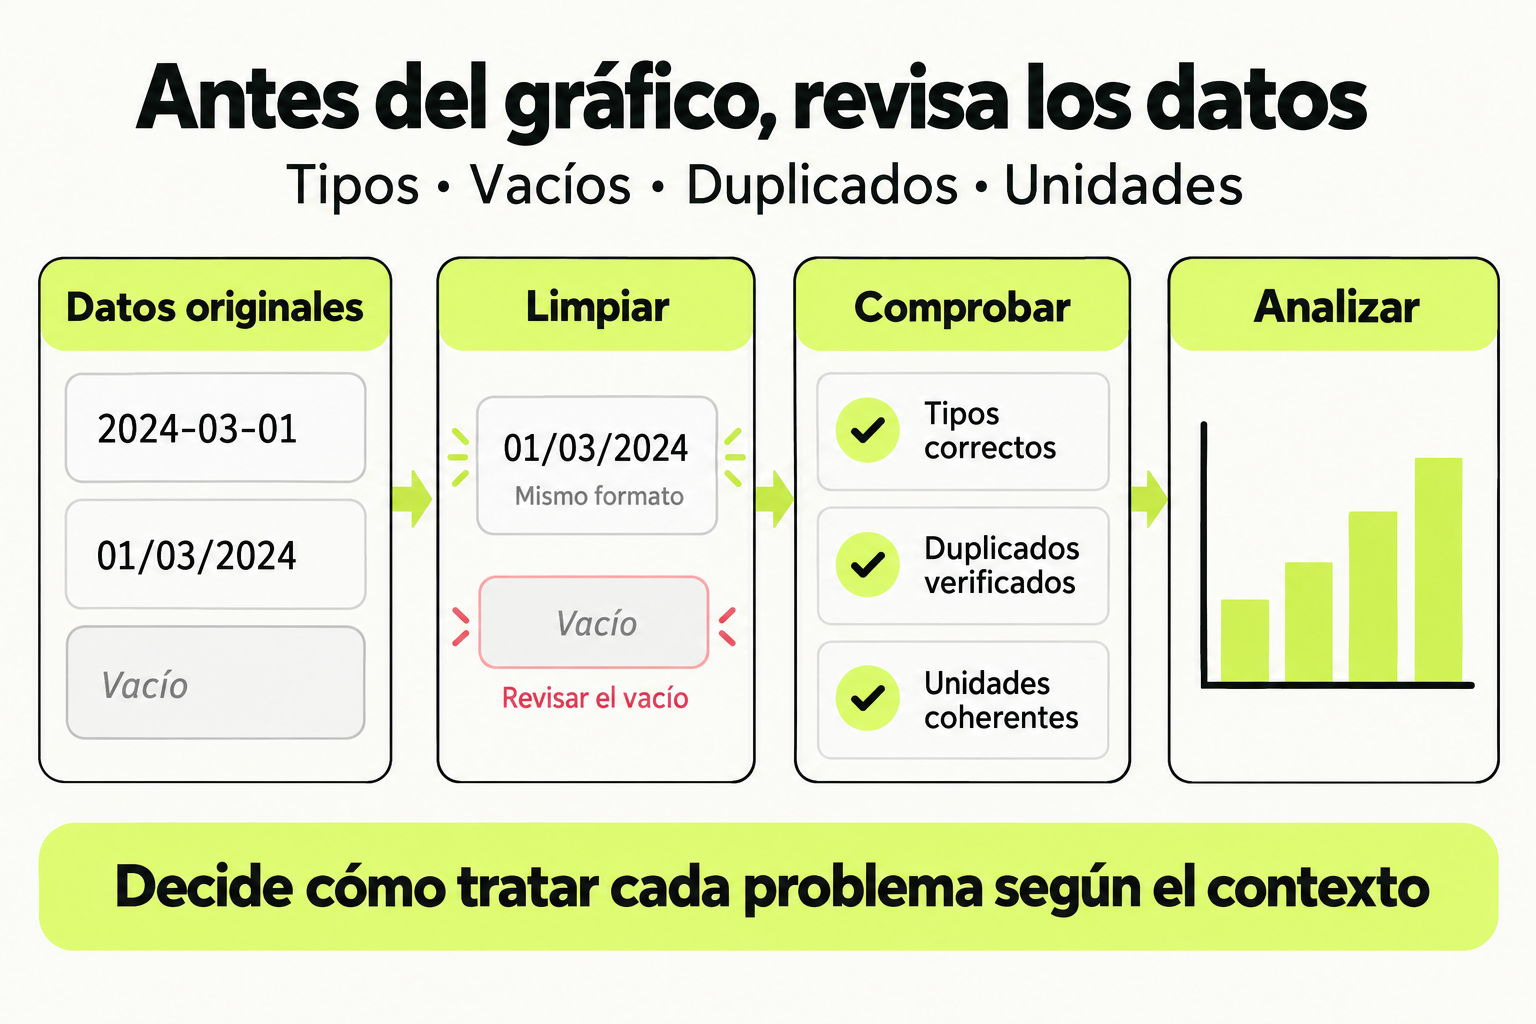
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Limpiar datos sin inventar el valor que falta
Empieza con una copia y una pregunta: ¿qué representa cada fila y qué significa un valor vacío? Un precio desconocido no equivale a cero. Un identificador repetido puede ser un duplicado o un evento legítimo distinto; decide la regla antes de eliminarlo.
Ejemplo original completo con datos ficticios
import pandas as pd

# Datos ficticios: el registro repetido conserva el mismo identificador.
original = pd.DataFrame({
    "id": ["A1", "A2", "A2", "A3"],
    "nombre": [" Ana ", "LUIS", "LUIS", None],
    "precio": ["10.50", "sin dato", "sin dato", "8"],
    "codigo": ["SKU-12", "SKU-34", "SKU-34", "sin código"],
})
df = original.copy()
df["nombre"] = df["nombre"].str.strip().str.lower()
df["precio"] = pd.to_numeric(df["precio"], errors="coerce")
print(df["precio"].isna().sum())  # 2 antes de quitar el duplicado
df = df.drop_duplicates(subset=["id"], keep="first").copy()
df["numero_codigo"] = df["codigo"].str.extract(r"([0-9]+)", expand=False)
print(df["numero_codigo"].dropna().tolist())  # ["12", "34"]
print(len(df))  # 3 identificadores únicos
print(df["precio"].isna().sum())  # 1 sigue sin precio: no inventamos cero

# Si el contexto justifica propagar una medición anterior, usa:
serie = pd.Series([10.0, None, 12.0])
print(serie.ffill().tolist())  # [10.0, 10.0, 12.0]
Tres correcciones que puedes explicar
pd.to_numeric(..., errors="coerce")convierte valores no interpretables en ausentes. Conserva el original para revisar qué se perdió.- La expresión
r"([0-9]+)"captura dígitos. Escribirr"(d+)"buscaría la letra d, no el número del código. - Usa
ffill()obfill()para propagación cuando el orden y el significado lo justifiquen. La API actual defillnarecibe valores de relleno; no uses el antiguo argumentomethod.
Ejercicio y resultado esperado
Añade un registro A4 con precio «12,50». Decide explícitamente cómo interpretar la coma decimal antes de convertirlo. Conserva una columna con el texto original y una lista de filas pendientes de revisión. No apliques la media a todas las columnas de una tabla que también contiene nombres y códigos.
Entrega un recuento de filas iniciales, identificadores repetidos, filas finales y precios todavía ausentes. Para el ejemplo dado son 4 filas iniciales, 3 finales y 1 precio ausente al final. La decisión de conservarlo ausente es parte del análisis, no un fallo que debas esconder.
Referencias oficiales: fillna, ffill y str.extract. Revisado el 2 de octubre de 2026.
Sigue con Python para Data Science
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.