

Lección 11 de 14 · Lectura y práctica
Combinando DataFrames
Uniendo datos Concat: Apilar DataFrames import pandas as pd df1 = pd.DataFrame({'A': [1, 2], 'B': [3, 4]}) df2 = pd.DataFrame({'A': [5, 6], 'B': [7, 8]}) # Apilar verticalmente (filas) pd.concat([df1, df2]) # A B # 0 1 3 # 1 2 4.
Del concepto a la práctica
Taller de esta lección
concat apila tablas con la misma estructura; merge relaciona filas mediante una clave. Antes de unir, revisa si la clave es única en cada lado. Una relación de un pedido con varias líneas puede aumentar filas legítimamente, pero también puede inflar totales si se une dos veces.
Ejemplo resuelto
import pandas as pd

clientes = pd.DataFrame({'id': [1, 2], 'nombre': ['Ana', 'Luis']})
pedidos = pd.DataFrame({'cliente_id': [1, 1, 2], 'importe': [10, 4, 8]})
unido = clientes.merge(pedidos, left_on='id', right_on='cliente_id', how='left', validate='one_to_many')
print(len(unido), unido['importe'].sum())
# 3 22
La clave
ididentifica clientes.cliente_idpuede repetirse porque un cliente tiene varios pedidos.El
leftconserva a todos los clientes.Las tres líneas suman 10 más 4 más 8, igual a 22.
Un error frecuente es unir por una columna con nombres distintos sin declararlo. Corrígelo con left_on y right_on, y comprueba el número de filas resultante.
Pruébalo
Añade el cliente 3 sin pedidos y repite la unión.
Comprueba tu resultado
Debe haber cuatro filas, una para el cliente 3 con importe ausente; la suma de importes no ausentes sigue siendo 22.
La validación exige claves únicas en clientes y permite repetición en pedidos; una segunda fila de cliente con el mismo id debe producir un error en vez de multiplicar importes. Comprueba claves nulas antes de unir: Pandas puede emparejar nulos con nulos, a diferencia del comportamiento SQL habitual.
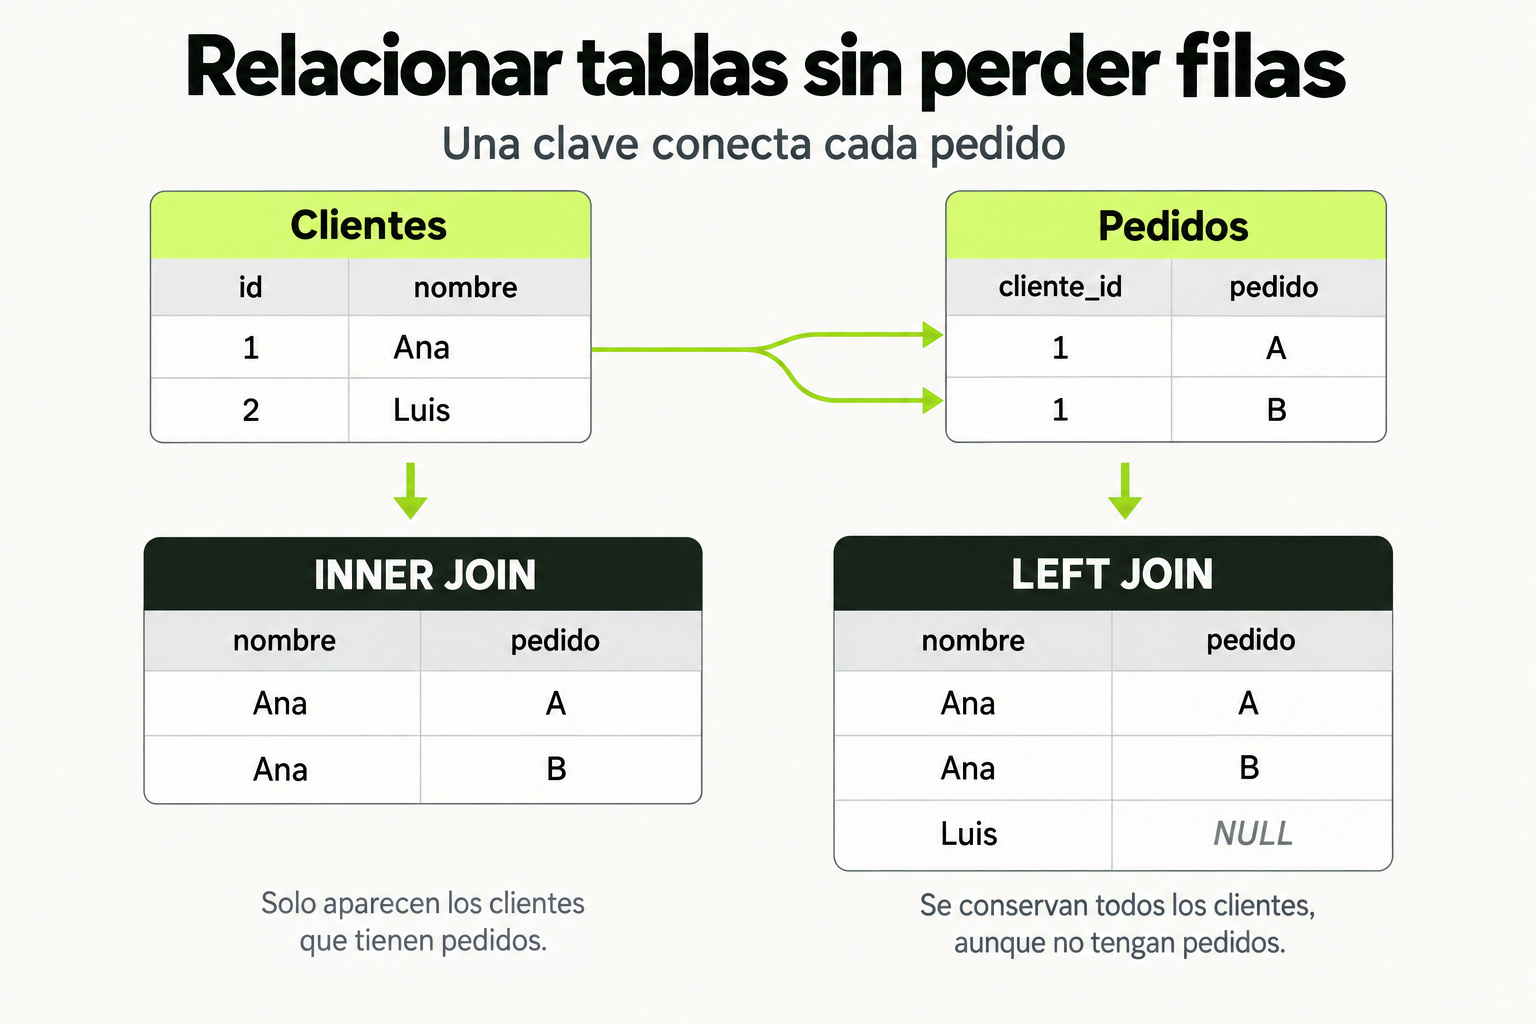
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Uniendo datos
Concat: Apilar DataFrames
import pandas as pd

df1 = pd.DataFrame({'A': [1, 2], 'B': [3, 4]})
df2 = pd.DataFrame({'A': [5, 6], 'B': [7, 8]})

# Apilar verticalmente (filas)
pd.concat([df1, df2])
#    A  B
# 0  1  3
# 1  2  4
# 0  5  7
# 1  6  8

# Resetear indice
pd.concat([df1, df2], ignore_index=True)

# Apilar horizontalmente (columnas)
pd.concat([df1, df2], axis=1)
Merge: JOIN como SQL
# DataFrames de ejemplo
clientes = pd.DataFrame({
    'id': [1, 2, 3],
    'nombre': ['Ana', 'Luis', 'Maria']
})
pedidos = pd.DataFrame({
    'cliente_id': [1, 1, 2, 4],
    'producto': ['A', 'B', 'C', 'D']
})

# Inner join (solo coincidencias)
pd.merge(clientes, pedidos, left_on='id', right_on='cliente_id')

# Left join (todos los de la izquierda)
pd.merge(clientes, pedidos, left_on='id', right_on='cliente_id', how='left')

# Right join
pd.merge(clientes, pedidos, left_on='id', right_on='cliente_id', how='right')

# Outer join (todos)
pd.merge(clientes, pedidos, left_on='id', right_on='cliente_id', how='outer')

# Mismo nombre de columna
pd.merge(df1, df2, on='id')
Join: Por indice
df1 = pd.DataFrame({'A': [1, 2]}, index=['a', 'b'])
df2 = pd.DataFrame({'B': [3, 4]}, index=['a', 'b'])

df1.join(df2)
#    A  B
# a  1  3
# b  2  4
Guardando datos
# CSV
df.to_csv('resultado.csv', index=False)

# Excel
df.to_excel('resultado.xlsx', index=False)

# JSON
df.to_json('resultado.json', orient='records')

# Parquet (eficiente)
df.to_parquet('resultado.parquet')
Sigue con Python para Data Science
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.