

Lección 8 de 14 · Lectura y práctica
Introducción a Pandas
Pandas: análisis de datos tabulares Pandas es la herramienta que más usarás como analista. Trabaja con datos en forma de tabla, igual que una hoja de cálculo, pero con la potencia de Python. Sus dos estructuras son la Series (una.
Del concepto a la práctica
Taller de esta lección
Un DataFrame combina valores con etiquetas: la columna explica qué mide cada dato y el índice etiqueta la fila y puede contener valores repetidos; no siempre equivale a su posición. La inspección inicial debe confirmar nombres, tipos y cantidad de observaciones antes de calcular estadísticas.
Ejemplo resuelto
import pandas as pd

df = pd.DataFrame({
    'producto': ['A', 'B', 'A'],
    'unidades': [2, 1, 3],
    'precio': [5.0, 8.0, 5.0]
})
print(df.shape)
print(df.loc[df['producto'] == 'A', 'unidades'].sum())
# (3, 3)
# 5shapeconfirma tres filas y tres columnas.La selección por etiqueta filtra las dos filas de A.
locdevuelve solo la columna necesaria.Las unidades de A suman 2 más 3, es decir, 5.
Un error frecuente es usar iloc esperando seleccionar por nombre. Corrígelo con loc para etiquetas y reserva iloc para posiciones numéricas.
Pruébalo
Añade una fila de producto B con 4 unidades y precio 8. Calcula las unidades totales de B y consulta las columnas del DataFrame.
Comprueba tu resultado
El total de B debe ser 5 y las columnas deben ser ['producto', 'unidades', 'precio'].
Para añadir la fila del ejercicio sin usar métodos retirados:
nueva = pd.DataFrame([{"producto": "B", "unidades": 4, "precio": 8.0}])
df = pd.concat([df, nueva], ignore_index=True)
print(df.loc[df["producto"] == "B", "unidades"].sum())
# 5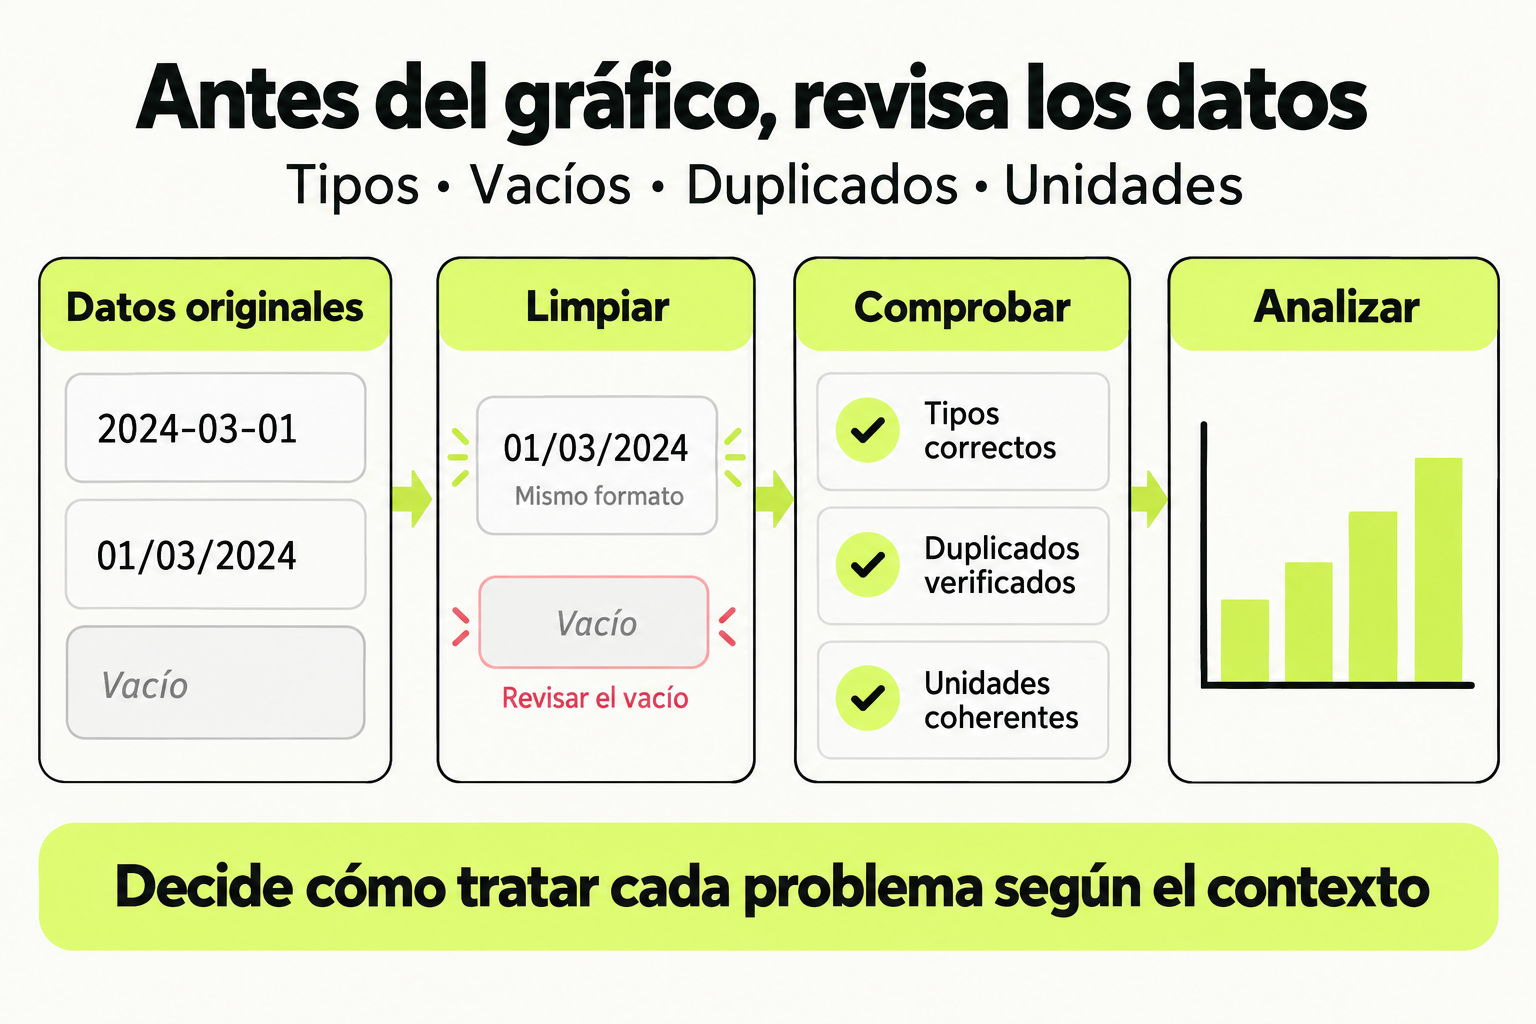
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Pandas: análisis de datos tabulares
Pandas es la herramienta que más usarás como analista. Trabaja con datos en forma de tabla, igual que una hoja de cálculo, pero con la potencia de Python. Sus dos estructuras son la Series (una columna con índice) y el DataFrame (una tabla con filas y columnas). El DataFrame será tu compañero diario.
Crear estructuras
import pandas as pd

# Series: array 1D con índice
s = pd.Series([1, 2, 3, 4], index=['a', 'b', 'c', 'd'])

# DataFrame: la tabla 2D que más usarás
df = pd.DataFrame({
    'nombre': ['Ana', 'Luis', 'María'],
    'edad': [25, 30, 28],
    'ciudad': ['Madrid', 'Barcelona', 'Valencia']
})
Cargar datos desde fuentes reales
# CSV (lo más habitual)
df = pd.read_csv('datos.csv')

# Excel
df = pd.read_excel('datos.xlsx', sheet_name='Hoja1')

# JSON
df = pd.read_json('datos.json')

# Directamente desde una URL
df = pd.read_csv('https://ejemplo.com/data.csv')
Exploración inicial: lo primero que haces siempre
df.head()      # primeras 5 filas
df.tail(10)    # últimas 10 filas
df.shape       # (filas, columnas)
df.info()      # tipos de dato y conteo de nulos
df.describe()  # estadísticas de las columnas numéricas

df.columns                    # nombres de columnas
df['ciudad'].unique()         # valores únicos
df['ciudad'].value_counts()   # frecuencia de cada valor
Consejo
Antes de transformar nada, ejecuta siempre df.head(), df.info() y df.describe(). En 30 segundos sabes el tamaño, los tipos y dónde hay valores faltantes.
Seleccionar datos: loc e iloc
df['nombre']            # una columna (Series)
df[['nombre', 'edad']]  # varias columnas (DataFrame)

# iloc: por posición numérica
df.iloc[0]      # primera fila
df.iloc[0:3]    # filas 0, 1, 2

# loc: por etiqueta de índice y nombre de columna
df.loc[0, 'nombre']     # valor concreto
df.loc[:, 'edad']       # toda la columna edad
¿Cuándo uso loc y cuándo iloc?
Usa iloc cuando piensas en posiciones (la fila número 3, las columnas 0 a 2). Usa loc cuando piensas en etiquetas (la fila con índice "2025-01" y la columna "ventas"). Mezclarlos es una fuente frecuente de errores.
Quieres ver rápidamente cuántos valores nulos hay en cada columna. ¿Qué método te lo muestra?
df.info() lista cada columna, su tipo y el número de valores no nulos, de donde deduces los faltantes.Ejercicio práctico
Objetivo: cargar y explorar un conjunto de datos de verdad.
- Crea un DataFrame con 6 productos: columnas nombre, categoría, precio y stock.
- Ejecuta
head(),info()ydescribe()y describe en una frase lo que ves. - Selecciona solo las columnas nombre y precio.
- Usa
value_counts()sobre categoría para ver cuántos productos hay por tipo.
Entregable: notebook con la exploración inicial y el conteo por categoría.
Para recordar
- Series = columna con índice; DataFrame = tabla; este último es el que más usarás.
read_csv,read_excelyread_jsoncargan datos desde casi cualquier fuente.locselecciona por etiqueta yilocpor posición.
Sigue con Python para Data Science
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.