

Lección 7 de 14 · Lectura y práctica
NumPy en la práctica
NumPy en la práctica Ya conoces los arrays y las operaciones vectorizadas. Ahora veremos patrones que aparecen constantemente en proyectos reales: filtrar con condiciones, cambiar la forma de los datos, combinarlos y prepararlos.
Del concepto a la práctica
Taller de esta lección
Las máscaras booleanas permiten seleccionar observaciones y reshape permite cambiar la disposición sin alterar los valores. Antes de normalizar, calcula la media y la desviación con el mismo conjunto de datos para que la transformación sea reproducible.
Ejemplo resuelto
import numpy as np

x = np.arange(1, 7).reshape(2, 3)
seleccion = x[x > 3]
media = x.mean()
desv = x.std()
z = (x - media) / desv
print(x.shape, seleccion, round(z.mean(), 6))
# (2, 3) [4 5 6] 0.0arangecrea seis valores yreshapelos organiza en dos filas.La máscara conserva solo valores mayores que 3.
El estándar usa la media y desviación poblacionales de esas seis celdas.
La estandarización centra el conjunto en aproximadamente cero.
Un error frecuente es combinar condiciones con and. Corrígelo usando & entre expresiones parentizadas cuando la máscara tenga más de una condición.
Pruébalo
Con x = np.array([2, 4, 6, 8]), selecciona valores entre 3 y 7 inclusive y calcula su media.
Comprueba tu resultado
La selección debe ser [4, 6] y su media debe ser 5.0.
Aquí std() usa ddof=0. Si la desviación es cero, todos los valores son iguales y dividir por ella no es válido: detecta el caso y documenta si devuelves ceros o rechazas la transformación. Para modelos predictivos, calcula media y escala solo en entrenamiento y aplica esos valores al conjunto de evaluación; este ejemplo descriptivo no entrena un modelo.
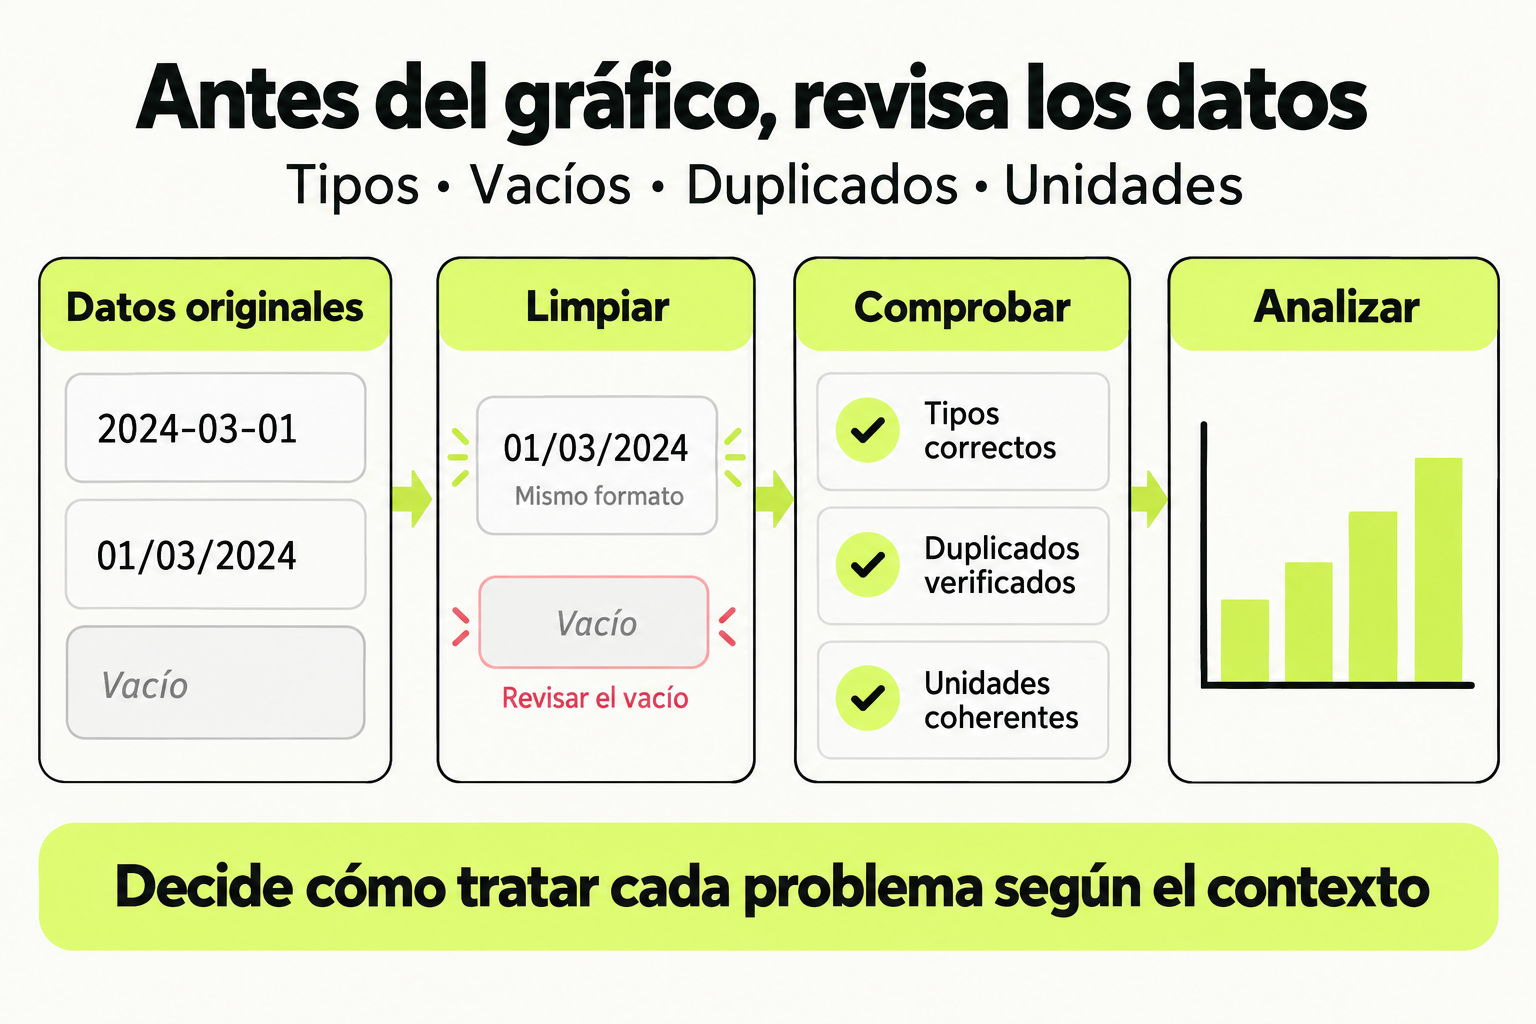
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
NumPy en la práctica
Ya conoces los arrays y las operaciones vectorizadas. Ahora veremos patrones que aparecen constantemente en proyectos reales: filtrar con condiciones, cambiar la forma de los datos, combinarlos y prepararlos para un modelo. Estos son los movimientos diarios de un científico de datos.
Filtrado con condiciones booleanas
import numpy as np

edades = np.array([15, 22, 35, 18, 45, 30, 17])

# Una condición devuelve un array de True/False
mayores = edades >= 18

# Se usa como máscara para seleccionar
edades[edades >= 18]                          # [22 35 18 45 30]
edades[(edades >= 18) & (edades <= 35)]       # [22 35 18 30]
Atención
En NumPy usa & y | (no and/or) para combinar condiciones, y rodea cada condición con paréntesis. Olvidarlos es uno de los errores más comunes.
Cambiar la forma de los datos
arr = np.arange(12)            # [0, 1, ..., 11]
matriz = arr.reshape(3, 4)     # 3 filas, 4 columnas

matriz.flatten()   # vuelve a 1D
matriz.T           # transpuesta (filas <-> columnas)
Combinar arrays
a = np.array([1, 2, 3])
b = np.array([4, 5, 6])

np.concatenate([a, b])   # [1 2 3 4 5 6]
np.vstack([a, b])        # apila como filas
np.hstack([a, b])        # apila como columnas (1D -> [1 2 3 4 5 6])
Preparar datos para un modelo
Casi todos los modelos esperan datos en una escala comparable. Dos técnicas clásicas:
datos = np.array([100, 200, 300, 150, 250])

# Normalización Min-Max -> rango [0, 1]
normalizado = (datos - datos.min()) / (datos.max() - datos.min())

# Estandarización -> media 0, desviación 1
estandarizado = (datos - datos.mean()) / datos.std()
Generar datos para simular
np.random.seed(42)   # fija la semilla para resultados reproducibles

# Distribución normal: media 170, desviación 10, 1000 muestras
alturas = np.random.normal(loc=170, scale=10, size=1000)

# Enteros aleatorios entre 1 y 6 (dos dados, 100 tiradas)
dados = np.random.randint(1, 7, size=(100, 2))
Consejo
Fija siempre np.random.seed(...) al inicio cuando uses aleatoriedad. Así tus resultados y los de quien revise tu trabajo serán idénticos.
¿Por qué usamos & en lugar de and al combinar condiciones sobre un array de NumPy?
and intenta evaluar la verdad del array entero y lanza un error; & aplica el AND lógico posición a posición, que es lo que queremos para filtrar.Ejercicio práctico
Objetivo: simular y preparar un conjunto de datos.
- Fija la semilla a 42 y genera 200 salarios con
np.random.normal(loc=2500, scale=600, size=200). - Filtra solo los salarios entre 2000 y 3500.
- Estandariza el array filtrado (media 0, desviación 1) y verifica imprimiendo su media y desviación.
- Reorganiza los primeros 12 valores originales en una matriz 3x4 con
reshape.
Entregable: notebook con el array filtrado, sus estadísticas estandarizadas y la matriz 3x4.
Para recordar
- Las máscaras booleanas filtran arrays; combina condiciones con
&y|entre paréntesis. reshape,flatteny.Tcambian la forma sin cambiar los datos.- Normalizar o estandarizar pone los datos en una escala comparable antes de modelar.
Sigue con Python para Data Science
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.