

Lección 6 de 16 · Lectura y práctica
Gradient Boosting: XGBoost, LightGBM y CatBoost
Compara XGBoost, LightGBM y CatBoost con la misma separación, una referencia y un registro de configuración, sin declarar un ganador universal.
Del concepto a la práctica
Taller de esta lección
Gradient boosting añade modelos pequeños de forma secuencial para corregir errores anteriores. Comparar implementaciones exige fijar etiqueta, partición, métrica y presupuesto; sus nombres no garantizan un ganador universal. Una referencia sencilla revela si la complejidad aporta algo.
Ejemplo resuelto
X_train = [[1, 10], [2, 20], [3, 30], [4, 40], [5, 50], [6, 60]]
y_train = [0, 0, 0, 1, 1, 1]
X_valid = [[2, 15], [5, 55]]
y_valid = [0, 1]
from sklearn.dummy import DummyClassifier
from sklearn.metrics import balanced_accuracy_score
ref = DummyClassifier(strategy="most_frequent")
ref.fit(X_train, y_train)
pred = ref.predict(X_valid)
print(balanced_accuracy_score(y_valid, pred))
Define la clase positiva y la fecha de corte.
Congela entrenamiento y validación.
Obtén la métrica de referencia.
Registra para cada implementación configuración, tiempo y puntuación.
Error frecuente: comparar una biblioteca con variables preprocesadas de otra forma. Corrígelo usando el mismo contrato de entrada o documentando la diferencia.
Pruébalo
Para un segundo cálculo manual, usa etiquetas de evaluación [0, 0, 0, 0, 1, 1] y seis predicciones [0, 0, 0, 0, 0, 0]. Calcula recall de cada clase y su media.
Comprueba tu resultado
La referencia predice siempre cero; la balanced accuracy es 0,5 si la matriz contiene aciertos de la clase cero y ningún acierto de la clase uno.
El caso de evaluación aquí contiene pocas observaciones para que puedas reconstruir cada resultado. Una precisión alta en ese fixture no estima el desempeño comercial: antes de tomar una decisión, repite el protocolo con una partición temporal o por cuenta que respete cuándo madura la etiqueta, y muestra la variación entre evaluaciones.
La referencia obtiene recall 1 para la clase cero y 0 para la clase uno; balanced accuracy=(1+0)/2=0,5. La exactitud del segundo cálculo es 4/6, una métrica distinta. Al comparar XGBoost, LightGBM o CatBoost registra también cómo cada versión trata categorías y valores faltantes; no deduzcas equivalencia a partir del nombre del algoritmo.
 Mapa de práctica
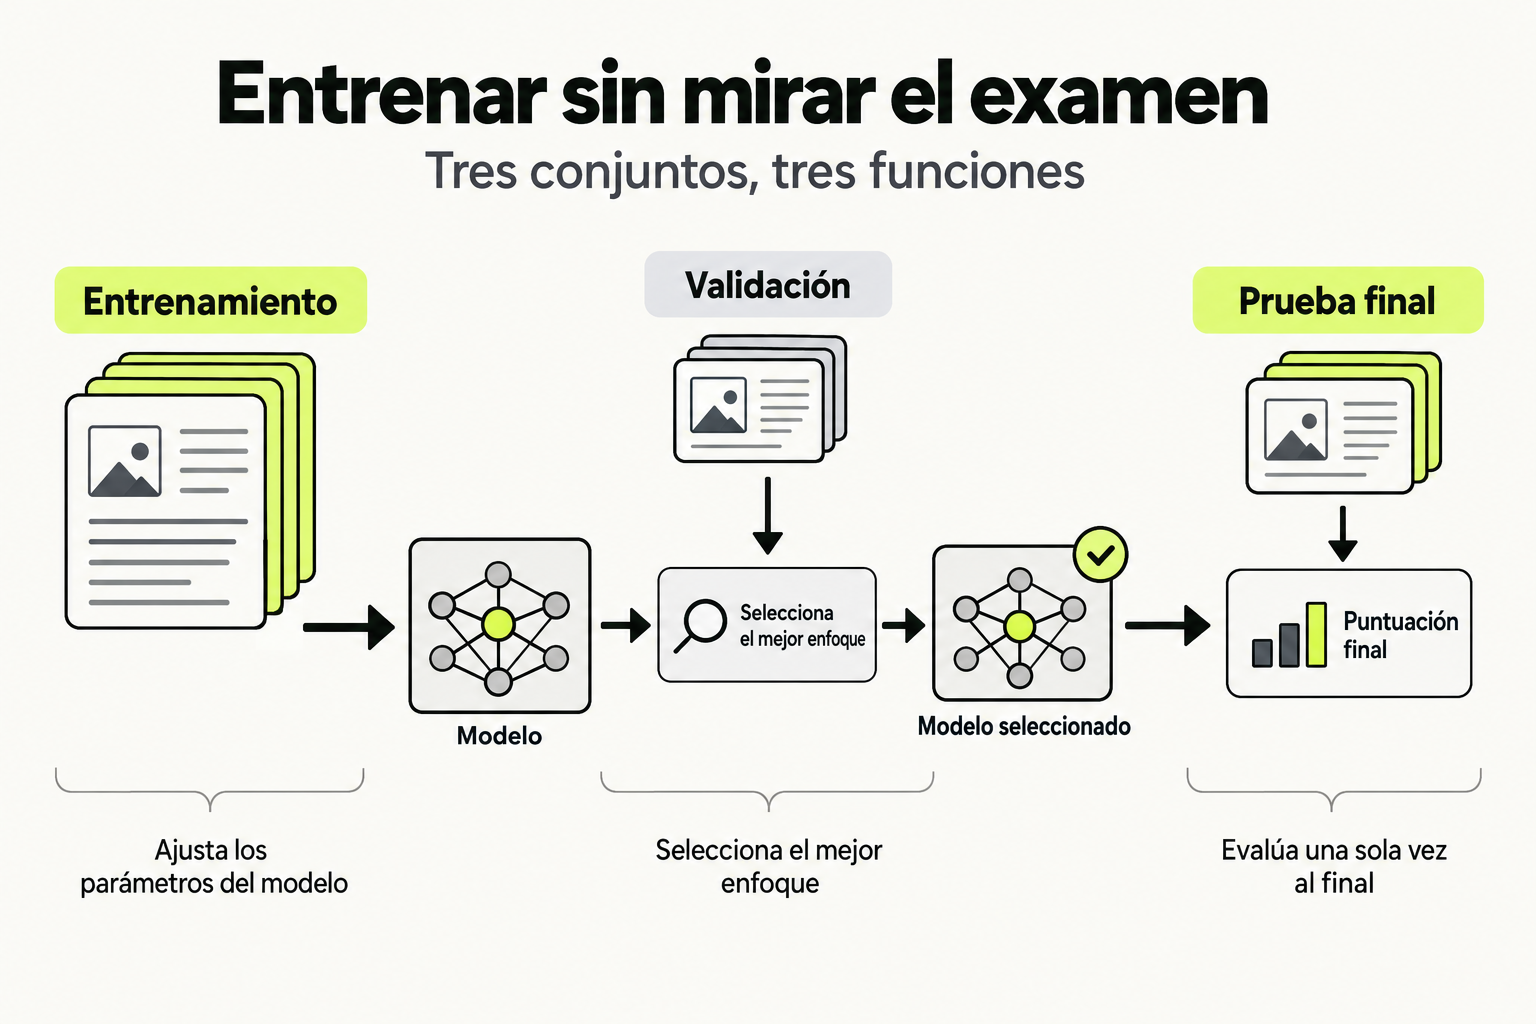
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Compara sistemas con un protocolo común
En boosting se construye una secuencia de modelos que corrige errores del conjunto previo. XGBoost, LightGBM y CatBoost ofrecen implementaciones distintas con parámetros y tratamiento de datos propios. Que un nombre aparezca en una competencia no significa que sea el mejor para tu tabla o tu presupuesto.
Ejemplo de protocolo: churn ficticio
Usa la definición y fecha de corte de la lección de preparación. Congela entrenamiento, validación y test antes de comparar. No incluyas cancelaciones futuras ni identificadores que memoricen cuentas. Empieza por una referencia como DummyClassifier y una regresión logística antes de buscar una diferencia entre bibliotecas.
| Decisión | Qué mantener comparable |
|---|---|
| Separación | Las mismas filas y ventana temporal |
| Métrica | La misma definición y clase positiva |
| Presupuesto | Tiempo y número de configuraciones registrados |
| Categorías | Tratamiento descrito y ajustado con entrenamiento |
| Test | Reservado hasta terminar las decisiones de validación |
Modelo de referencia para la práctica
from sklearn.dummy import DummyClassifier
from sklearn.metrics import balanced_accuracy_score

referencia = DummyClassifier(strategy="most_frequent")
# Usa conjuntos ya preparados y separados, no toda la tabla.
# referencia.fit(X_train, y_train)
# predicciones = referencia.predict(X_valid)
# valor = balanced_accuracy_score(y_valid, predicciones)
El fragmento prepara una referencia; no contiene un benchmark ejecutado. Para las tres bibliotecas, revisa su API instalada antes de copiar parámetros de early stopping. Declara un conjunto de validación separado y documenta dónde se usó. No escojas parámetros mirando el resultado final del test.
Preguntas para elegir con criterio
- ¿Qué ocurre con las categorías y los valores faltantes en tu configuración?
- ¿Una mejora pequeña compensa el tiempo, memoria y complejidad añadidos?
- ¿El resultado se mantiene al cambiar una semilla o un período de validación?
- ¿Puedes explicar falsos positivos y falsos negativos para la decisión del negocio?
- ¿El ajuste dependió de variables que no estarán disponibles al predecir?
Práctica y entregable
- Escribe un protocolo de una página antes de ejecutar.
- Entrena la referencia y una configuración sencilla de cada biblioteca que puedas instalar.
- Registra versión, parámetros, tiempo observado y métrica real; si no ejecutaste una biblioteca, márcala como pendiente.
- Elige una opción con sus limitaciones, sin presentar esa decisión como ranking general.
- Evalúa una sola vez la opción final con el test reservado.
Entrega la tabla de resultados y el protocolo. Ninguna cifra de precisión o velocidad se promete en esta lección: depende de los datos, la configuración y el entorno que tú registres.
Referencias para comprobar la implementación
Documentación consultada el 2 de octubre de 2026. Comprueba también las versiones y condiciones de tu proyecto.
Sigue con Machine Learning Práctico con Scikit-Learn
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.