

Lección 7 de 19 · Lectura y práctica
Entrenamiento y evaluación del modelo con RLHF
Concepto claveEl entrenamiento con RLHF (Reinforcement Learning from Human Feedback) transforma un modelo de lenguaje base en uno alineado con preferencias humanas mediante un proceso de tres fases: recolección de datos de.
Del concepto a la práctica
Taller de esta lección
Entrenar y evaluar son fases distintas. Durante RLHF puedes observar recompensa, pérdida y divergencia, pero la evaluación final debe usar prompts no vistos y criterios independientes. Una recompensa creciente puede ocultar que la política repite frases cortas o explota una señal superficial. Por eso conviene comparar también formato, utilidad y respuestas inseguras.
Ejemplo resuelto
En una tabla ficticia de 10 prompts de prueba, la línea base cumple formato en 6 y la variante en 8. Si la variante inventa datos en 3 casos y la base en 1, el aumento de formato no basta para declararla mejor.
Pruébalo
Congela diez prompts fuera del entrenamiento.
Cuenta aciertos de formato y errores de invención.
Calcula cada proporción sobre los diez casos.
Describe el intercambio observado.
Comprueba tu resultado
Formato: base 60%, variante 80%; invención: base 10%, variante 30%.
Error frecuente: reportar solo la recompensa media. Corrección: presenta métricas separadas y ejemplos de fallo; una mejora parcial requiere explicar el coste de seguridad.
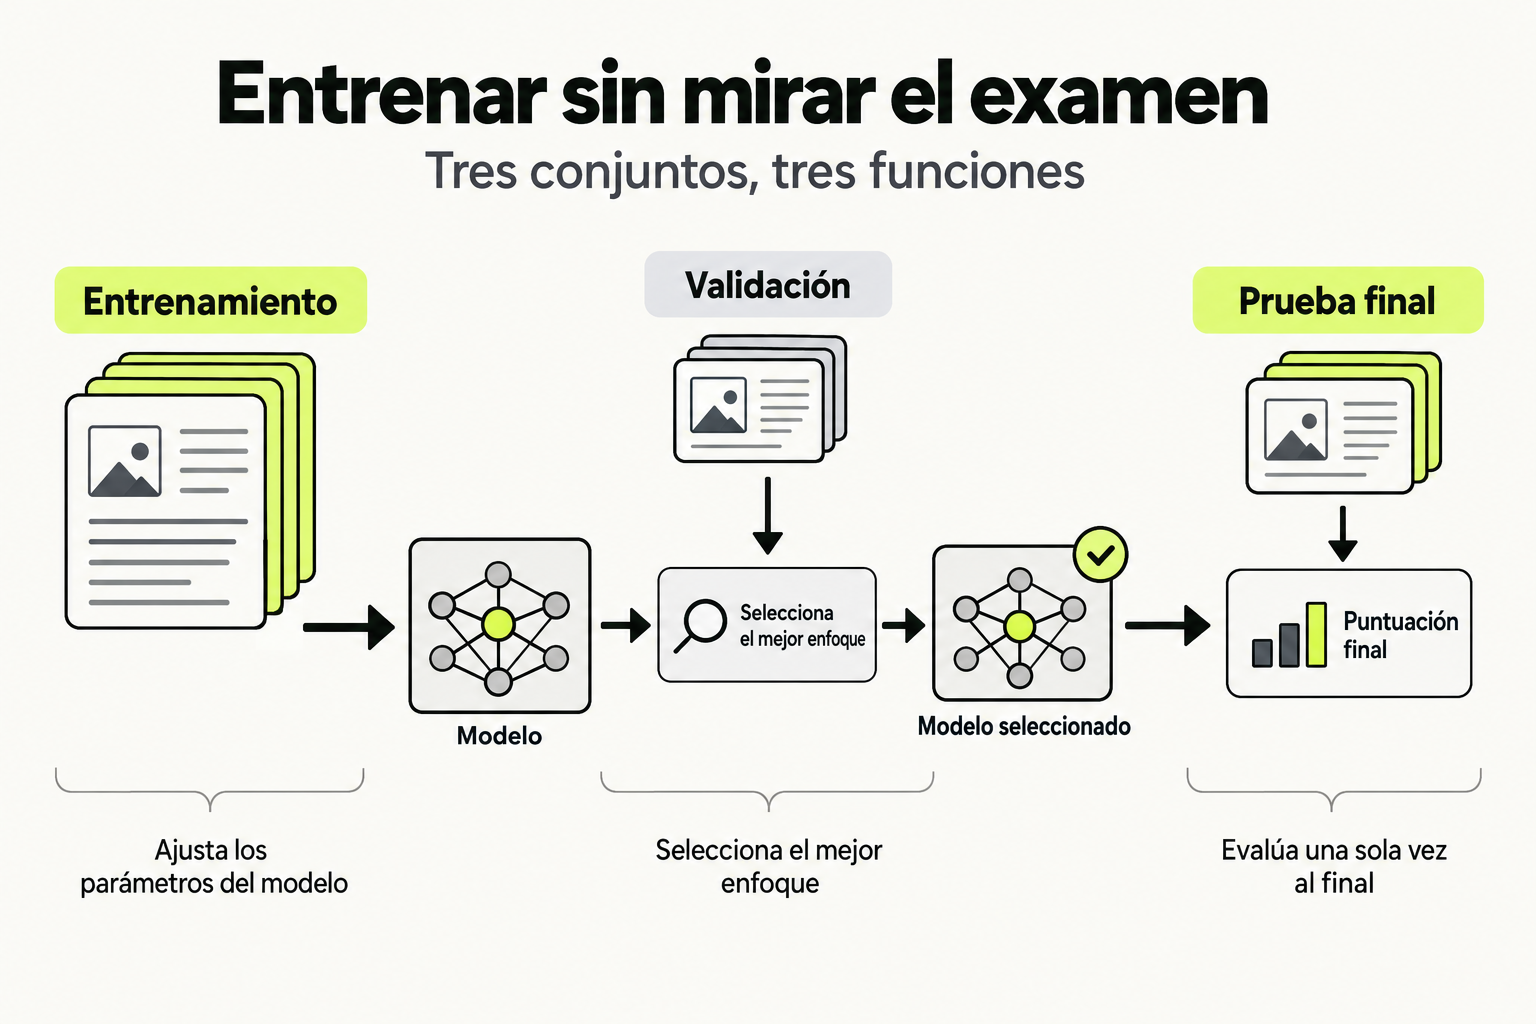
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Concepto clave
El entrenamiento con RLHF (Reinforcement Learning from Human Feedback) transforma un modelo de lenguaje base en uno alineado con preferencias humanas mediante un proceso de tres fases: recolección de datos de preferencia, entrenamiento de un modelo de recompensa y optimización del modelo de política con aprendizaje por refuerzo. Imagina que estás entrenando a un asistente virtual: primero observas cómo responde a preguntas, luego calificas sus respuestas, y finalmente ajustas su comportamiento para que priorice las respuestas que tú prefieres.
La optimización utiliza algoritmos como PPO (Proximal Policy Optimization), que actualiza la política del modelo manteniéndose cerca de la versión anterior para evitar cambios bruscos que degraden el rendimiento. Es similar a afinar un instrumento musical: haces ajustes pequeños y medidos en lugar de cambios radicales que podrían desafinarlo completamente.
Cómo funciona en la práctica
Implementar RLHF requiere una tubería de datos y modelos interconectados. Sigue estos pasos:
- Preparación del modelo base: Carga un modelo preentrenado (ej. Llama 3) y congela capas iniciales para eficiencia.
- Generación de respuestas: Usa el modelo para producir múltiples respuestas a un conjunto de prompts, típicamente con muestreo estocástico.
- Evaluación con el modelo de recompensa: Pasa cada par (prompt, respuesta) por un modelo de recompensa entrenado previamente para obtener scores numéricos.
- Optimización con PPO: Calcula la pérdida de política usando la ventaja estimada y actualiza los parámetros del modelo.
- Validación: Evalúa el modelo en un conjunto de validación para monitorear métricas como perplexity y calidad de respuestas.
Un ejemplo concreto en código Python simplificado:
import torch
from transformers import AutoModelForCausalLM
from trl import PPOTrainer

# 1. Cargar modelo
model = AutoModelForCausalLM.from_pretrained('meta-llama/Llama-3-8B')

# 2. Configurar PPO
trainer = PPOTrainer(model=model, ...)

# 3. Bucle de entrenamiento
for batch in dataloader:
    # Generar respuestas
    outputs = model.generate(batch['input_ids'])

    # Obtener recompensas del modelo de recompensa
    rewards = reward_model(outputs)

    # Optimizar con PPO
    loss = trainer.step(outputs, rewards)
Caso de estudio
Considera el ajuste de un modelo para generar respuestas de soporte técnico más útiles y concisas. Partimos de un modelo base como Mistral 7B y un dataset de 10,000 ejemplos de conversaciones de soporte con preferencias humanas (ej., "respuesta A es mejor que B").
| Fase | Métrica | Valor inicial | Valor final |
|---|---|---|---|
| Entrenamiento de recompensa | Accuracy en preferencias | 65% | 89% |
| Optimización RLHF | Longitud promedio de respuesta | 152 tokens | 98 tokens |
| Evaluación humana | Preferencia sobre modelo base | - | 72% |
El modelo ajustado redujo la longitud de las respuestas en un 35% mientras mantuvo o mejoró la precisión técnica, demostrando la efectividad de RLHF para alinear el output con criterios específicos.
Errores comunes
- Desalineación de la recompensa: El modelo de recompensa sobreoptimiza métricas proxy (ej., longitud) en lugar de la calidad real. Solución: Validar con evaluaciones humanas periódicas y ajustar la función de recompensa.
- Inestabilidad del entrenamiento: PPO puede divergir si la tasa de aprendizaje es muy alta. Solución: Usar learning rate bajo (ej., 1e-6) y monitorear la pérdida de KL para mantenerla dentro de un rango.
- Sobreespecialización: El modelo pierde capacidades generales al optimizar para un dominio muy específico. Solución: Incluir una pérdida de pre-entrenamiento (ej., mezclar con pérdida de lenguaje) y usar datasets diversos.
- Ignorar el costo computacional: RLHF requiere múltiples pases forward/backward por ejemplo. Solución: Usar técnicas como gradient checkpointing y ajustar el tamaño de batch según los recursos disponibles.
Checklist de dominio
- ¿Puedes explicar la diferencia entre el modelo de política y el modelo de recompensa en RLHF?
- ¿Has implementado un bucle de entrenamiento PPO desde cero o usando librerías como TRL?
- ¿Sabes cómo balancear la pérdida de recompensa con la pérdida de KL para evitar divergencia?
- ¿Puedes diseñar un pipeline para recolectar y procesar datos de preferencia humana?
- ¿Has evaluado un modelo ajustado con RLHF usando métricas cuantitativas y cualitativas?
- ¿Entiendes cómo ajustar hiperparámetros clave (learning rate, clip range) para estabilidad?
- ¿Puedes debuggear problemas comunes como recompensas planas o overfitting?
Implementa un ciclo basico de RLHF con PPO en un modelo pequeño
En este ejercicio, ajustaras un modelo GPT-2 pequeño usando RLHF para mejorar la concision de sus respuestas. Sigue estos pasos:
- Configuracion inicial: Instala las librerias necesarias: transformers, torch, trl, datasets. Carga el modelo 'gpt2' y un dataset de prompts simples (ej., 'Hola, como estas?').
- Simulacion del modelo de recompensa: Crea una funcion que asigne una recompensa mas alta a respuestas cortas (menos de 20 tokens) y mas baja a respuestas largas. Esto simula un modelo de recompensa entrenado para preferir concision.
- Implementacion del bucle PPO: Usa PPOTrainer de TRL para optimizar el modelo. Configura hiperparametros: learning rate=1.1e-5, batch size=4, epochs=3. En cada iteracion:
- Genera 2 respuestas por prompt usando model.generate() con temperatura=0.7.
- Calcula recompensas con tu funcion simulada.
- Ejecuta trainer.step() con las respuestas y recompensas.
- Evaluacion: Antes y despues del entrenamiento, genera respuestas a 5 prompts de prueba y compara la longitud promedio en tokens. Verifica que haya disminuido.
- Documentacion: Registra las metricas (perdida, recompensa promedio, longitud) y guarda el modelo ajustado.
Pistas
- Usa el parametro max_new_tokens en generate() para limitar la longitud de las respuestas y hacer el ejercicio mas manejable.
- Monitorea la perdida de KL durante el entrenamiento; si supera 0.1, reduce el learning rate.
- Para respuestas mas variadas, experimenta con diferentes valores de temperatura en el muestreo.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.