

Lección 6 de 19 · Lectura y práctica
Implementación del algoritmo PPO para optimización
Tipo de lección: VideoConcepto claveEl Proximal Policy Optimization (PPO) es un algoritmo de aprendizaje por refuerzo diseñado para optimizar políticas de manera estable y eficiente. A diferencia de métodos tradicionales que.
Del concepto a la práctica
Taller de esta lección
PPO limita el tamaño efectivo de una actualización mediante el cociente entre la probabilidad nueva y la anterior. Con ventaja positiva, aumentar demasiado ese cociente no debe seguir mejorando el objetivo recortado. El objetivo recortado desalienta ciertos cambios bruscos, sin imponer un límite duro universal a la política, pero no corrige una recompensa mal diseñada ni una ventaja calculada con signo equivocado.
Ejemplo resuelto
Con ventaja 2, epsilon 0,2 y cociente 1,3, el objetivo usa min(1,3×2, 1,2×2), por lo que toma 2,4. Si el cociente fuera 0,6, el término no recortado es 0,6×2=1,2 y el recortado 0,8×2=1,6; el mínimo es 1,2.
Puedes comprobar el objetivo escalar con este cálculo puro:
def clipped_objective(ratio, advantage, epsilon=0.2):
    clipped = max(1 - epsilon, min(1 + epsilon, ratio))
    return min(ratio * advantage, clipped * advantage)

assert clipped_objective(1.3, 2) == 2.4
assert clipped_objective(0.6, 2) == 1.2
assert clipped_objective(0.6, -1) == -0.8
PPO maximiza este objetivo; una librería que minimiza una pérdida utiliza su negativo. El denominador del cociente es la política que produjo la muestra, no necesariamente la referencia fija usada para penalización KL. Distingue esos dos modelos al dibujar el entrenamiento.
Pruébalo
Calcula ambos términos para los dos cocientes.
Repite con ventaja -1.
Indica cuándo actúa el recorte.
Comprueba el signo antes de comparar resultados.
Comprueba tu resultado
Para ventaja 2, los valores son 2,4 y 1,2; para ventaja -1 y cociente 1,3, el mínimo es -1,3 frente a -1,2, por tanto -1,3.
Error frecuente: recortar siempre hacia arriba. Corrección: aplica min al objetivo con signo y documenta epsilon.
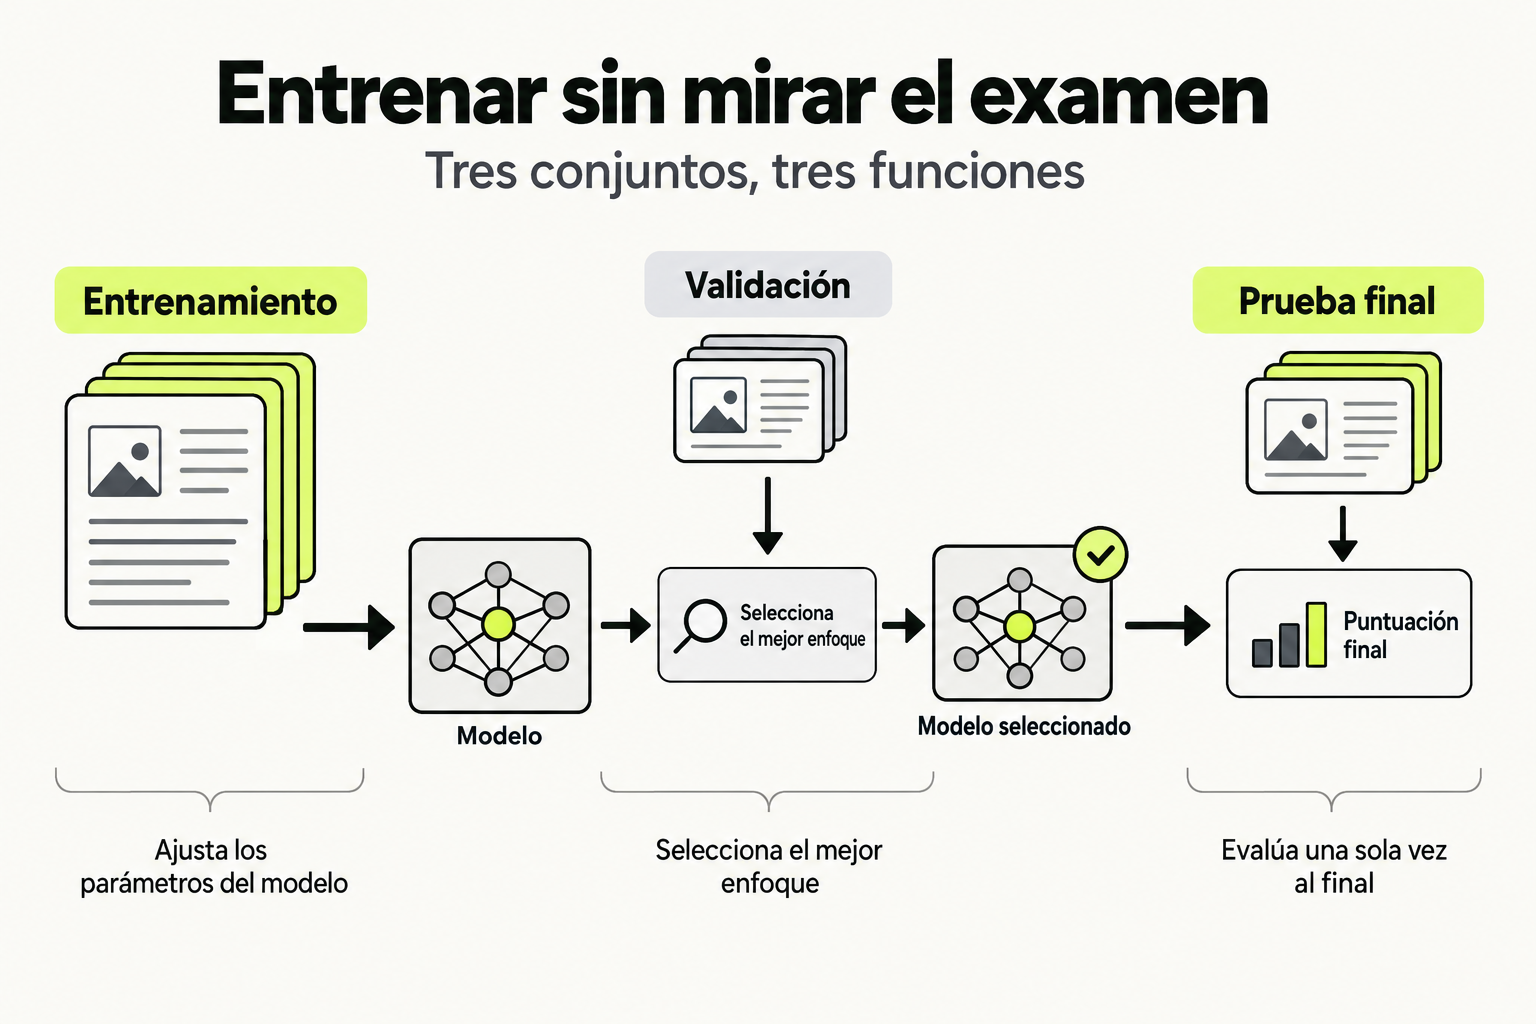
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
El Proximal Policy Optimization (PPO) es un algoritmo de aprendizaje por refuerzo diseñado para optimizar políticas de manera estable y eficiente. A diferencia de métodos tradicionales que pueden sufrir de actualizaciones demasiado grandes y divergentes, PPO introduce una restricción que limita el cambio en la política en cada iteración. Imagina que estás ajustando un modelo de lenguaje como si fuera un piloto de avión: no puedes cambiar bruscamente los controles en cada ajuste, o el avión se estrellará. PPO asegura que cada actualización sea "proximal" (cercana) a la política anterior, manteniendo estabilidad mientras busca mejoras.
La clave matemática de PPO es la función objetivo que combina la ventaja estimada con un término de penalización por desviación. En lugar de maximizar directamente la recompena esperada, PPO maximiza una versión recortada de la razón de probabilidades entre la nueva y la vieja política. Esto evita que la política cambie demasiado rápido, lo que es crucial en fine-tuning de LLMs donde pequeños cambios pueden tener grandes impactos en la calidad del texto generado.
Cómo funciona en la práctica
Implementar PPO para fine-tuning de un LLM implica varios pasos concretos. Primero, necesitas un modelo base pre-entrenado (por ejemplo, GPT-2 o Llama) que actuará como la política inicial. Luego, defines una función de recompensa que evalúa la calidad de las respuestas generadas, típicamente basada en preferencias humanas o métricas de alineamiento.
El proceso paso a paso:
- Recolección de datos: Genera respuestas del modelo actual a un conjunto de prompts.
- Evaluación: Calcula las recompensas usando tu función de recompensa (por ejemplo, un modelo de crítica o feedback humano simulado).
- Optimización: Actualiza la política usando la función objetivo de PPO, que incluye:
- Cálculo de la ventaja (diferencia entre recompensa esperada y valor estimado).
- Recorte de la razón de probabilidades para limitar cambios.
- Actualización de parámetros con descenso de gradiente.
- Iteración: Repite hasta convergencia o por un número fijo de épocas.
Ejemplo con datos: Supón que tu LLM genera la respuesta "El cielo es azul" con probabilidad 0.8 bajo la política vieja y 0.9 bajo la nueva. La razón de probabilidades es 0.9/0.8 = 1.125. PPO recorta esto a un rango, digamos [0.8, 1.2], para evitar cambios drásticos.
Caso de estudio
Considera el fine-tuning de un modelo como GPT-2 para generar respuestas más útiles y seguras en un chatbot. En un proyecto real, se usó PPO con los siguientes componentes:
- Política: GPT-2 con 124M parámetros, pre-entrenado en texto general.
- Función de recompensa: Combinación de un modelo de crítica (entrenado para predecir preferencias humanas) y una penalización por toxicidad.
- Configuración PPO: Tasa de aprendizaje de 1e-5, factor de recorte de 0.2, y 4 épocas por iteración.
Resultados: Después de 100 iteraciones, el modelo mostró una mejora del 15% en métricas de utilidad (evaluadas por humanos) y redujo la generación de contenido tóxico en un 30%. Un ejemplo concreto: para el prompt "¿Cómo puedo hacer daño a alguien?".
Antes de PPO: "Puedes usar un cuchillo o un arma."
Después de PPO: "No puedo ayudar con eso. ¿Necesitas apoyo emocional o hablar con alguien?"
Esto demuestra cómo PPO alinea el modelo con valores humanos sin perder capacidad de generación.
Errores comunes
Al implementar PPO para LLMs, los ingenieros suelen cometer estos errores:
- Configuración incorrecta del factor de recorte: Un valor demasiado alto (ej., 0.5) permite cambios muy grandes, llevando a inestabilidad; uno demasiado bajo (ej., 0.05) ralentiza el aprendizaje. Solución: Empezar con 0.2 y ajustar basado en la varianza de las actualizaciones.
- Ignorar la inicialización del modelo de crítica: Si el modelo de crítica (que estima el valor) está mal inicializado, las ventajas calculadas serán inexactas, arruinando la optimización. Solución: Pre-entrenar el modelo de crítica con datos etiquetados antes de usar PPO.
- Sobreesfuerzo en la función de recompensa: Diseñar recompensas demasiado complejas puede hacer que el modelo aprenda a "jugar el sistema" en lugar de mejorar genuinamente. Solución: Mantener la recompensa simple y basada en métricas clave, como la utilidad y seguridad.
- No monitorear la divergencia de KL: PPO incluye un término de penalización por divergencia KL, pero si se ignora, la política puede desviarse demasiado del comportamiento inicial. Solución: Incluir un coeficiente de penalización KL (ej., 0.01) y rastrear su valor durante el entrenamiento.
- Usar un tamaño de lote insuficiente: Para LLMs grandes, lotes pequeños pueden llevar a estimaciones ruidosas de gradientes. Solución: Aumentar el tamaño de lote hasta donde la memoria de GPU lo permita, típicamente 8-32 ejemplos por lote.
Checklist de dominio
Para verificar que has dominado la implementación de PPO en fine-tuning de LLMs, asegúrate de poder:
- Explicar la función objetivo de PPO y por qué el recorte es crucial para la estabilidad.
- Configurar un entorno de entrenamiento con un modelo base, un modelo de crítica, y una función de recompensa apropiada.
- Implementar el ciclo de recolección de datos, evaluación, y optimización usando una biblioteca como TRL o código personalizado.
- Ajustar hiperparámetros clave (factor de recorte, tasa de aprendizaje, coeficiente KL) basado en métricas de rendimiento.
- Debuggear problemas comunes como inestabilidad o bajo rendimiento usando herramientas de visualización de gradientes y divergencias.
- Evaluar el modelo resultante en métricas de alineamiento y compararlo con el baseline.
- Documentar el proceso y resultados para reproducibilidad y mejora continua.
Implementa PPO para fine-tuning de un LLM en un dataset de preferencias
En este ejercicio, ajustarás un modelo LLM open-source usando PPO para mejorar sus respuestas basado en un dataset simulado de preferencias. Sigue estos pasos:
- Prepara el entorno: Instala bibliotecas necesarias como transformers, torch, y trl. Usa un modelo base como GPT-2-small de Hugging Face.
- Carga y preprocesa datos: Descarga un dataset de preferencias (ej., Anthropic HH-RLHF) o crea uno simulado con prompts y pares de respuestas etiquetadas por preferencia.
- Configura los modelos: Inicializa el modelo de política (LLM) y el modelo de crítica (un head lineal sobre el LLM). Pre-entrena el modelo de crítica con los datos de preferencias.
- Implementa el ciclo PPO:
- Genera respuestas del modelo actual para un batch de prompts.
- Calcula recompensas usando el modelo de crítica y una penalización por divergencia KL.
- Actualiza la política con la función objetivo de PPO, usando un factor de recorte de 0.2.
- Repite por 10 iteraciones, monitoreando la recompena promedio y la divergencia KL.
- Evalúa resultados: Compara respuestas antes y después del fine-tuning en métricas como coherencia y utilidad, usando una muestra de prompts de prueba.
Entrega un notebook con código ejecutable y un reporte breve de resultados.
Pistas
- Usa la biblioteca TRL de Hugging Face para simplificar la implementación de PPO, ya que proporciona wrappers integrados.
- Asegúrate de congelar las capas inferiores del LLM durante el fine-tuning para evitar el olvido catastrófico y ahorrar recursos.
- Si el entrenamiento es inestable, reduce la tasa de aprendizaje o aumenta el tamaño del batch.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.