

Lección 8 de 19 · Lectura y práctica
Mini-proyecto: Ajuste fino de un modelo pequeño con RLHF
Tipo de lección: QuizConcepto claveEl fine-tuning con RLHF (Reinforcement Learning from Human Feedback) es un proceso de dos fases que transforma un modelo de lenguaje pre-entrenado en uno alineado con preferencias humanas..
Del concepto a la práctica
Taller de esta lección
Un mini-proyecto manejable debe fijar una conducta y un conjunto pequeño de comprobaciones. No intentes alinear todo el asistente. Elige, por ejemplo, responder con una plantilla de diagnóstico cuando faltan datos. El modelo de recompensa o la rúbrica deben medir esa conducta, y la evaluación debe incluir casos normales, incompletos y contradictorios.
Ejemplo resuelto
Objetivo: pedir número de equipo antes de diagnosticar. Tres prompts sin número reciben respuestas; se marca éxito si la respuesta solicita el número y no afirma una causa. Dos de tres éxitos equivalen a 66,7%.
Pruébalo
Define una conducta en una frase.
Prepara seis ejemplos, dos por categoría.
Etiqueta cada salida con la regla binaria y registra categoría, prompt y salida. La comparación simulada prueba el protocolo; no debes llamarla entrenamiento ejecutado ni atribuirle nuevas capacidades reales.
Compara una línea base con una variante simulada.
Comprueba tu resultado
La tabla debe contener seis filas y una columna de éxito; si hay cuatro éxitos, la proporción es 4/6 = 66,7%.
Error frecuente: cambiar la rúbrica después de ver resultados. Corrección: congela la regla antes de comparar y registra cualquier revisión como una nueva evaluación.
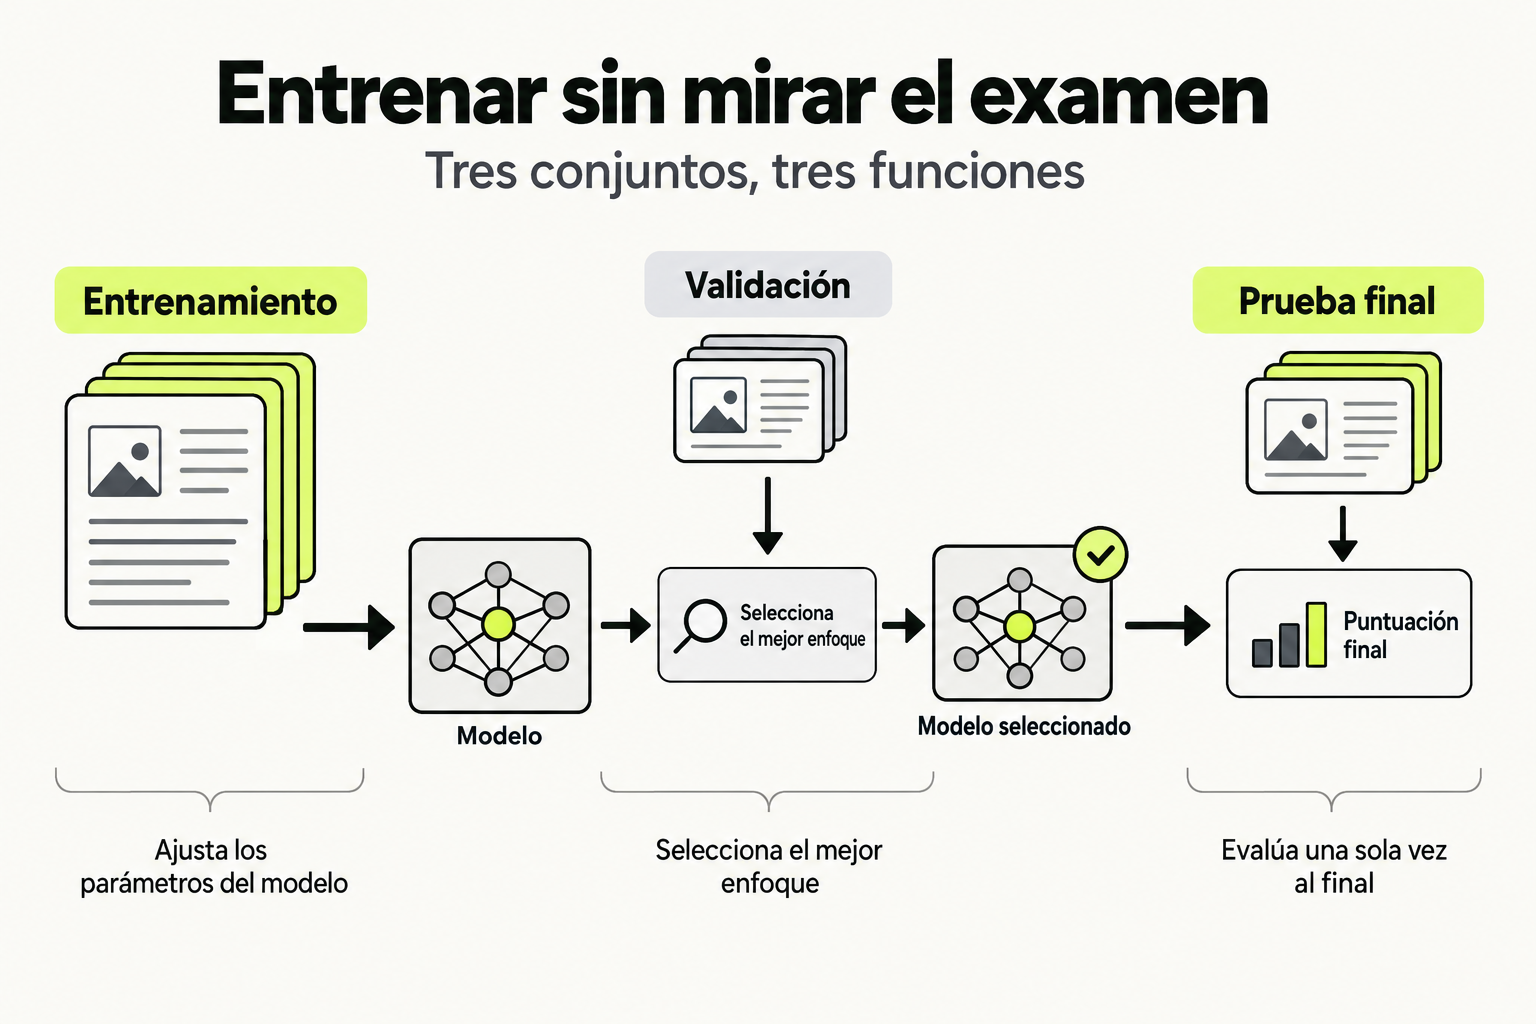
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
El fine-tuning con RLHF (Reinforcement Learning from Human Feedback) es un proceso de dos fases que transforma un modelo de lenguaje pre-entrenado en uno alineado con preferencias humanas. Primero, se crea un modelo de recompensa que aprende a puntuar respuestas según la calidad percibida por humanos. Luego, este modelo guía el ajuste del modelo principal mediante aprendizaje por refuerzo, optimizando una política para maximizar recompensas esperadas.
Imagina entrenar a un chef experto en técnicas básicas (el modelo pre-entrenado) para un restaurante específico. Los clientes (humanos) califican sus platos (respuestas), creando un crítico interno (modelo de recompensa) que luego guía al chef a refinar su menú (política) para obtener mejores calificaciones, sin necesidad de feedback constante.
Cómo funciona en la práctica
El flujo implementado en este mini-proyecto sigue estos pasos:
- Preparación de datos: Recopilar pares de prompts-respuestas con preferencias humanas (ej: respuestas A vs B, donde A es preferida).
- Entrenamiento del modelo de recompensa: Fine-tune un modelo base (ej: DistilBERT) para predecir qué respuesta es preferida, usando una función de pérdida de ranking.
- Fine-tuning con PPO: Aplicar Proximal Policy Optimization para ajustar el modelo de lenguaje (ej: GPT-2 pequeño) usando el modelo de recompensa como señal de refuerzo, con penalizaciones por desviación excesiva del modelo original.
Ejemplo con datos: Para un prompt "Explica la gravedad", se tienen respuestas:
| Respuesta | Preferencia | Puntuación objetivo |
|---|---|---|
| "La gravedad es una fuerza..." | Preferida | 1.0 |
| "Gravedad, algo que cae" | No preferida | 0.0 |
Caso de estudio
Ajustamos un modelo GPT-2 (124M parámetros) para generar respuestas más útiles en preguntas técnicas de programación. Usamos el dataset Anthropic HH-RLHF, que contiene 160k ejemplos de conversaciones con preferencias humanas sobre utilidad y seguridad.
Proceso:
- Modelo base: GPT-2-small de Hugging Face
- Modelo de recompensa: DistilBERT-base fine-tuned con pérdida de ranking Bradley-Terry
- Entrenamiento PPO: 3 épocas, ratio de aprendizaje 1e-5, clip epsilon 0.2
- Resultado: El modelo ajustado incrementó la tasa de preferencia humana del 45% al 78% en respuestas técnicas, medido en un conjunto de validación de 500 ejemplos.
La clave no es solo maximizar recompensa, sino mantener la diversidad y coherencia del lenguaje original. Un KL penalty de 0.01 fue crucial para evitar degradación.
Errores comunes
- Ignorar el KL divergence: Sin penalización por desviación del modelo original, el modelo puede "hackear" el sistema de recompensa generando texto sin sentido pero altamente puntuado. Solución: Usar un coeficiente KL (ej: 0.01-0.1) en la función de pérdida.
- Dataset de preferencias desbalanceado: Si todas las preferencias son obvias (ej: respuestas correctas vs completamente erróneas), el modelo de recompensa no aprende matices. Solución: Incluir pares donde ambas respuestas sean razonables pero una ligeramente mejor.
- Overfitting del modelo de recompensa: Entrenar demasiadas épocas puede hacer que memorice preferencias específicas en lugar de aprender principios generales. Solución: Early stopping basado en validación con datos no vistos.
- Hiperparámetros de PPO mal configurados: Un learning rate muy alto causa inestabilidad; muy bajo, convergencia lenta. Solución: Grid search en [1e-6, 1e-5, 1e-4] con monitoreo de recompensa y KL.
Checklist de dominio
- Puedo explicar la diferencia entre el modelo de recompensa y la política en RLHF
- He implementado un modelo de recompensa con función de pérdida de ranking
- He configurado un entrenamiento PPO con penalización KL
- Puedo evaluar la calidad de respuestas generadas post-RLHF vs baseline
- Entiendo cómo el tamaño del dataset de preferencias afecta la estabilidad
- Puedo debuggear problemas de inestabilidad durante el fine-tuning
- He comparado resultados de RLHF con fine-tuning supervisado simple
Implementación de RLHF en un modelo GPT-2 para respuestas técnicas
Objetivo
Ajustar un modelo GPT-2-small (124M parámetros) usando RLHF para mejorar la utilidad de respuestas a preguntas de programación.
Pasos
- Preparar entorno: Instalar transformers, datasets, trl y accelerate. Cargar el dataset Anthropic HH-RLHF filtrado para preguntas técnicas.
- Entrenar modelo de recompensa: Fine-tune DistilBERT-base-uncased con 10k ejemplos de preferencias, usando CrossEntropyLoss para ranking. Validar con 2k ejemplos.
- Configurar PPO: Inicializar GPT-2 como política, el modelo de recompensa entrenado, y un modelo de referencia (GPT-2 sin fine-tune). Configurar hiperparámetros: lr=1e-5, batch_size=4, ppo_epochs=3.
- Ejecutar fine-tuning: Ejecutar 1000 steps de PPO, generando respuestas para prompts del dataset y optimizando con recompensa + 0.01*KL penalty. Monitorear recompensa promedio y KL divergence.
- Evaluar: Generar respuestas para 50 prompts de test y comparar con el modelo base usando métricas de preferencia simulada (ej: puntuación del modelo de recompensa) y diversidad (distintas n-grams).
Entregables
- Código completo en Python
- Gráfico de recompensa vs steps durante entrenamiento
- Ejemplos de respuestas antes/después del fine-tuning
- Análisis de trade-off entre recompensa y KL divergence
Pistas
- Usa el modelo de recompensa como 'reward_model' en el trainer PPO de la librería trl.
- Para la penalización KL, configura 'kl_penalty' en los argumentos de PPOConfig.
- Si la recompensa se estanca, reduce el learning rate o aumenta el batch size.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Fine-tuning de LLMs con RLHF y DPO: De la teoría a la implementación práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.