

Lección 15 de 20 · Lectura y práctica
Quiz: Integración de Pipelines
Tipo de lección: QuizConcepto claveLa integración de ML pipelines con Docker y Kubernetes consiste en empaquetar cada etapa de tu flujo de machine learning (preprocesamiento, entrenamiento, inferencia) en contenedores.
Del concepto a la práctica
Taller de esta lección
Integrar un pipeline significa preservar el contrato al cambiar de ejecución local a contenedores y Jobs. La pregunta esencial es qué archivo, código de salida y dependencia permiten a la siguiente etapa saber si puede comenzar.
Ejemplo resuelto
preprocess produce features.csv con tres filas; train produce model.joblib; serve solo inicia si ambos existen. Si features.csv tiene dos columnas y el modelo espera tres, la integración debe fallar durante la validación del esquema, antes de atender solicitudes.
Pruébalo
Define columnas
usuario,item,puntuaciony sus tipos.Ejecuta la validación antes del entrenamiento.
Introduce una fila sin
puntuaciony observa el código de error.Corrige la fila y repite el recorrido.
Error frecuente: confiar en que el nombre del archivo garantiza compatibilidad. Corrección: valida columnas, tipos y cantidad mínima de registros.
Comprueba tu resultado
La fila incompleta debe detener el pipeline y no producir un modelo nuevo. Con las tres filas completas, deben aparecer features.csv y model.joblib, y el servicio debe iniciar sin advertencias de esquema.
Contrato con tres registros
usuario,item,puntuacion
u1,p3,5
u1,p2,4
u2,p1,3
Aquí usuario e item son identificadores de texto y puntuación un número finito entre1 y5. Vaciar puntuación de la segunda fila deja dos completas y una inválida; la política de esta prueba falla todo el lote y no produce un modelo nuevo. Restaurar4 permite tres filas y el artefacto con su esquema y versión.
Distingue columnas identificadoras de características numéricas: un modelo que espera tres características no es compatible por tener el CSV tres columnas si dos son IDs sin codificar. Especifica su transformación y guarda el transformador junto con el modelo. Jobs independientes requieren un orquestador que haga cumplir orden y éxito; replicas de inferencia requieren compartir un artefacto inmutable compatible, sin que el HPA aparezca automáticamente por aumentar tráfico.
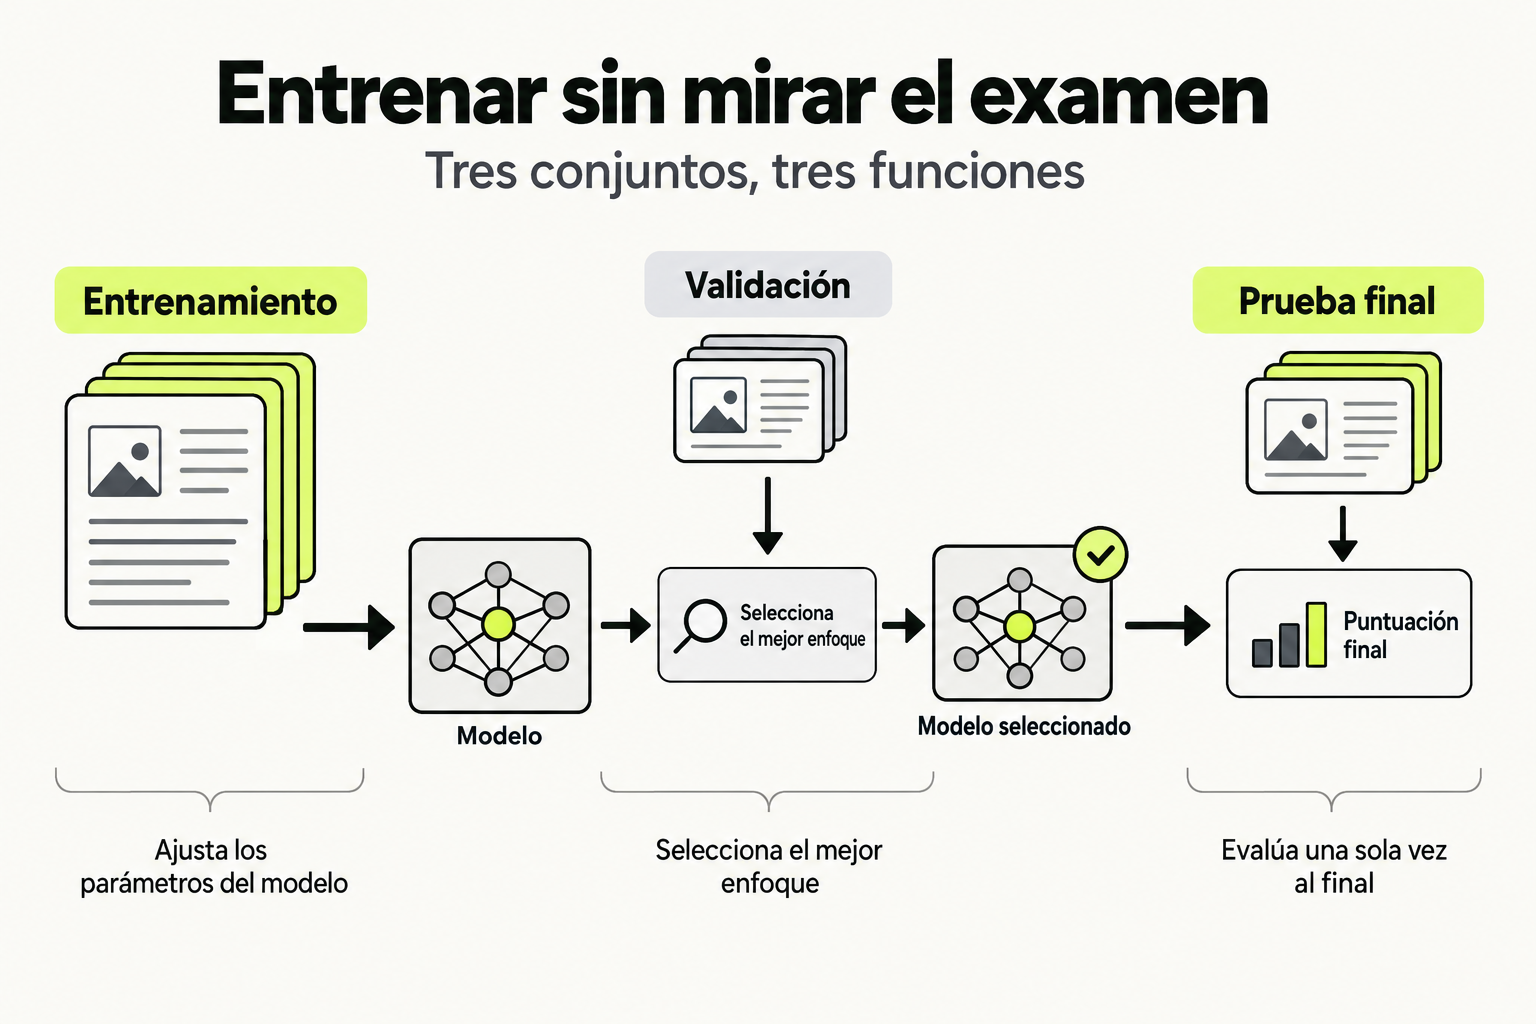
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
La integración de ML pipelines con Docker y Kubernetes consiste en empaquetar cada etapa de tu flujo de machine learning (preprocesamiento, entrenamiento, inferencia) en contenedores independientes y orquestarlos para que se ejecuten de manera coordinada y escalable. Imagina una cadena de montaje en una fábrica: cada contenedor es una estación especializada (cortar, ensamblar, pintar) y Kubernetes es el supervisor que asegura que las piezas fluyan en el orden correcto y que haya suficientes estaciones trabajando.
Este enfoque transforma scripts monolíticos en servicios modulares. En lugar de un script Python gigante que hace todo, tienes microservicios que se comunican a través de APIs o sistemas de mensajería. La ventaja clave es la portabilidad: tu pipeline funciona igual en tu laptop, en un servidor o en la nube, porque cada contenedor lleva consigo todas sus dependencias.
Cómo funciona en la práctica
Vamos a desglosar un pipeline típico de clasificación de imágenes. Primero, defines las etapas: 1) Preprocesamiento (redimensionar, normalizar), 2) Entrenamiento del modelo CNN, 3) Servicio de inferencia. Cada etapa se convierte en un Dockerfile separado.
Paso 1: Creas un Dockerfile para preprocesamiento que incluye OpenCV y tu script de transformación. Paso 2: Construyes la imagen y la subes a un registro como Docker Hub. Paso 3: Defines un Job de Kubernetes para el entrenamiento y un Deployment para el servicio de inferencia. Paso 4: Usas un ConfigMap para almacenar hiperparámetros y un PersistentVolume para los datos de entrenamiento, asegurando que los contenedores accedan a la misma información.
Kubernetes ejecuta los Jobs en secuencia (puedes controlarlo con dependencias o scripts de shell) y mantiene el Deployment corriendo para servir predicciones. Si el tráfico aumenta, Kubernetes escala automáticamente el servicio de inferencia.
Codigo en accion
Ejemplo de Dockerfile para la etapa de preprocesamiento:
FROM python:3.9-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY preprocess.py .
CMD ["python", "preprocess.py", "--input", "/data/raw", "--output", "/data/processed"]
Ejemplo de definición de Job en Kubernetes (archivo YAML):
apiVersion: batch/v1
kind: Job
metadata:
  name: ml-training-job
spec:
  template:
    spec:
      containers:
      - name: trainer
        image: myregistry/ml-trainer:v1.0
        volumeMounts:
        - name: data-volume
          mountPath: /data
      volumes:
      - name: data-volume
        persistentVolumeClaim:
          claimName: ml-data-pvc
      restartPolicy: Never
Errores comunes
- Contenedores gigantes: Incluir librerías innecesarias en la imagen. Solución: Usa imágenes base minimalistas (como alpine) y multi-stage builds para reducir el tamaño.
- Acoplamiento fuerte entre etapas: Hacer que un contenedor dependa directamente de archivos locales de otro. Solución: Usa almacenamiento compartido (PersistentVolume) o colas de mensajes (como RabbitMQ) para desacoplar.
- Falta de manejo de errores: Si falla una etapa, el pipeline se detiene sin notificación. Solución: Implementa monitoreo con herramientas como Prometheus y define políticas de reinicio en Kubernetes.
- Variables de entorno hardcodeadas: Poner credenciales directamente en el Dockerfile. Solución: Usa Secrets de Kubernetes y pásalas como variables de entorno en tiempo de ejecución.
Checklist de dominio
- Puedo descomponer un script ML en al menos tres etapas independientes (ej: data prep, training, serving).
- Sé crear un Dockerfile para cada etapa, optimizando el tamaño de la imagen.
- Puedo definir un Job de Kubernetes para tareas batch (como entrenamiento) y un Deployment para servicios continuos (como inferencia).
- He configurado PersistentVolumes para compartir datos entre contenedores de forma persistente.
- Utilizo ConfigMaps y Secrets para gestionar configuración y credenciales sin hardcodear.
- Puedo orquestar la ejecución secuencial de Jobs usando scripts de shell o herramientas como Argo Workflows.
- Sé monitorear el pipeline con kubectl logs y métricas básicas de Kubernetes.
Containerización de un Pipeline de Clasificación de Texto
Transforma este script monolítico de clasificación de texto en un pipeline containerizado con Docker y Kubernetes. El script original (train_and_serve.py) hace todo: carga datos, entrena un modelo y sirve predicciones. Tu tarea es dividirlo en dos contenedores independientes.
- Paso 1: Analiza el script - Descarga el archivo train_and_serve.py desde el repositorio proporcionado. Identifica las secciones de preprocesamiento, entrenamiento y servicio.
- Paso 2: Crea dos Dockerfiles - Dockerfile.train: Debe incluir las partes de preprocesamiento y entrenamiento. Usa una imagen base de Python, copia los scripts necesarios y define un CMD que ejecute el entrenamiento. Dockerfile.serve: Debe contener solo el servicio de inferencia (por ejemplo, usando Flask).
- Paso 3: Construye y prueba localmente - Construye las imágenes:
docker build -t ml-trainer -f Dockerfile.train .ydocker build -t ml-server -f Dockerfile.serve .. Ejecuta el contenedor de entrenamiento con un volumen para los datos, luego el servidor. - Paso 4: Define recursos de Kubernetes - Crea tres archivos YAML: a) Un PersistentVolumeClaim para los datos. b) Un Job para el entrenamiento que use la imagen ml-trainer y monte el PVC. c) Un Deployment para el servidor que use la imagen ml-server y exponga un Service tipo NodePort.
- Paso 5: Despliega y verifica - Aplica los YAMLs con
kubectl apply -f. Verifica que el Job se complete y que el Deployment esté corriendo. Accede al servicio desde tu navegador para probar predicciones.
Pistas
- Divide el script original en dos archivos separados: train.py y serve.py, antes de crear los Dockerfiles.
- En el Job de Kubernetes, usa el campo 'restartPolicy: Never' para evitar reintentos infinitos si falla el entrenamiento.
- Para el servicio, asegúte de que el Deployment tenga al menos 2 réplicas para alta disponibilidad.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.