

Lección 14 de 20 · Lectura y práctica
Práctica: Crear un Pipeline End-to-end con Airflow y Kubernetes
Copia un paquete completo con CSV ficticio, validación, modelo base, DAG comprobado en Airflow 3.3.2, Dockerfile y Job de Kubernetes, con límites de ejecución claros.
Del concepto a la práctica
Taller de esta lección
Una práctica end-to-end debe separar evidencia local de ejecución orquestada. Un DAG o un Job escrito en un archivo no demuestra que sus tareas hayan corrido; la evidencia requiere entradas, salida, código de finalización y registros observables.
Ejemplo resuelto
Con importes de entrenamiento 100,200,150, el modelo constante calcula (100+200+150)/3=150. Para una fila de prueba 180, el error absoluto es |180-150|=30. La salida debe conservar ambos números y el identificador de ejecución.
Pruébalo
Guarda cuatro filas: tres de entrenamiento y una de prueba.
Ejecuta localmente lectura, cálculo y evaluación.
Empaqueta el mismo script en una imagen autorizada.
Ejecuta el Job solo si el clúster está disponible y registra su estado.
Error frecuente: afirmar que Kubernetes ejecutó el Job porque el manifiesto es válido. Corrección: distingue validación sintáctica de ejecución observada.
Comprueba tu resultado
La prueba local debe mostrar media 150 y error 30. Para el Job, aporta estado y logs reales; si no se ejecutó, marca esa parte como pendiente en vez de inventar resultados.
Evidencia de esta ampliación
Reutiliza los archivos íntegros que ya incluye la lección: t1=100,t2=200,t3=150 para entrenamiento y t4=180 para prueba. No hace falta un repositorio ni otra fuente de datos. Media=450/3=150; MAE=|180−150|=30. Cambiar solo t4 a120 conserva media150 y MAE30; quitar la partición de prueba debe fallar sin un resultado nuevo.
El tramo Airflow ya descrito usa airflow.sdk, schedule=None y retries=0 para validaciones permanentes. El Job posterior es otro recurso de prueba; no constituye por sí solo un KubernetesExecutor ni una tarea KubernetesPodOperator. La revisión de esta ampliación comprueba el contrato y la aritmética; las afirmaciones de una ejecución anterior en el material original conservan su fecha. Para una ejecución nueva aporta tus propios logs y estado, incluida la disponibilidad de la imagen en los nodos.
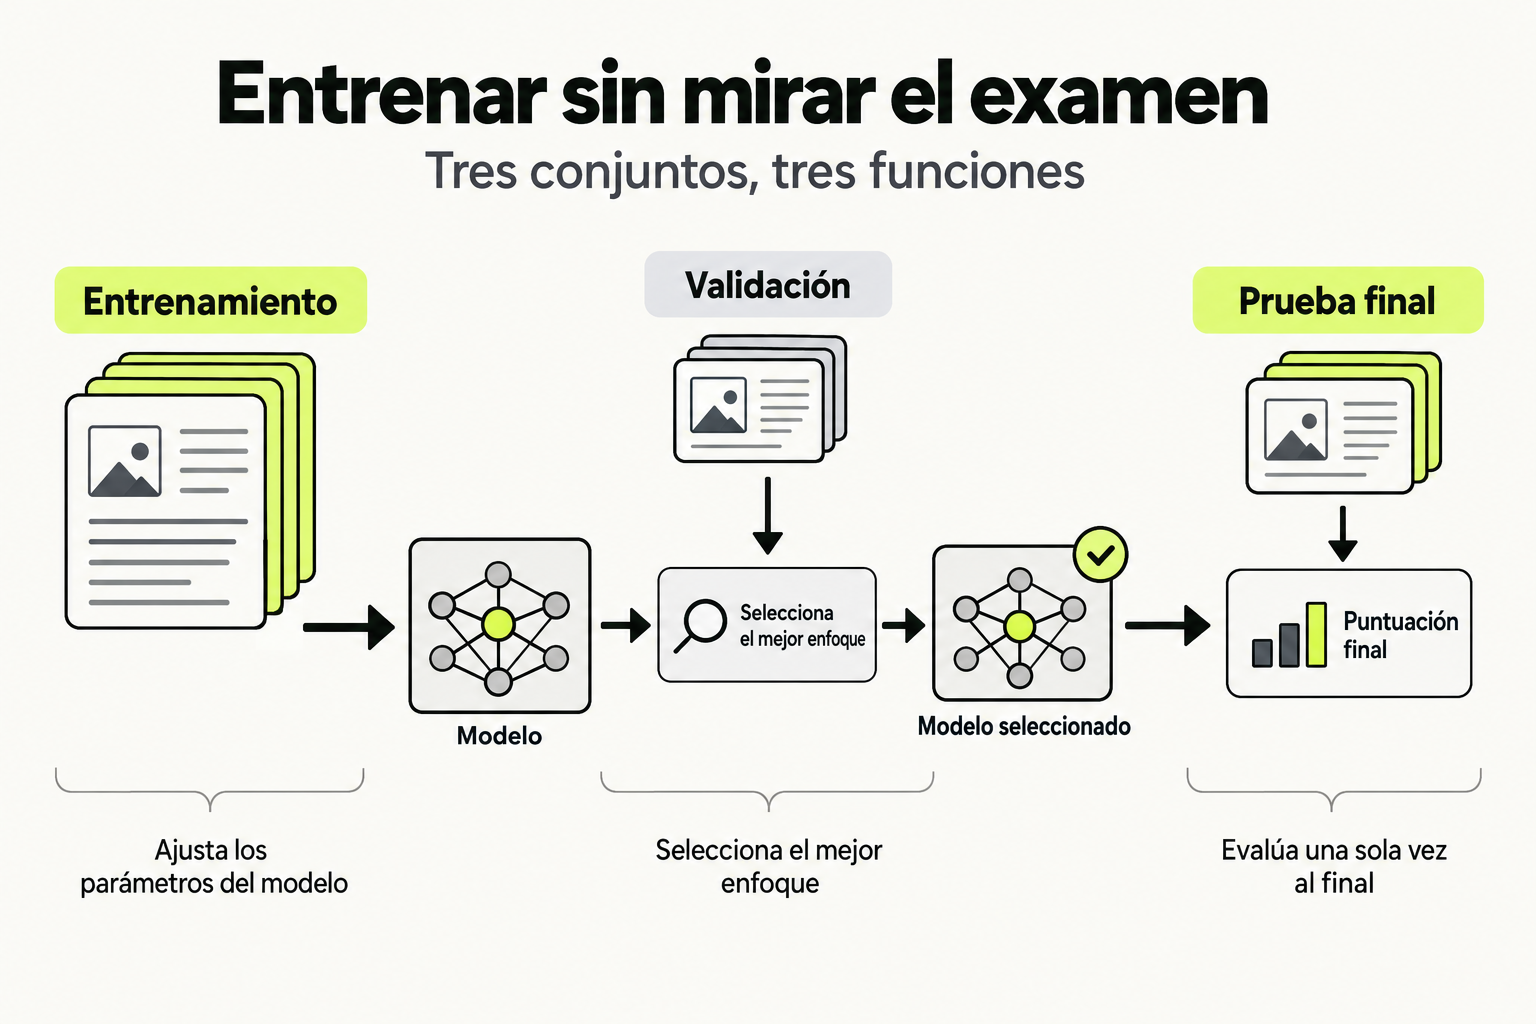
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗La práctica completa y su límite
Construye un pipeline pequeño: leer datos, ajustar un modelo base, evaluar una muestra aparte y registrar el resultado. Airflow coordina las tareas; Docker puede empaquetar el código y Kubernetes puede ejecutar el contenedor como un Job. Usar un clúster no garantiza por sí mismo autoescalado o alta disponibilidad. Esas propiedades requieren configuración y pruebas específicas.
Los datos son inventados. El modelo de práctica predice un importe constante igual al promedio del conjunto de entrenamiento. Sirve para revisar el recorrido de datos y errores, no para demostrar la calidad de un modelo de negocio. La prueba local de Python y Airflow se ejecutó; el build de Docker y el despliegue en Kubernetes se presentan como pasos que el alumno debe ejecutar y comprobar, sin afirmar que ya se han realizado.
El paquete inline que puedes copiar
Crea una carpeta nueva y guarda los seis archivos siguientes con estos nombres. No necesitas credenciales, datos personales ni una API para el tramo local. Para Airflow usa Python 3.12 y la versión 3.3.2, junto con sus restricciones oficiales.
1. data.csv
id,importe,particion
t1,100,entrenamiento
t2,200,entrenamiento
t3,150,entrenamiento
t4,180,prueba
2. pipeline.py
La validación rechaza datos vacíos, identificadores duplicados, importes no finitos y particiones desconocidas. Entrenar no usa la fila reservada para la evaluación.
import csv
import json
import math
from pathlib import Path
from statistics import mean


def extraer():
    path = Path(__file__).with_name("data.csv")
    with path.open(newline="", encoding="utf-8") as source:
        rows = list(csv.DictReader(source))
    if not rows or len({r["id"] for r in rows}) != len(rows):
        raise ValueError("Datos vacíos o identificadores duplicados")
    for row in rows:
        value = float(row["importe"])
        if not math.isfinite(value) or value < 0:
            raise ValueError("Importe inválido")
        if row["particion"] not in {"entrenamiento", "prueba"}:
            raise ValueError("Partición desconocida")
        row["importe"] = value
    return rows


def entrenar(rows):
    train = [r["importe"] for r in rows if r["particion"] == "entrenamiento"]
    if not train:
        raise ValueError("Faltan datos de entrenamiento")
    return {"prediccion_constante": mean(train), "filas_entrenamiento": len(train)}


def evaluar(rows, model):
    test = [r["importe"] for r in rows if r["particion"] == "prueba"]
    if not test:
        raise ValueError("Faltan datos de prueba")
    return {
        "datos": "ficticios",
        **model,
        "filas_prueba": len(test),
        "mae": mean(abs(value - model["prediccion_constante"]) for value in test),
    }


def ejecutar():
    rows = extraer()
    result = evaluar(rows, entrenar(rows))
    print(json.dumps(result, sort_keys=True))
    return result


if __name__ == "__main__":
    ejecutar()
3. pipeline_cursalo.py
TaskFlow declara las relaciones al pasar los resultados. El grafo esperado tiene cuatro tareas: leer → ajustar → comprobar → informar; comprobar recibe también las filas de leer. Los pequeños valores de esta práctica pueden viajar por XCom. No uses este patrón para transportar datasets grandes.
from datetime import datetime, timezone
from airflow.sdk import dag, task
from pipeline import extraer, entrenar, evaluar


@dag(
    dag_id="pipeline_cursalo",
    start_date=datetime(2026, 1, 1, tzinfo=timezone.utc),
    schedule=None,
    catchup=False,
    default_args={"retries": 0},
)
def construir_pipeline():
    @task
    def leer():
        return extraer()

    @task(multiple_outputs=False)
    def ajustar(rows):
        return entrenar(rows)

    @task(multiple_outputs=False)
    def comprobar(rows, model):
        return evaluar(rows, model)

    @task
    def informar(result):
        print(result)

    rows = leer()
    model = ajustar(rows)
    result = comprobar(rows, model)
    informar(result)


dag = construir_pipeline()

if __name__ == "__main__":
    dag.test()
4. requirements.txt
apache-airflow==3.3.2
5. Dockerfile
La imagen de ejemplo fija Python 3.12.3 para describir este ejercicio; antes de adoptar el archivo en un proyecto, selecciona y verifica la versión de mantenimiento de tu entorno. El contenedor lee el CSV y escribe el resultado en la salida estándar como un usuario sin privilegios.
FROM python:3.12.3-slim
WORKDIR /app
COPY pipeline.py data.csv ./
ENV PYTHONDONTWRITEBYTECODE=1
USER 1000:1000
CMD ["python", "-B", "pipeline.py"]
6. job.yaml
Este Job usa una imagen local con etiqueta propia, límites explícitos, un sistema de archivos de solo lectura y ningún token de ServiceAccount montado. Ejecuta la práctica en un clúster de pruebas elegido por ti; la existencia de este manifiesto no demuestra que el contenedor ya haya corrido.
apiVersion: batch/v1
kind: Job
metadata:
  name: cursalo-pipeline-20261002
  labels:
    app: cursalo-practica
spec:
  backoffLimit: 1
  ttlSecondsAfterFinished: 600
  template:
    metadata:
      labels:
        app: cursalo-practica
    spec:
      restartPolicy: Never
      automountServiceAccountToken: false
      securityContext:
        runAsNonRoot: true
        runAsUser: 1000
        seccompProfile:
          type: RuntimeDefault
      containers:
        - name: pipeline
          image: cursalo-pipeline:20261002
          imagePullPolicy: IfNotPresent
          resources:
            requests:
              cpu: 100m
              memory: 64Mi
            limits:
              cpu: 500m
              memory: 128Mi
          securityContext:
            allowPrivilegeEscalation: false
            readOnlyRootFilesystem: true
            capabilities:
              drop: [ALL]
Comprobar el tramo local
python3.12 pipeline.py
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt \
  --constraint https://raw.githubusercontent.com/apache/airflow/constraints-3.3.2/constraints-3.12.txt
export AIRFLOW_HOME="$PWD/.airflow-practica"
export AIRFLOW__CORE__DAGS_FOLDER="$PWD"
export AIRFLOW__CORE__LOAD_EXAMPLES=False
.venv/bin/airflow db migrate
.venv/bin/airflow dags reserialize
.venv/bin/python pipeline_cursalo.py
La salida de datos esperada es prediccion_constante: 150.0, filas_entrenamiento: 3, filas_prueba: 1 y mae: 30.0. El MAE es el error absoluto del único registro de prueba: |180 − 150| = 30. Una muestra inventada de un registro no permite inferir precisión o utilidad en producción.
La revisión del 2 de octubre comprobó estas funciones con Python 3.12.3 y el DAG con Airflow 3.3.2, usando una base SQLite aislada. Las cuatro tareas y el DAG de la prueba local terminaron en success. Los logs del ejercicio deben mostrar las tareas, su estado y la salida; no basta con que exista el DAG.
Docker y Kubernetes: ejecución que debes verificar
docker build -t cursalo-pipeline:20261002 .
docker run --rm --network none --read-only cursalo-pipeline:20261002

# Solo para un clúster local kind ya elegido y creado para la práctica:
kind load docker-image cursalo-pipeline:20261002
kubectl apply -f job.yaml
kubectl wait --for=condition=complete --timeout=120s job/cursalo-pipeline-20261002
kubectl logs job/cursalo-pipeline-20261002
kubectl get job cursalo-pipeline-20261002

# Limpiar exclusivamente el Job de este ejercicio:
kubectl delete job cursalo-pipeline-20261002
Confirma el contexto de kubectl antes de aplicar un recurso. kind load solo carga la imagen en kind; otro tipo de clúster necesita una distribución de imagen adecuada. Si ves ImagePullBackOff, comprueba primero el nombre, la etiqueta y la disponibilidad de la imagen. Si el Job falla, conserva los logs y corrige el problema antes de repetir; no lo declares exitoso porque apply aceptó el YAML.
Errores controlados y entrega
- Quita la fila de prueba del CSV: la evaluación debe rechazar la entrada sin muestra de prueba.
- Duplica un identificador: la extracción debe rechazarlo, evitando continuar con datos ambiguos.
- Repite el pipeline con la muestra intacta: la salida aritmética debe coincidir. Esto comprueba el contrato, no un benchmark de aprendizaje.
- Entrega código, versiones, grafo, salida local y logs del Job si llegaste al tramo del clúster. Marca explícitamente los pasos que no ejecutaste.
- Conserva el CSV original y el código; limpia solo los recursos de esta práctica. No actives una programación recurrente hasta definir datos autorizados, revisión y recuperación de fallos.
La documentación de TaskFlow explica los valores entre tareas. La guía oficial de Airflow en Docker es una referencia adicional para desarrollar, no una configuración de producción completa. La documentación de Jobs de Kubernetes explica ejecución y finalización del recurso. Este paquete no instala un KubernetesExecutor, no usa un KubernetesPodOperator y no muestra un benchmark de clúster: separa el DAG local comprobado del Job que puedes ejecutar después.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.