

Lección 16 de 20 · Lectura y práctica
Definir el Modelo y Arquitectura del Sistema
Concepto claveEn el despliegue de modelos de ML, containerización no es solo empaquetar código, sino encapsular todo el entorno de ejecución: dependencias, librerías, sistema operativo y el modelo entrenado. Imagina que tu modelo.
Del concepto a la práctica
Taller de esta lección
La arquitectura de un recomendador debe separar la decisión de qué recomendar de la forma de servirla. Para una primera versión, un catálogo determinista y un artefacto pequeño permiten validar contratos, latencia y despliegue sin ocultar la ausencia de entrenamiento complejo.
Ejemplo resuelto
El modelo guarda u1:[p3,p2] y u2:[p1,p4]. La API recibe {"user_id":"u1","limit":2} y devuelve {"items":["p3","p2"]}. Si llega u9, responde un error controlado o una lista de respaldo definida; no inventa preferencias ni consulta una fuente inexistente.
Pruébalo
Define entrada, salida y códigos de error.
Separa el catálogo del código de la API.
Decide dónde se carga la versión del modelo al iniciar.
Prueba un usuario conocido, uno desconocido y un límite inválido.
Error frecuente: mezclar entrenamiento y atención de peticiones en el mismo arranque. Corrección: genera el artefacto en una etapa independiente y valida su esquema al cargarlo.
Comprueba tu resultado
Para u1 y límite 2, la salida debe ser exactamente p3,p2; para u9, debe existir una respuesta documentada; para límite 0, la API debe rechazar la entrada. Registra la versión del artefacto en cada respuesta o log.
Artefacto y API de laboratorio completos
Guarda catalogo.json:
{"version":"catalogo-1","usuarios":{"u1":["p3","p2"],"u2":["p1","p4"]}}Guarda app.py; este catálogo es una referencia determinista, no un modelo de filtrado colaborativo entrenado:
import json
from pathlib import Path
from flask import Flask, request, jsonify

app = Flask(__name__)
modelo = json.loads(Path(__file__).with_name("catalogo.json").read_text())
assert isinstance(modelo.get("version"), str)
assert isinstance(modelo.get("usuarios"), dict)
assert all(isinstance(v,list) and all(isinstance(x,str) for x in v)
           for v in modelo["usuarios"].values())

@app.get("/health")
def health():
    return jsonify(status="ok")

@app.get("/ready")
def ready():
    return jsonify(status="ready", model_version=modelo["version"])

@app.post("/recommend")
def recommend():
    data = request.get_json(silent=True)
    if not isinstance(data,dict):
        return jsonify(error="JSON objeto obligatorio"),400
    usuario = data.get("user_id")
    limite = data.get("limit",2)
    if not isinstance(usuario,str) or type(limite) is not int or not 1 <= limite <= 2:
        return jsonify(error="user_id texto y limit entero entre 1 y 2"),400
    if usuario not in modelo["usuarios"]:
        return jsonify(error="usuario desconocido"),404
    return jsonify(items=modelo["usuarios"][usuario][:limite],
                   model_version=modelo["version"])

if __name__ == "__main__":
    app.run(host="0.0.0.0", port=5000, debug=False)
Instala Flask en un entorno aislado y registra todas sus versiones en requirements.lock. Para u1/2 devuelve p3,p2; u2/1 devuelve p1; u9 devuelve404; limit0 o true devuelve400. El servidor integrado sirve para este laboratorio, con un servidor WSGI adecuado en un despliegue real. Un array NumPy serializado no tiene automáticamente un método predict: usa la API real del artefacto elegido. Flask.
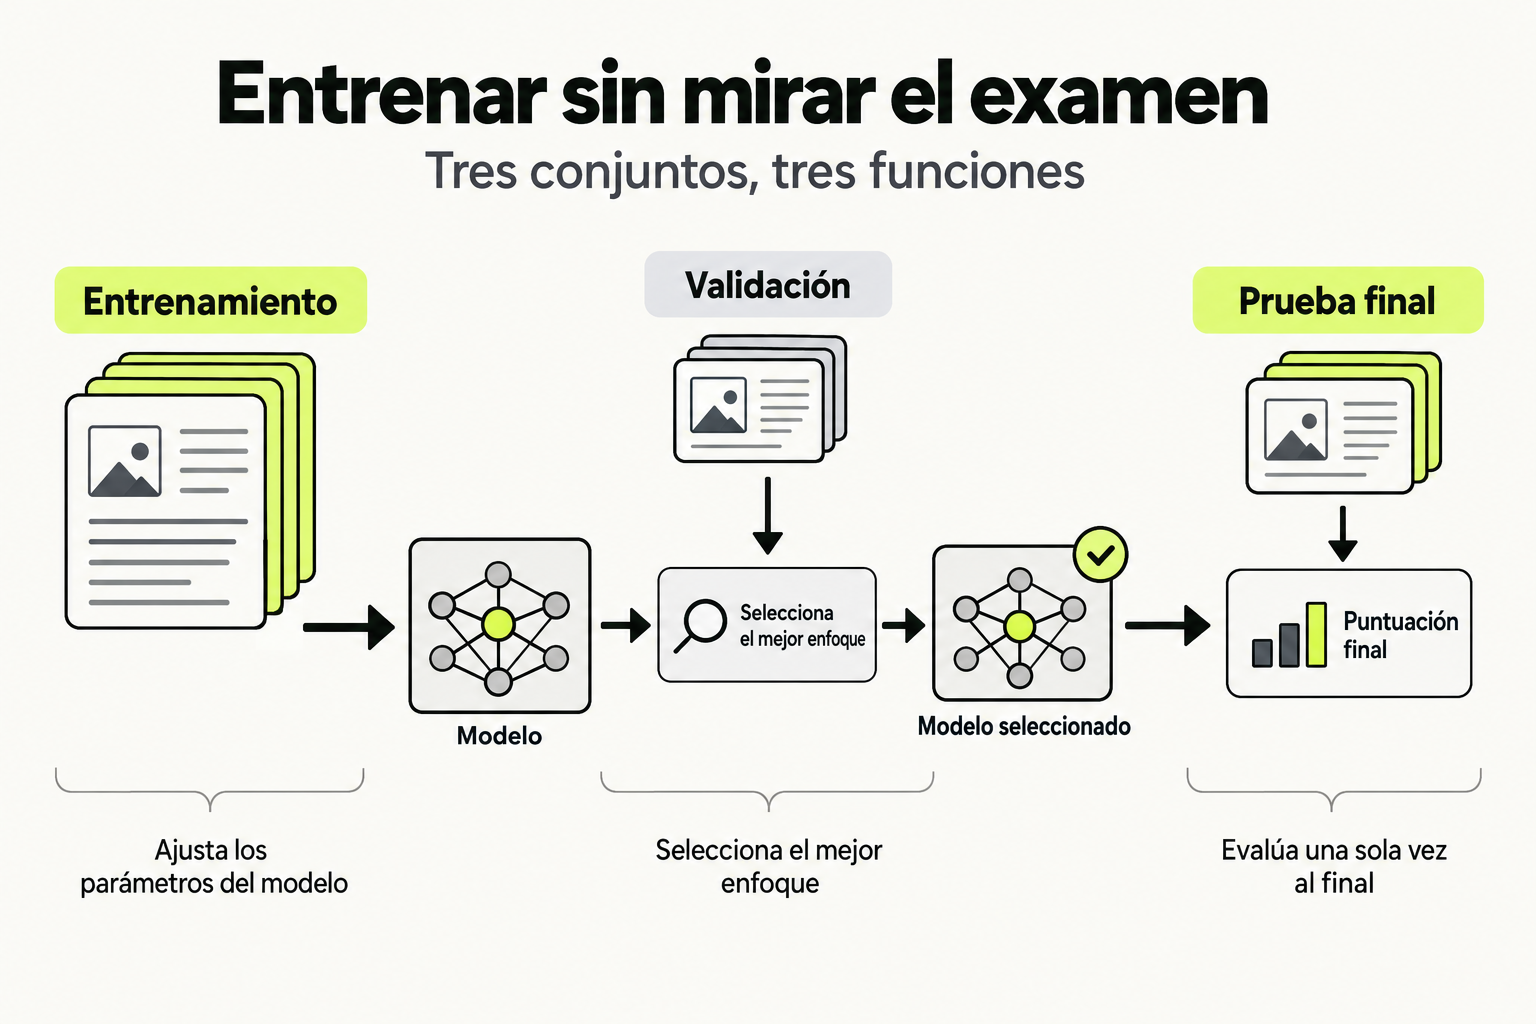
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Concepto clave
En el despliegue de modelos de ML, containerización no es solo empaquetar código, sino encapsular todo el entorno de ejecución: dependencias, librerías, sistema operativo y el modelo entrenado. Imagina que tu modelo es una planta delicada: Docker es la maceta que contiene tierra, nutrientes y agua específicos, mientras Kubernetes es el invernadero que gestiona múltiples macetas, asegurando que cada planta reciba luz y agua automáticamente.
Para un sistema de recomendación, la arquitectura debe separar claramente el servicio de inferencia (que responde a peticiones) del entrenamiento del modelo (que se ejecuta periódicamente). Esto permite actualizar el modelo sin interrumpir el servicio, similar a cómo un restaurante renueva su menú en la cocina mientras sigue sirviendo platos en el comedor.
Cómo funciona en la práctica
Vamos a construir un sistema de recomendación de películas paso a paso. Primero, definimos los componentes:
- API REST: Endpoint que recibe user_id y devuelve recomendaciones
- Modelo: Algoritmo de filtrado colaborativo entrenado
- Base de datos: Almacena ratings y perfiles de usuarios
- Orquestador: Kubernetes gestiona réplicas y balanceo de carga
El flujo: cuando un usuario visita la plataforma, su navegador envía una petición HTTP a nuestra API. El contenedor con el modelo carga los pesos entrenados, realiza la inferencia y devuelve las 10 películas recomendadas en formato JSON. Kubernetes monitorea la carga y escala automáticamente si hay muchas peticiones simultáneas.
Código en acción
Primero, definimos la estructura del proyecto:
# Estructura del proyecto
movie_recommender/
├── Dockerfile
├── requirements.txt
├── app.py
├── model/
│   ├── train_model.py
│   └── model.pkl
└── kubernetes/
    ├── deployment.yaml
    └── service.yaml
Ahora, el archivo app.py con la API Flask:
from flask import Flask, request, jsonify
import pickle
import numpy as np

app = Flask(__name__)

# Cargar modelo al iniciar
with open('model/model.pkl', 'rb') as f:
    model = pickle.load(f)

@app.route('/recommend', methods=['POST'])
def recommend():
    data = request.json
    user_id = data.get('user_id')

    # Simular inferencia (en realidad usarías el modelo cargado)
    recommendations = model.predict(user_id)

    return jsonify({
        'user_id': user_id,
        'recommendations': recommendations.tolist(),
        'model_version': '1.0'
    })

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Errores comunes
- Modelo demasiado grande para el contenedor: Incluir datasets completos en la imagen Docker. Solución: Separar datos del modelo, usando volúmenes o almacenamiento externo.
- Variables de entorno hardcodeadas: Credenciales de base de datos en el código. Solución: Usar ConfigMaps y Secrets de Kubernetes.
- Falta de health checks: Kubernetes no sabe si el modelo está listo. Solución: Implementar endpoints /health y /ready en la API.
- Versionado incorrecto: Actualizar modelo sin cambiar versión. Solución: Sistema de versionado semántico para modelos y APIs.
- Recursos insuficientes: No definir límites de CPU/memoria. Solución: Especificar requests y limits en el deployment.
Checklist de dominio
- ¿Tu Dockerfile tiene múltiples stages para reducir el tamaño final?
- ¿El modelo se carga una vez al iniciar el contenedor, no por cada petición?
- ¿Tienes separados los Dockerfiles para entrenamiento e inferencia?
- ¿Los endpoints de la API siguen convenciones RESTful?
- ¿El deployment de Kubernetes tiene readinessProbe y livenessProbe?
- ¿Los logs incluyen request_id para trazar peticiones?
- ¿Has probado el escalado horizontal con HPA (Horizontal Pod Autoscaler)?
Containerizar un modelo de recomendación básico
Objetivo: Crear una imagen Docker funcional para un sistema de recomendación y desplegarla localmente.
- Crea un directorio
movie_recommendercon la estructura mostrada en la lección - En
requirements.txt, añade:flask==2.3.0, numpy==1.24.0, scikit-learn==1.3.0 - Crea un Dockerfile que:
- Use python:3.9-slim como base
- Copie requirements.txt e instale dependencias
- Copie el código de la aplicación
- Exponga el puerto 5000
- Ejecute
python app.pyal iniciar
- Genera un modelo dummy en
train_model.pyque guarde un array numpy comomodel.pkl - Construye la imagen:
docker build -t movie-recommender:v1 . - Ejecuta el contenedor:
docker run -p 5000:5000 movie-recommender:v1 - Prueba la API con curl:
curl -X POST http://localhost:5000/recommend -H "Content-Type: application/json" -d '{"user_id": 123}'
Pistas
- Usa COPY --chown en el Dockerfile para evitar problemas de permisos
- Para el modelo dummy, puedes usar pickle.dump(np.random.rand(10, 10), file)
- Si el puerto 5000 está ocupado, usa -p 5001:5000 en docker run
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.