

Lección 9 de 20 · Lectura y práctica
Práctica: Escalar un Servicio de Inferencia con HPA
Tipo de lección: VideoConcepto claveEl Horizontal Pod Autoscaler (HPA) es un controlador de Kubernetes que ajusta automáticamente el número de réplicas de un Deployment basándose en métricas de uso de recursos. Imagina que tienes.
Del concepto a la práctica
Taller de esta lección
HPA ajusta réplicas a partir de métricas observables; no mide directamente la calidad de las predicciones. Para que el porcentaje de CPU sea interpretable, el contenedor necesita requests de CPU. Sin esa referencia, el objetivo puede ser inválido o engañoso.
Ejemplo resuelto
Con requests.cpu:100m, un consumo promedio de 80m equivale al 80%. Un HPA con objetivo 70%, mínimo 1 y máximo 3 puede solicitar más réplicas. El cálculo es 80/100*100=80%; no significa que la latencia haya mejorado automáticamente.
Pruébalo
Define requests y límites para el Deployment.
Configura el HPA entre una y tres réplicas.
Genera carga local controlada durante un intervalo corto.
Observa métricas, réplicas y latencia por separado.
Error frecuente: concluir que escalar funciona solo porque el YAML fue aceptado. Corrección: observa una métrica disponible y registra el cambio real.
Comprueba tu resultado
Con el ejemplo, el objetivo se supera porque 80%>70%; el número final de réplicas depende de la métrica observada. Entrega capturas o salidas de métricas y no inventes un tiempo de respuesta.
HPA y cálculo básico
Con una réplica actual y todos los datos disponibles, el cálculo simplificado es ceil(1×80/70)=2, dentro del rango 1–3. Con dos réplicas y el mismo uso medio sería ceil(2×80/70)=3. Tolerancia, métricas faltantes, Pods no listos, límites y estabilización pueden modificar la acción real. El porcentaje utiliza requests de CPU como denominador; los limits protegen recursos pero no son ese denominador.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: cursalo-red-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: cursalo-red
  minReplicas: 1
  maxReplicas: 3
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70
Para que el ejemplo de cálculo 100m sea válido cambia requests.cpu del Deployment a 100m. Revisa que Metrics Server entregue métricas antes de generar una carga corta y acotada; no instales una URL latest indiscriminadamente en otro clúster. Un servidor ligero puede no llegar al umbral; registra ese hecho. No esperes una reducción instantánea de réplicas al detener la carga. HPA oficial.
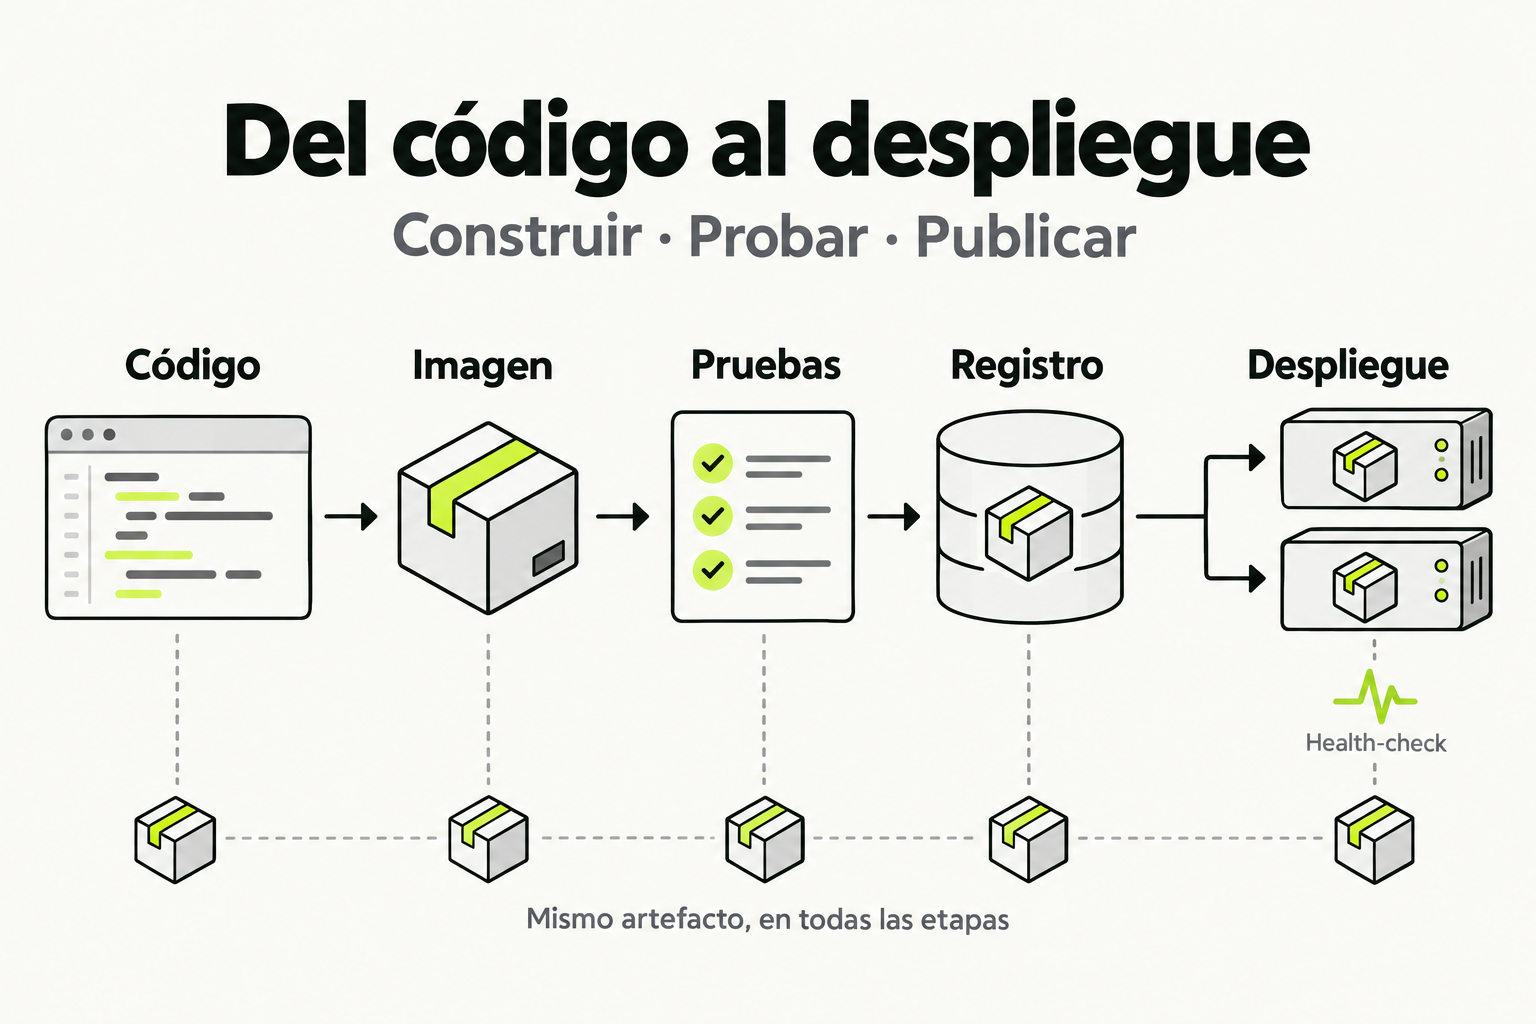
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
El Horizontal Pod Autoscaler (HPA) es un controlador de Kubernetes que ajusta automáticamente el número de réplicas de un Deployment basándose en métricas de uso de recursos. Imagina que tienes un restaurante: cuando llegan muchos clientes (alta carga), contratas más camareros (réplicas); cuando hay pocos, reduces el personal. HPA hace lo mismo con tus pods de inferencia de ML.
En el contexto de modelos de ML, esto es crucial porque la demanda de inferencia puede variar drásticamente. Un modelo que procesa imágenes en tiempo real podría recibir picos de tráfico durante eventos específicos. Sin HPA, tendrías que monitorear manualmente y escalar, lo que lleva a tiempos de respuesta lentos o costos innecesarios por sobreaprovisionamiento.
Cómo funciona en la práctica
HPA monitorea métricas como el uso de CPU o memoria de los pods. Configuras un objetivo (por ejemplo, 70% de uso de CPU) y HPA ajusta las réplicas para mantener ese nivel. Si el uso promedio supera el objetivo, aumenta réplicas; si está por debajo, las reduce, siempre dentro de los límites mínimo y máximo que defines.
Paso a paso: 1) Despliegas tu servicio de inferencia como un Deployment. 2) Expones métricas con un adaptador de métricas (como Metrics Server). 3) Creas un recurso HPA que apunte al Deployment. 4) HPA empieza a escalar basándose en las métricas en tiempo real.
Codigo en accion
Primero, despliega un servicio de inferencia simple. Aquí un Deployment para un modelo de clasificación de imágenes usando Flask:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-inference
spec:
  replicas: 2
  selector:
    matchLabels:
      app: ml-inference
  template:
    metadata:
      labels:
        app: ml-inference
    spec:
      containers:
      - name: inference-container
        image: tu-registro/ml-model:latest
        ports:
        - containerPort: 5000
        resources:
          requests:
            cpu: "200m"
            memory: "256Mi"
          limits:
            cpu: "500m"
            memory: "512Mi"
Luego, crea el HPA para escalar basado en CPU. Antes, sin HPA, tenías réplicas fijas; después, con HPA, se ajustan automáticamente:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: ml-inference-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: ml-inference
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
Errores comunes
- No configurar requests y limits en el Deployment: HPA necesita estos valores para calcular el uso porcentual. Sin ellos, no puede escalar correctamente.
- Usar métricas incorrectas: Para inferencia de ML, CPU puede no ser el mejor indicador. Considera métricas personalizadas como latencia o número de solicitudes.
- Olvidar instalar Metrics Server: Sin él, HPA no tiene datos de métricas. Asegúrate de ejecutar
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/latest/download/components.yaml. - Configurar límites muy estrechos: Si minReplicas es muy alto o maxReplicas muy bajo, pierdes flexibilidad. Ajusta según la carga esperada.
Checklist de dominio
- Desplegué un servicio de inferencia con un Deployment en Kubernetes.
- Configuré requests y limits de recursos en el contenedor.
- Instalé y verifiqué que Metrics Server esté funcionando.
- Creé un HPA que apunte a mi Deployment con métricas de CPU.
- Probé el escalado generando carga con una herramienta como
kubectl run -it --rm load-generator --image=busybox -- /bin/sh -c "while true; do wget -q -O- http://ml-inference-service; done". - Monitoreé las réplicas con
kubectl get hpaykubectl get pods. - Ajusté el HPA para usar métricas personalizadas si es necesario.
Escalar un modelo de predicción de ventas con HPA en Kubernetes
En este ejercicio, desplegarás un modelo de ML simple que predice ventas y lo escalarás automáticamente con HPA basado en el uso de CPU.
- Prepara el entorno: Asegúrate de tener un clúster de Kubernetes funcionando (puedes usar Minikube o un servicio en la nube). Instala Metrics Server si no lo tienes.
- Crea el Deployment: Usa el siguiente código YAML para desplegar un servicio de inferencia. Guarda como
deployment.yamly aplica conkubectl apply -f deployment.yaml. - Configura el HPA: Crea un archivo
hpa.yamlcon la configuración de HPA que escale de 2 a 5 réplicas basado en 60% de uso de CPU. Aplica conkubectl apply -f hpa.yaml. - Genera carga: Usa un pod temporal para enviar solicitudes HTTP al servicio y simular tráfico. Ejecuta
kubectl run -it --rm load-test --image=alpine -- sh -c "while true; do wget -q -O- http://ml-inference-service; sleep 0.5; done". - Monitorea y verifica: En otra terminal, ejecuta
kubectl get hpa -wpara ver cómo HPA ajusta las réplicas. Detén la carga después de 2 minutos y observa cómo se reducen las réplicas. - Documenta resultados: Toma capturas de pantalla o anota el número máximo de réplicas alcanzado y el tiempo que tomó escalar.
Pistas
- Asegúrate de que el servicio esté expuesto correctamente; usa
kubectl get servicespara verificar. - Si HPA no escala, revisa los logs de Metrics Server con
kubectl logs -n kube-system deployment/metrics-server. - Para una carga más realista, ajusta el intervalo de solicitudes en el comando de generación de carga.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.