

Lección 10 de 20 · Lectura y práctica
Quiz: Fundamentos de Kubernetes
Tipo de lección: QuizConcepto claveKubernetes es un sistema de orquestación de contenedores que automatiza el despliegue, escalado y gestión de aplicaciones en contenedores. Imagina que tienes una flota de camiones (nodos) que.
Del concepto a la práctica
Taller de esta lección
El diagnóstico de Kubernetes consiste en recorrer el camino desde el recurso declarado hasta el proceso: manifiesto, ReplicaSet, Pod, contenedor, Service y endpoint. Cada nivel puede estar correcto mientras el siguiente falla, así que un único get pods no basta.
Ejemplo resuelto
Si un Pod está Running pero la sonda falla, el proceso existe y la aplicación no está sana según el contrato. Si el Service no tiene endpoints, puede haber un selector incorrecto o ningún Pod listo. Si hay endpoints pero la petición falla, revisa puerto y proceso.
Pruébalo
Consulta Deployment, Pods, eventos y endpoints.
Revisa el selector del Service frente a las etiquetas reales.
Compara
targetPortcon el puerto de escucha.Inspecciona logs antes de cambiar réplicas.
Error frecuente: reiniciar repetidamente un Pod sin leer el evento. Corrección: conserva el primer error y corrige la causa declarada.
Comprueba tu resultado
Construye una tabla con cuatro estados: réplica deseada, Pod listo, endpoints y respuesta HTTP. Una solución completa identifica el nivel exacto del fallo y muestra la comprobación posterior.
Causa probable frente a evidencia
Running indica una fase del Pod, no que su inferencia sea correcta. Si readiness falla, el Pod deja de estar listo para tráfico sin que esa sonda lo reinicie; liveness o startup fallidas pueden reiniciar el contenedor al superar su umbral. Un Service sin direcciones listas puede deberse a selector incorrecto o a falta de Pods listos: comprueba ambas posibilidades. Consulta EndpointSlices y los eventos del Pod.
Caso de prueba: deseadas=2, listas=0, selector correcto y readiness /health devuelve404. La causa es una ruta no implementada; corrige la aplicación o el contrato de la sonda y espera listas=2 antes de probar. Declarar el puerto no crea un endpoint HTTP. Las actualizaciones sin interrupción dependen de capacidad, readiness y estrategia; Kubernetes no ofrece esa garantía por incluir solo replicas:2.
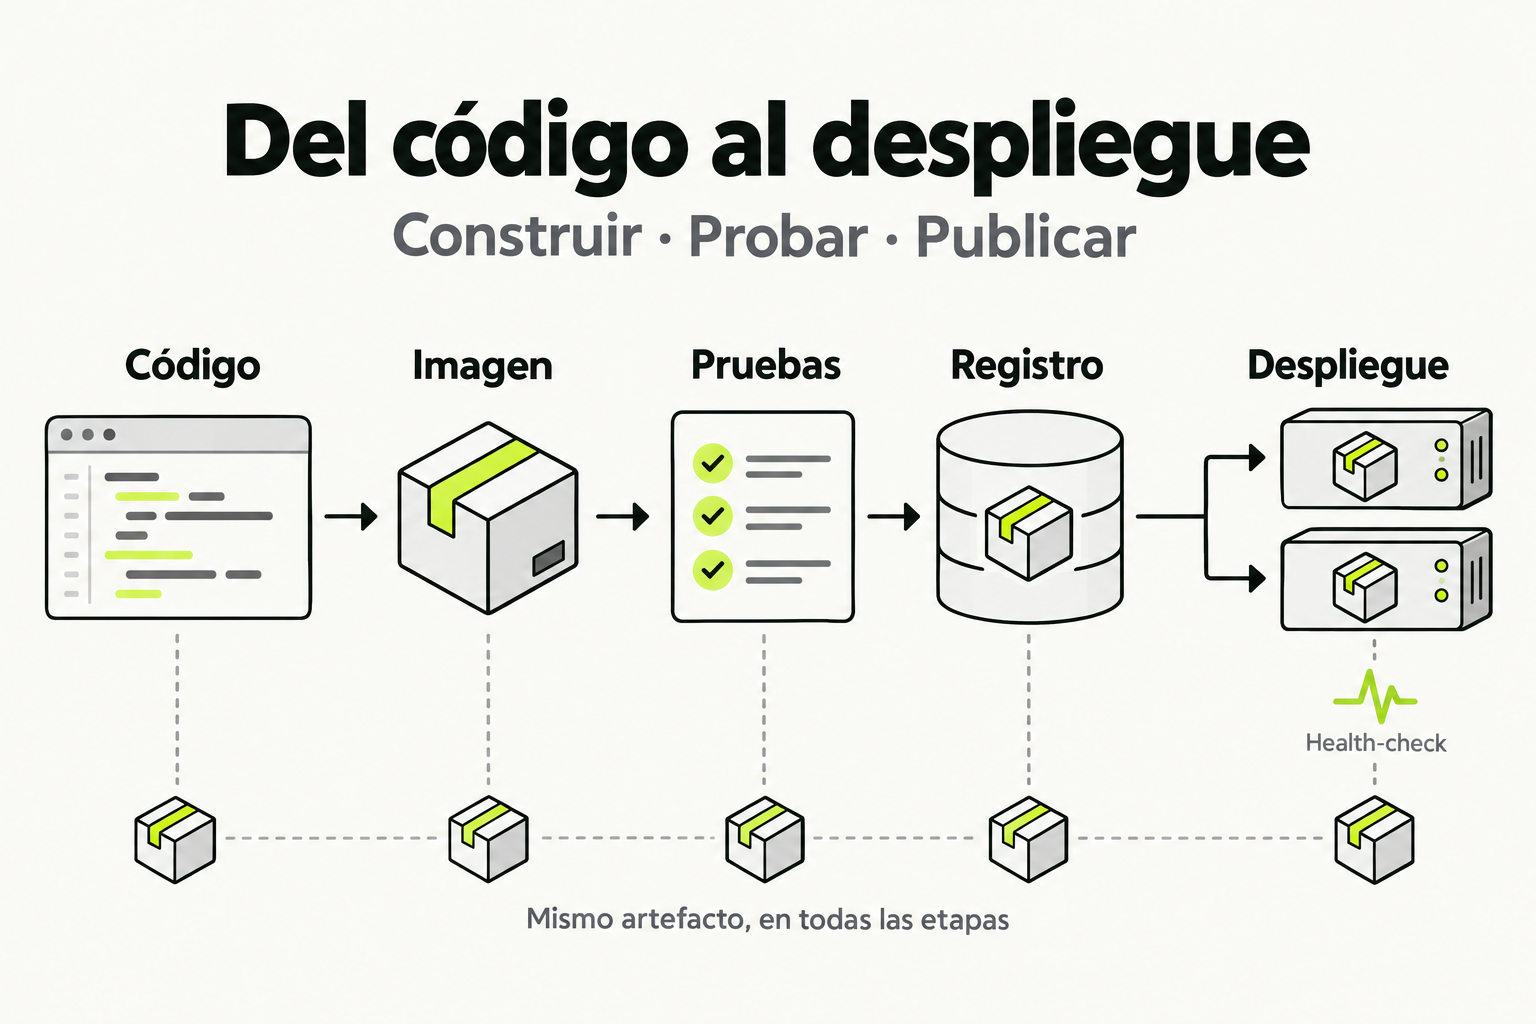
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
Kubernetes es un sistema de orquestación de contenedores que automatiza el despliegue, escalado y gestión de aplicaciones en contenedores. Imagina que tienes una flota de camiones (nodos) que transportan cajas (pods) con productos (contenedores). Kubernetes es el centro de control que decide qué camión lleva qué caja, cuándo agregar más camiones si hay mucho tráfico, y cómo reemplazar camiones que se descomponen, todo sin interrumpir la entrega.
En el contexto de modelos de ML, Kubernetes permite desplegar múltiples réplicas de tu modelo para manejar picos de tráfico, actualizar versiones sin tiempo de inactividad mediante rolling updates, y gestionar recursos como CPU y memoria para optimizar costos. Es como tener un equipo de científicos de datos que automáticamente ajusta la infraestructura según la demanda de predicciones.
Cómo funciona en la práctica
Para desplegar un modelo de ML en Kubernetes, sigues estos pasos: primero, creas un Deployment que define cuántas réplicas del contenedor Docker quieres ejecutar. Luego, expones el Deployment con un Service para que las aplicaciones externas puedan acceder a las predicciones. Finalmente, configuras un Horizontal Pod Autoscaler para escalar automáticamente basado en métricas como uso de CPU.
Ejemplo: Supón que tienes un modelo de clasificación de imágenes en un contenedor Docker. Creas un Deployment con 3 réplicas para alta disponibilidad, un Service de tipo LoadBalancer para distribuir tráfico, y un autoscaler que añade más réplicas si el uso de CPU supera el 70%. Así, durante horas pico, Kubernetes puede escalar a 5 réplicas sin intervención manual.
Código en acción
Aquí tienes un archivo YAML para un Deployment de un modelo de ML simple. Antes de refactorizar, podrías tener un Deployment básico:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-model-basic
spec:
  replicas: 1
  selector:
    matchLabels:
      app: ml-model
  template:
    metadata:
      labels:
        app: ml-model
    spec:
      containers:
      - name: model-container
        image: mi-registro/ml-model:v1
        ports:
        - containerPort: 5000
Después de refactorizar para mejores prácticas, añades recursos y health checks:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-model-optimizado
spec:
  replicas: 3
  selector:
    matchLabels:
      app: ml-model
  template:
    metadata:
      labels:
        app: ml-model
    spec:
      containers:
      - name: model-container
        image: mi-registro/ml-model:v2
        ports:
        - containerPort: 5000
        resources:
          requests:
            memory: "256Mi"
            cpu: "250m"
          limits:
            memory: "512Mi"
            cpu: "500m"
        livenessProbe:
          httpGet:
            path: /health
            port: 5000
          initialDelaySeconds: 30
          periodSeconds: 10
Errores comunes
- No definir límites de recursos: Sin límites de CPU/memoria, un pod puede consumir todos los recursos del nodo, causando inestabilidad. Siempre especifica requests y limits en el Deployment.
- Olvidar health checks: Sin livenessProbe, Kubernetes no sabe si tu modelo está funcionando, lo que puede llevar a tráfico enviado a pods caídos. Incluye endpoints /health en tu aplicación.
- Usar latest en image tags: Usar "latest" puede causar despliegues inconsistentes. Usa tags específicos como v1.2.3 para control de versiones.
- No configurar rolling updates: Actualizar sin strategy puede causar tiempo de inactividad. Define strategy.type: RollingUpdate en el Deployment.
- Ignorar namespaces Desplegar todo en default namespace lleva a desorden. Usa namespaces como ml-production para organizar recursos.
Checklist de dominio
- Puedo crear un Deployment YAML para un modelo de ML con réplicas y recursos definidos.
- Sé exponer un Deployment con un Service (ClusterIP o LoadBalancer).
- Entiendo cómo configurar un Horizontal Pod Autoscaler basado en métricas de CPU.
- Puedo aplicar rolling updates para actualizar la versión de un modelo sin downtime.
- Sé usar kubectl para verificar el estado de pods, deployments y services.
- Puedo solucionar problemas comunes como pods en estado CrashLoopBackOff.
- Entiendo la diferencia entre requests y limits de recursos en Kubernetes.
Despliega un Modelo de ML en Minikube
En este ejercicio, desplegarás un modelo de ML simple en un cluster local de Kubernetes usando Minikube. Sigue estos pasos:
- Instala Minikube y kubectl si no los tienes. Ejecuta
minikube startpara iniciar el cluster. - Crea un archivo llamado
deployment.yamlcon el código YAML optimizado de la sección "Código en acción" (usa una imagen Docker pública comopython:3.9-slimpara simular). - Aplica el Deployment con
kubectl apply -f deployment.yaml. - Verifica que los pods estén corriendo con
kubectl get pods. - Crea un archivo
service.yamlpara exponer el Deployment con un Service de tipo NodePort. - Aplica el Service y accede al modelo usando
minikube service <nombre-del-service>. - Escala el Deployment a 5 réplicas con
kubectl scale deployment ml-model-optimizado --replicas=5y verifica los cambios.
Pistas
- Si minikube start falla, verifica que tengas un hypervisor como VirtualBox instalado.
- Para el Service, usa apiVersion: v1, kind: Service, y spec.type: NodePort con puerto 5000.
- Puedes simular un modelo con un contenedor que ejecute un servidor web simple en Python.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.