

Lección 8 de 20 · Lectura y práctica
Desplegar tu Primer Modelo en Kubernetes
Concepto claveDesplegar un modelo de ML en Kubernetes significa empaquetar tu aplicación en contenedores y usar Kubernetes para gestionar su ejecución, escalado y disponibilidad. Piensa en Kubernetes como el director de orquesta.
Del concepto a la práctica
Taller de esta lección
Desplegar una API de inferencia requiere alinear cuatro contratos: nombre de imagen, puerto de escucha, formato de entrada y estado de salud. Kubernetes puede mantener un Pod en ejecución aunque la aplicación responda con errores, por eso las sondas y una prueba funcional son independientes.
Ejemplo resuelto
La API acepta {"features":[2,5]} y escucha en 5000. El Deployment usa la imagen recomendador:1, una sonda /health y dos réplicas. El Service traduce 8080 a 5000. Una respuesta válida puede ser {"items":[7,4]}.
Pruébalo
Construye o carga la imagen en el entorno local autorizado.
Aplica Deployment y Service.
Espera Pods listos y revisa logs.
Envía una petición de salud y otra de predicción.
Error frecuente: probar antes de que la imagen esté disponible para el clúster. Corrección: confirma el método de carga y la etiqueta exacta.
Comprueba tu resultado
La salud debe responder correctamente en las dos réplicas y la entrada de dos características debe devolver dos identificadores ordenados. Guarda el manifiesto aplicado y la respuesta, sin afirmar ejecución si no ocurrió.
Contrato reproducible de la predicción
Para esta prueba de dos características, define el artefacto JSON de pesos de práctica {"version":"pesos-1","items":{"7":[1,2],"4":[2,1]}}. Calcula cada puntuación como producto escalar con features: para [2,5], item7=12 e item4=9; ordenar descendentemente da [7,4]. Es una regla preparada para verificar el servicio, sin afirmar entrenamiento ni utilidad de recomendaciones. Exige exactamente dos números finitos, excluyendo booleanos; una lista de un valor devuelve un error 400 y no una predicción.
La API debe implementar realmente /health y /ready. Readiness evita enviar tráfico a una réplica que no ha cargado el artefacto; liveness detecta un proceso atascado según el contrato; una startupProbe puede proteger un arranque lento. Probar mediante port-forward a un Service normalmente selecciona un Pod y no acredita las dos réplicas: prueba cada Pod por separado o utiliza una prueba de red que registre la réplica atendida. Sondas.
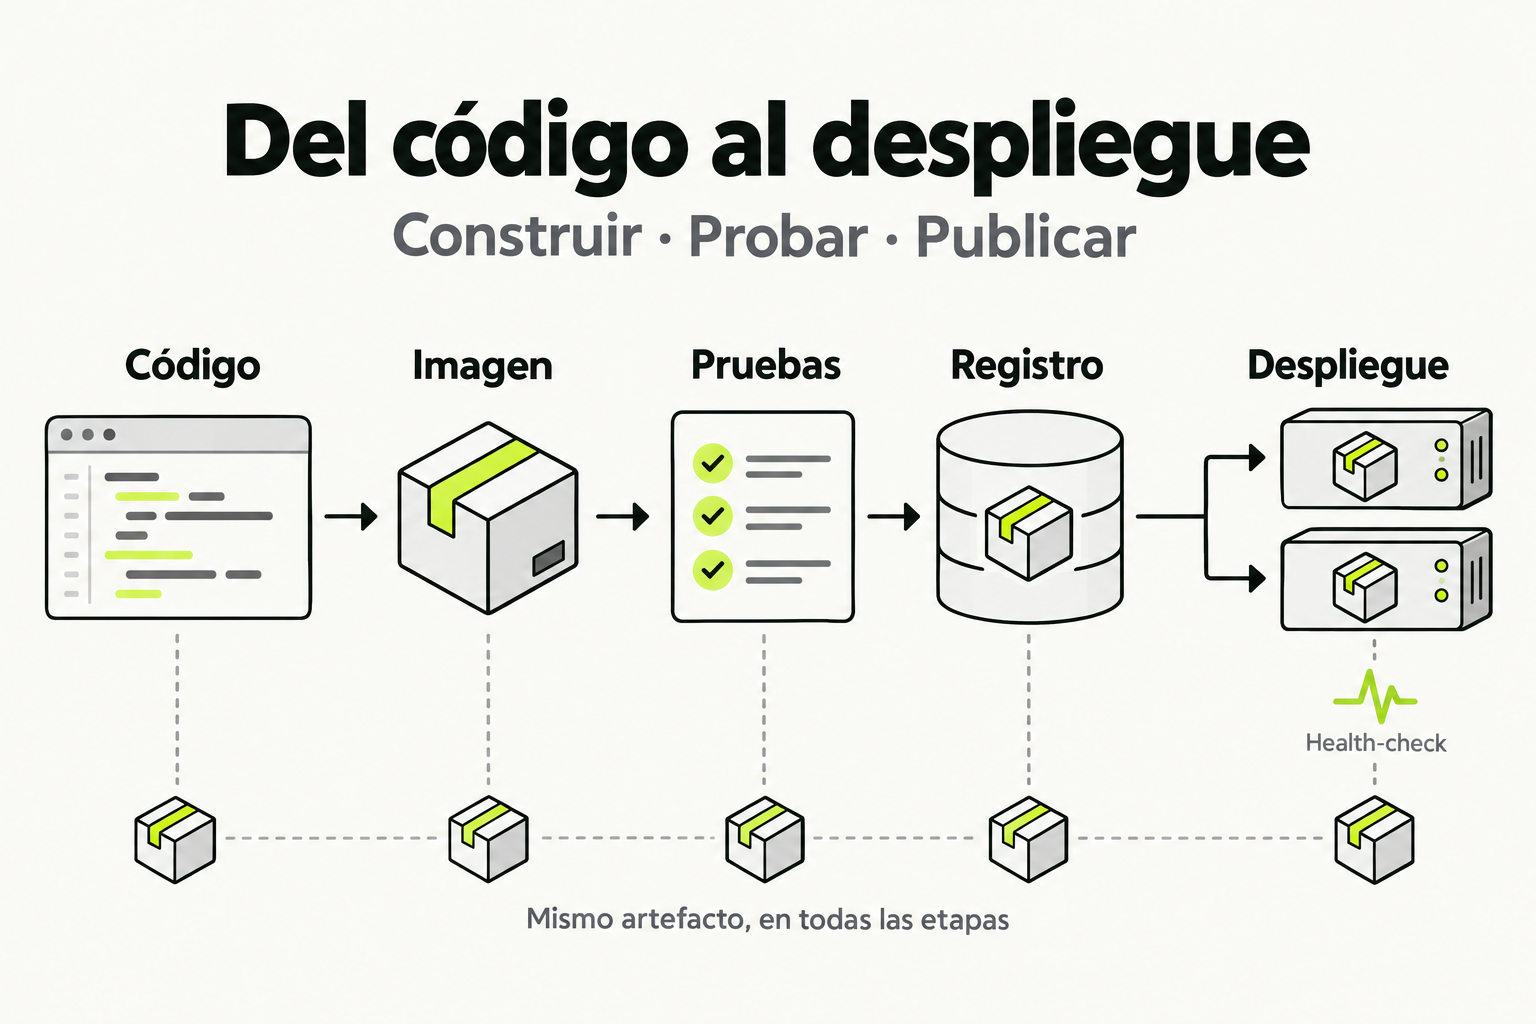
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Concepto clave
Desplegar un modelo de ML en Kubernetes significa empaquetar tu aplicación en contenedores y usar Kubernetes para gestionar su ejecución, escalado y disponibilidad. Piensa en Kubernetes como el director de orquesta que coordina múltiples músicos (contenedores) para tocar una sinfonía (tu modelo en producción). En lugar de preocuparte por máquinas individuales, defines el estado deseado (ej., 3 réplicas del modelo) y Kubernetes lo mantiene automáticamente.
La unidad básica es el Pod, que agrupa uno o más contenedores que comparten recursos. Para exponer tu modelo al mundo, usas un Service que actúa como punto de entrada estable. Imagina que tu modelo es un restaurante: el Pod es la cocina donde se prepara la comida, el Service es el mostrador donde los clientes piden, y Kubernetes es el gerente que asegura que siempre haya cocineros disponibles.
Cómo funciona en la práctica
El flujo típico tiene 5 pasos: 1) Crear una imagen Docker con tu modelo y API, 2) Subirla a un registro como Docker Hub, 3) Definir un Deployment en Kubernetes que especifique cuántas réplicas ejecutar, 4) Crear un Service para acceder al Deployment, 5) Aplicar la configuración con kubectl. Por ejemplo, para un modelo de clasificación de imágenes, tu Deployment indicaría "ejecuta 3 instancias del contenedor modelo-clasificador en el puerto 5000", y el Service redirigiría el tráfico a esas instancias.
Kubernetes monitorea la salud de tus Pods. Si uno falla, lo reinicia automáticamente. Si necesitas más capacidad, puedes escalar horizontalmente aumentando el número de réplicas con un solo comando. Esto es crucial para modelos de ML que enfrentan picos de tráfico impredecibles.
Codigo en accion
Primero, un archivo Dockerfile para contenerizar un modelo simple de sklearn:
FROM python:3.9-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY model.pkl app.py .
EXPOSE 5000
CMD ["python", "app.py"]
Luego, un archivo app.py con la API Flask:
from flask import Flask, request, jsonify
import pickle
import numpy as np

app = Flask(__name__)
with open('model.pkl', 'rb') as f:
    model = pickle.load(f)

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json()
    features = np.array(data['features']).reshape(1, -1)
    prediction = model.predict(features)[0]
    return jsonify({'prediction': int(prediction)})

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
Ahora, un Deployment de Kubernetes (deployment.yaml):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: modelo-ml-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: modelo-ml
  template:
    metadata:
      labels:
        app: modelo-ml
    spec:
      containers:
      - name: modelo-container
        image: tuusuario/modelo-ml:v1
        ports:
        - containerPort: 5000
Y un Service para exponerlo (service.yaml):
apiVersion: v1
kind: Service
metadata:
  name: modelo-ml-service
spec:
  selector:
    app: modelo-ml
  ports:
  - protocol: TCP
    port: 80
    targetPort: 5000
  type: LoadBalancer
Errores comunes
- Imagen Docker no encontrada: Asegúrate de que la imagen esté en un registro accesible y el nombre en el Deployment sea correcto. Usa
docker pushdespués dedocker build. - Pods en estado CrashLoopBackOff: Suele deberse a errores en el código de la app o dependencias faltantes. Revisa los logs con
kubectl logs <pod-name>. - Service no conecta con los Pods: Verifica que los selectores en el Service coincidan con las labels del Deployment. Ejecuta
kubectl describe service modelo-ml-servicepara debuggear. - Falta de recursos: Si los Pods no se programan, puede que el cluster no tenga suficiente CPU/memoria. Define límites en el Deployment con
resources.requestsyresources.limits. - Puertos incorrectos: Confirma que
containerPorten el Deployment coincida con el puerto que usa tu app (ej., 5000) y quetargetPorten el Service apunte al mismo.
Checklist de dominio
- Puedo construir una imagen Docker con mi modelo de ML y una API REST.
- Sé crear un Deployment de Kubernetes que ejecute múltiples réplicas de mi contenedor.
- Entiendo cómo configurar un Service para exponer mi Deployment a tráfico externo.
- Puedo aplicar configuraciones YAML con
kubectl apply -fy verificar el estado conkubectl get pods. - Sé escalar mi Deployment manualmente usando
kubectl scale deployment. - Puedo solucionar problemas comunes revisando logs y describiendo recursos.
- Comprendo la diferencia entre Pod, Deployment y Service en el flujo de despliegue.
Despliega un modelo de regresión lineal en un cluster de Kubernetes local
Sigue estos pasos para desplegar un modelo de ML básico en Minikube (Kubernetes local):
- Prepara el modelo: Crea un script Python que entrene un modelo de regresión lineal con sklearn y lo guarde como model.pkl. Incluye un app.py similar al ejemplo de la lección, pero que prediga valores numéricos.
- Construye la imagen Docker: Escribe un Dockerfile basado en python:3.9, copia model.pkl y app.py, instala flask y sklearn, y expone el puerto 5000.
- Ejecuta
docker build -t modelo-regresion:v1 .y luegodocker run -p 5000:5000 modelo-regresion:v1para probar localmente. - Inicia Minikube con
minikube start. Etiqueta la imagen para Minikube coneval $(minikube docker-env)y reconstruye la imagen. - Crea un archivo deployment.yaml con un Deployment de 2 réplicas y un archivo service.yaml con un Service de tipo NodePort.
- Aplica los archivos YAML con
kubectl apply -f deployment.yaml -f service.yaml. - Verifica que los Pods estén corriendo con
kubectl get pods. Accede al modelo usandominikube service modelo-regresion-service --urly haz una predicción con curl.
Pistas
- Usa Minikube addons para habilitar el registro si necesitas subir imagenes.
- Si el Service no funciona, verifica que el selector coincida con las labels del Deployment.
- Para probar la API, envía un JSON con {"features": [1,2,3]} al endpoint /predict.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.