

Lección 13 de 20 · Lectura y práctica
Automatizar Despliegues con CI/CD para ML
Concepto claveLa automatización de despliegues con CI/CD para Machine Learning es el proceso de crear un flujo automatizado que construye, prueba y despliega modelos de ML en contenedores Docker y los orquesta en Kubernetes..
Del concepto a la práctica
Taller de esta lección
En ML, una canalización de entrega debe bloquear una publicación aunque el código compile. La imagen solo avanza si las pruebas funcionales y una regla de calidad del modelo pasan con datos de validación separados del entrenamiento.
Ejemplo resuelto
Un conjunto de validación contiene cuatro casos: tres aciertos y un error. La exactitud es 3/4=0,75. Si la regla mínima es 0,80, el pipeline debe detenerse; construir la imagen no convierte 0,75 en 75% aceptable frente a ese umbral.
Pruébalo
Versiona código, requisitos y esquema de datos.
Ejecuta la prueba con los cuatro casos visibles.
Calcula la métrica mediante una fórmula determinista.
Permite publicación solo si
métrica >= 0,80.
Error frecuente: evaluar sobre los mismos datos usados para entrenar. Corrección: conserva una partición de validación y registra sus identificadores.
Comprueba tu resultado
Con tres aciertos de cuatro, la ejecución debe marcarse como rechazada y no publicar la etiqueta de producción. Cambia un caso para obtener cuatro aciertos y verifica que el criterio pase.
Casos de validación completos
Etiquetas reales [0,1,1,0]; predichas [0,1,0,0]. Hay tres aciertos: exactitud=0.75=75%, inferior al umbral0.80=80%. Corregir solo la tercera predicción a1 produce4/4=1.0 y pasa. No cambies la verdad observada para mejorar la métrica.
Si entrenamiento y construcción son Jobs distintos de CI, comparte explícitamente el modelo y metrics.json mediante artifacts u otro almacenamiento; needs ordena Jobs pero no transfiere sus archivos entre runners. El Job de construcción también necesita checkout/contexto real. Etiqueta la imagen por commit y despliega esa referencia, sin construir latest mientras el manifiesto conserva una versión vieja. Conserva el identificador del modelo aprobado, la métrica y el digest de la imagen para poder revertir. La simulación puede detenerse antes de cualquier push o despliegue externo. Artefactos de GitHub Actions.
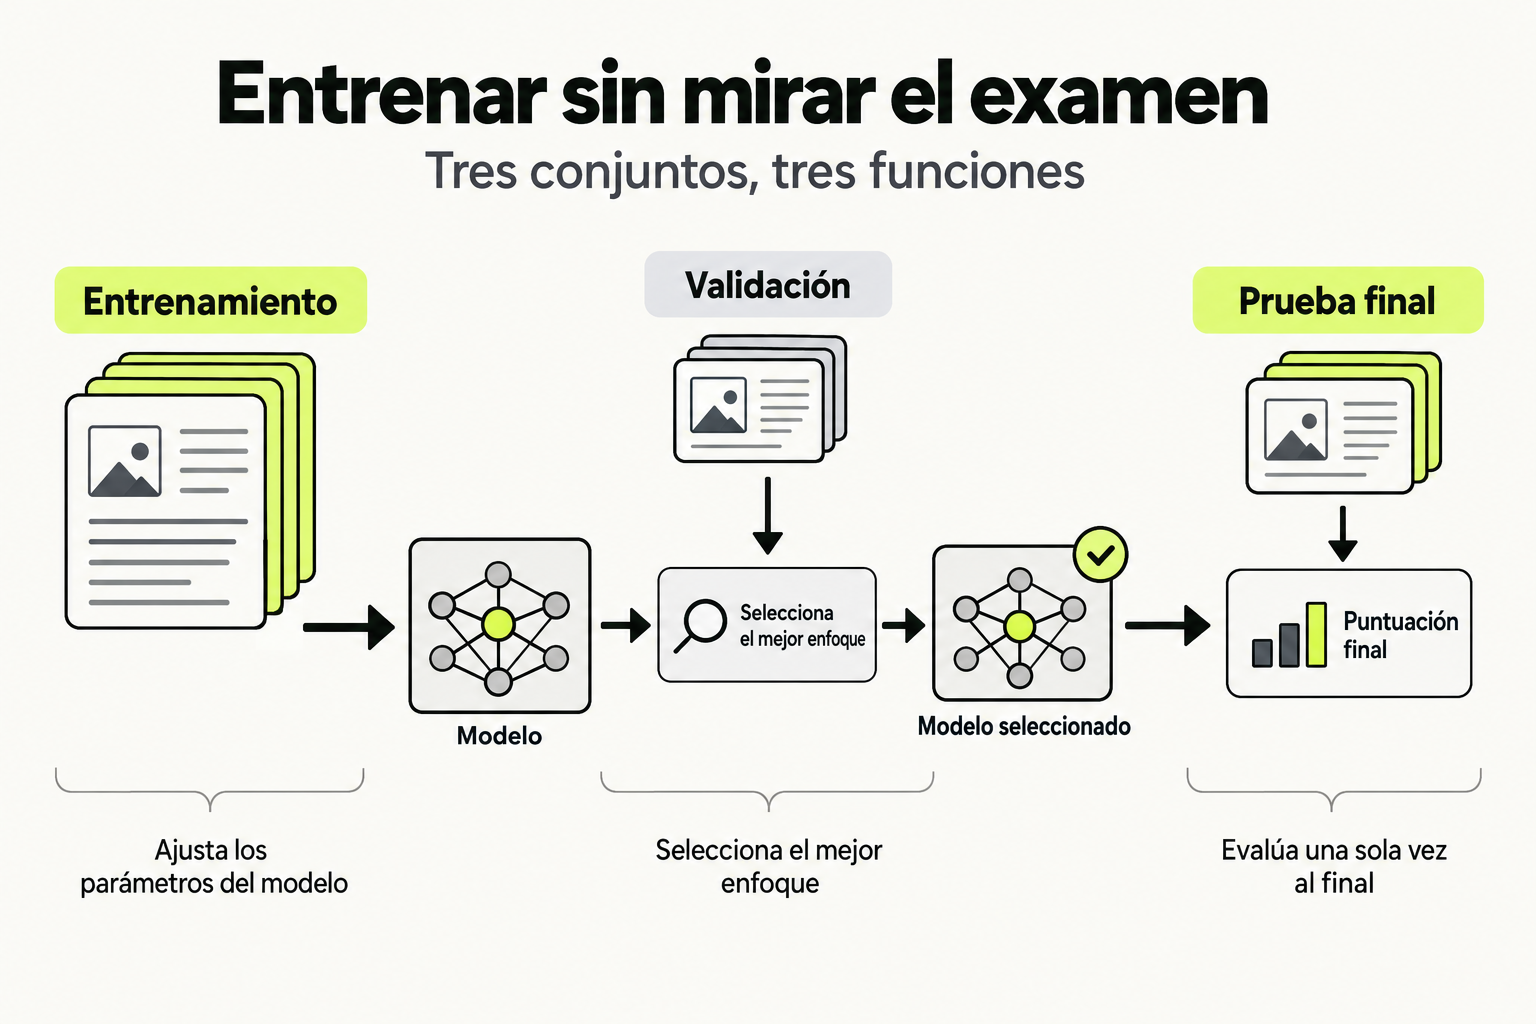
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Concepto clave
La automatización de despliegues con CI/CD para Machine Learning es el proceso de crear un flujo automatizado que construye, prueba y despliega modelos de ML en contenedores Docker y los orquesta en Kubernetes. Imagina que eres un panadero que automatiza su producción: en lugar de hornear cada pan manualmente, configuras una línea de producción que mezcla ingredientes, hornea y empaqueta automáticamente cuando recibes un nuevo pedido. En ML, esto significa que cada vez que actualizas tu código del modelo, un sistema automatizado lo empaca en un contenedor, lo prueba y lo despliega sin intervención manual.
El CI/CD (Integración Continua/Despliegue Continuo) para ML agrega desafíos únicos: no solo debes probar código, sino también datos, modelos entrenados y métricas de rendimiento. Un pipeline típico incluye etapas como: entrenamiento del modelo, validación de métricas, construcción de la imagen Docker, pruebas de integración y despliegue en Kubernetes. La clave es que todo esto se dispara automáticamente al hacer un cambio en tu repositorio de código, asegurando que tus modelos en producción estén siempre actualizados y funcionando correctamente.
Cómo funciona en la práctica
Vamos a desglosar un ejemplo paso a paso usando GitHub Actions como herramienta de CI/CD y un modelo de clasificación simple. Supongamos que tienes un proyecto de ML con esta estructura:
train.py: Script para entrenar el modeloDockerfile: Para construir la imagen del contenedordeployment.yaml: Configuración de Kubernetesrequirements.txt: Dependencias de Python
El flujo automatizado se activa cuando haces un push a la rama main de tu repositorio. Primero, el sistema ejecuta el entrenamiento del modelo y valida que su precisión supere un umbral (ej., 90%). Luego, construye la imagen Docker, la etiqueta con la versión del commit y la sube a un registro como Docker Hub. Finalmente, actualiza el despliegue en Kubernetes para usar la nueva imagen, realizando un rollout gradual que minimiza el tiempo de inactividad.
Código en acción
A continuación, un ejemplo real de un archivo .github/workflows/ml-cicd.yaml que define el pipeline de CI/CD:
name: ML CI/CD Pipeline

on:
  push:
    branches: [ main ]

jobs:
  train-and-test:
    runs-on: ubuntu-latest
    steps:
      - name: Checkout código
        uses: actions/checkout@v3

      - name: Configurar Python
        uses: actions/setup-python@v4
        with:
          python-version: '3.9'

      - name: Instalar dependencias
        run: pip install -r requirements.txt

      - name: Entrenar modelo
        run: python train.py

      - name: Validar métricas
        run: |
          accuracy=$(python -c "import json; data=open('metrics.json').read(); print(json.loads(data)['accuracy'])")
          if [ $(echo "$accuracy < 0.9" | bc) -eq 1 ]; then
            echo "Accuracy too low: $accuracy"
            exit 1
          fi

  build-and-push:
    needs: train-and-test
    runs-on: ubuntu-latest
    steps:
      - name: Checkout código
        uses: actions/checkout@v3

      - name: Login a Docker Hub
        uses: docker/login-action@v2
        with:
          username: ${{ secrets.DOCKER_USERNAME }}
          password: ${{ secrets.DOCKER_PASSWORD }}

      - name: Construir y push imagen Docker
        uses: docker/build-push-action@v4
        with:
          push: true
          tags: tuusuario/ml-model:latest

  deploy-to-kubernetes:
    needs: build-and-push
    runs-on: ubuntu-latest
    steps:
      - name: Configurar kubectl
        uses: azure/setup-kubectl@v3

      - name: Desplegar en Kubernetes
        run: kubectl apply -f deployment.yaml
Y aquí un Dockerfile básico para el modelo:
FROM python:3.9-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY . .
CMD ["python", "app.py"]
Errores comunes
- No versionar modelos o datos: Si tu pipeline no guarda versiones de modelos entrenados o datasets, puedes perder trazabilidad. Solución: Usa herramientas como DVC o almacena artefactos en tu CI/CD.
- Ignorar pruebas de integración: Solo probar el modelo en aislamiento puede llevar a fallos en producción. Solución: Incluye pruebas que simulen el entorno de Kubernetes, como verificar que el contenedor responde a solicitudes HTTP.
- Despliegues sin rollback: Actualizar sin un plan de reversión puede causar downtime. Solución: Configura estrategias de rollout en Kubernetes, como
RollingUpdate, y monitorea métricas para revertir automáticamente si hay errores. - Exponer secretos en el código Hardcodear credenciales en Dockerfiles o scripts es un riesgo de seguridad. Solución: Usa variables de entorno o secretos de Kubernetes, gestionados desde tu CI/CD.
- No optimizar el tamaño de la imagen Docker: Imágenes grandes ralentizan despliegues. Solución: Usa imágenes base ligeras como
python:3.9-alpiney limpia cachés en el Dockerfile.
Checklist de dominio
- ¿Tu pipeline de CI/CD se activa automáticamente al hacer cambios en el repositorio?
- ¿Incluye validación de métricas del modelo (ej., precisión, recall) antes del despliegue?
- ¿Las imágenes Docker se etiquetan con versiones únicas (ej., hash del commit)?
- ¿Tienes configurado un rollback automático en Kubernetes si el despliegue falla?
- ¿Usas secretos gestionados para credenciales en lugar de hardcodearlos?
- ¿El tamaño de tu imagen Docker está optimizado (ej., menos de 500 MB)?
- ¿Documentas cada paso del pipeline para facilitar debugging?
Configurar un pipeline CI/CD básico para un modelo de ML
En este ejercicio, crearás un pipeline de CI/CD simple para automatizar el despliegue de un modelo de clasificación en Kubernetes. Sigue estos pasos:
- Prepara tu entorno: Clona un repositorio de ejemplo con un modelo de ML (ej., desde GitHub) o usa tu propio proyecto. Asegúrate de tener un
Dockerfile,requirements.txt, y un script de entrenamiento. - Crea el archivo de workflow: En la carpeta
.github/workflows/de tu repositorio, crea un archivoml-pipeline.yaml. Basate en el ejemplo de la lección, pero adaptalo para tu modelo. - Configura los secretos: En tu plataforma de CI/CD (ej., GitHub Secrets), agrega variables para Docker Hub (usuario y contraseña) y para Kubernetes si es necesario.
- Prueba el pipeline: Haz un push a la rama main y verifica que el pipeline se ejecute correctamente, entrenando el modelo, construyendo la imagen y desplegando.
- Verifica el despliegue: Usa
kubectl get podspara confirmar que tu contenedor está corriendo en Kubernetes.
Pistas
- Si el pipeline falla en la etapa de entrenamiento, revisa que las dependencias en requirements.txt estén correctas.
- Para reducir el tamaño de la imagen Docker, considera usar una imagen base más ligera como python:3.9-alpine.
- Asegúrate de que los secretos en GitHub estén bien configurados y que los nombres coincidan con los usados en el workflow.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.