

Lección 12 de 20 · Lectura y práctica
Usar Volumes para Persistencia de Datos y Modelos
Tipo de lección: VideoConcepto claveEn el mundo de los pipelines de Machine Learning, la persistencia de datos y modelos es como tener una bodega bien organizada para tu restaurante. Imagina que cada vez que cocinas (entrenas un.
Del concepto a la práctica
Taller de esta lección
La persistencia responde a una pregunta concreta: qué estado debe sobrevivir al reemplazo de un contenedor o Pod. Un volumen conserva bytes, pero no decide si esos bytes son válidos, versionados o compatibles con el código que los lee.
Ejemplo resuelto
Un entrenamiento escribe /models/model-004.joblib en un volumen y un archivo metadata.json con model_id=004. Tras recrear el contenedor, ambos existen. Si solo aparece el modelo sin metadatos, la aplicación no puede comprobar su procedencia y debe rechazarlo.
Pruébalo
Monta un volumen en
/models.Escribe un modelo pequeño y sus metadatos.
Elimina el contenedor y crea otro con el mismo volumen.
Valida que el identificador del archivo coincida con
metadata.json.
Error frecuente: guardar el modelo en la capa escribible del contenedor. Corrección: monta explícitamente el directorio persistente.
Comprueba tu resultado
Después de recrear el contenedor deben estar presentes ambos archivos y el identificador 004 debe coincidir. Un volumen vacío o un metadato incompatible debe producir un diagnóstico, no una predicción silenciosa.
Metadatos, ciclo de vida y acceso
Metadatos completos de prueba: {"model_id":"004","archivo":"model-004.joblib","features":["x1","x2"],"entorno":"requirements.lock","run_id":"prueba-004"}. Registra también el hash calculado del archivo real; no inventes su valor. Exige que coincidan ruta, ID, esquema y versión del entorno antes de cargar un artefacto propio. Un volumen conserva bytes, pero no garantiza integridad ni funciona como copia de seguridad.
Docker conserva la capa al detener un contenedor y la pierde al eliminarlo. En Kubernetes emptyDir sobrevive al reinicio de un contenedor dentro del mismo Pod, pero no al reemplazo de ese Pod; para otra duración usa PVC/almacenamiento externo. ReadWriteOnce permite escritura desde un nodo, no necesariamente un único Pod; no presupongas que servirá a réplicas en nodos distintos. Comprueba StorageClass, estado Bound y permisos. No uses una limpieza global de volúmenes para terminar este ejercicio. Persistencia Kubernetes.
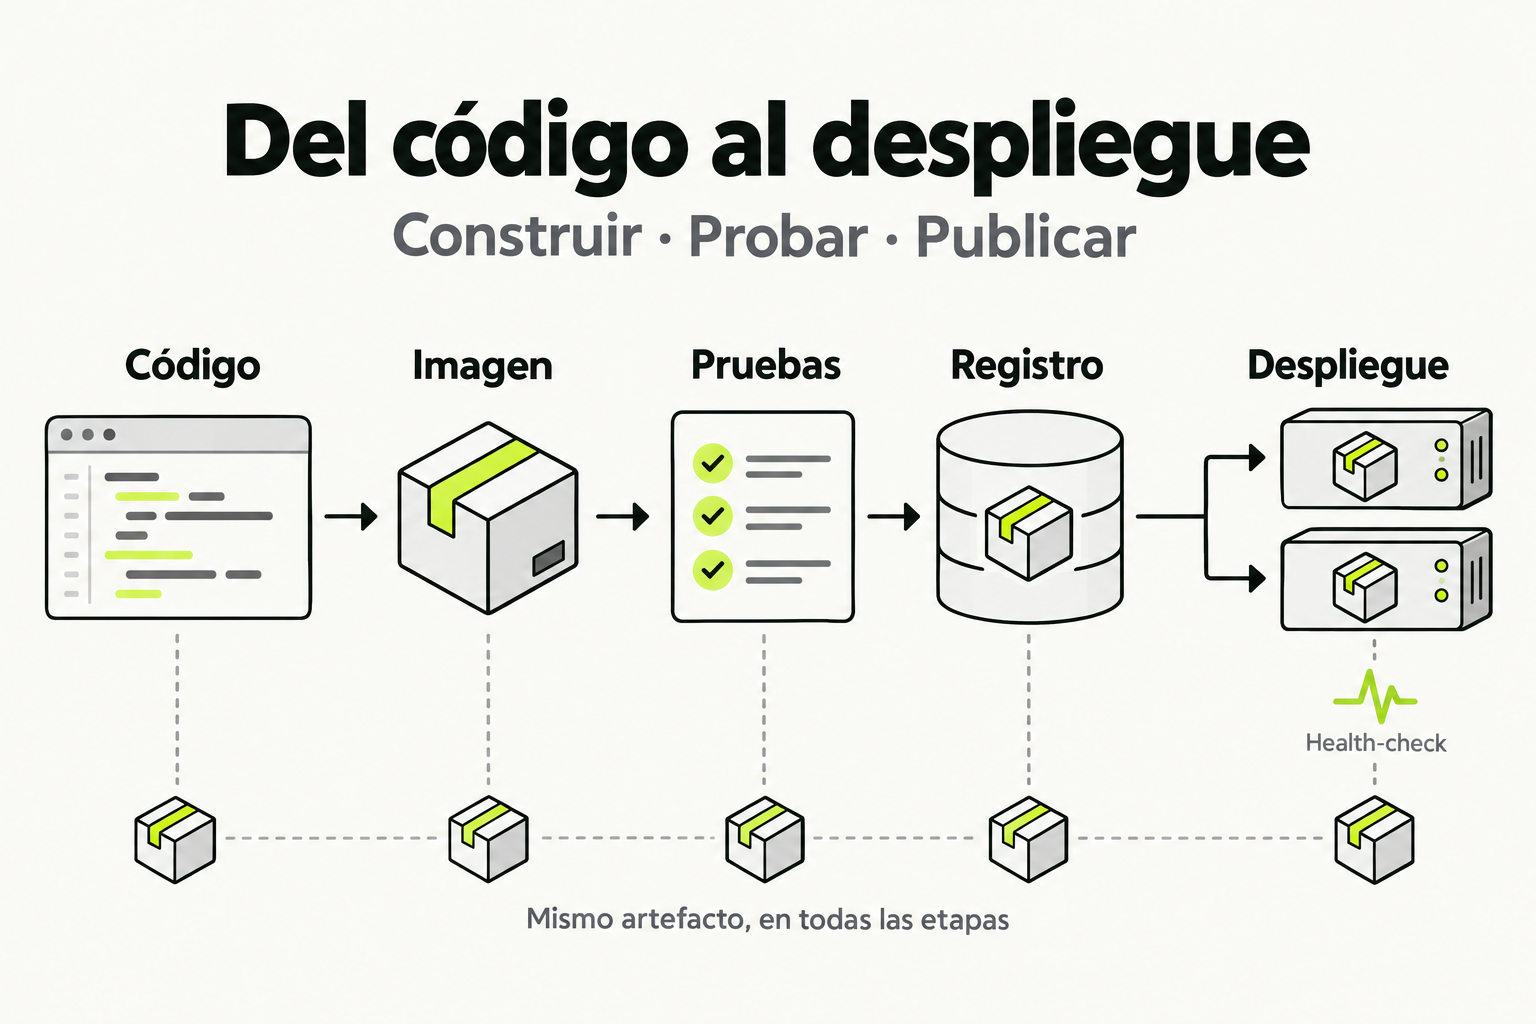
 Mapa de práctica
El código se empaqueta en una imagen y se prueba antes de publicarlo. Esa misma imagen se guarda en un registro y se usa en el despliegue. Comprobar la salud de las instancias permite detectar un fallo sin reconstruir el artefacto.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
En el mundo de los pipelines de Machine Learning, la persistencia de datos y modelos es como tener una bodega bien organizada para tu restaurante. Imagina que cada vez que cocinas (entrenas un modelo), tuvieras que comprar todos los ingredientes desde cero y tirar las recetas exitosas. Los volumes en Docker y Kubernetes son esa bodega que mantiene tus ingredientes (datos) y recetas (modelos) seguros y accesibles entre ejecuciones.
Un volume es un mecanismo para persistir datos generados y utilizados por contenedores Docker. A diferencia del sistema de archivos efímero del contenedor, que se destruye cuando el contenedor se detiene, los volumes sobreviven al ciclo de vida del contenedor. En Kubernetes, esto se extiende con PersistentVolumes y PersistentVolumeClaims, que abstraen los detalles del almacenamiento subyacente (como discos en la nube o sistemas NAS).
Cómo funciona en la práctica
Veamos un escenario típico: tienes un pipeline de ML que carga datos de entrenamiento, entrena un modelo, y guarda el modelo entrenado. Sin volumes, cada vez que el contenedor se reinicia, pierdes el modelo. Con volumes, montas un directorio persistente donde guardar el modelo.
Paso 1: Define un volume en tu Dockerfile o docker-compose.yml. Paso 2: En tu script de entrenamiento, guarda el modelo en la ruta montada. Paso 3: En Kubernetes, creas un PersistentVolumeClaim para solicitar almacenamiento, y montas ese claim en tu pod. Así, aunque el pod falle y se reinicie, el modelo persiste.
Codigo en accion
Primero, un ejemplo con Docker Compose para desarrollo local:
version: '3.8'
services:
  ml-training:
    build: .
    volumes:
      - model-storage:/app/models
    command: python train.py

volumes:
  model-storage:
Ahora, en Kubernetes para producción. Archivo pvc.yaml:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ml-model-pvc
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 1Gi
Archivo deployment.yaml:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: ml-deployment
spec:
  replicas: 1
  selector:
    matchLabels:
      app: ml-app
  template:
    metadata:
      labels:
        app: ml-app
    spec:
      containers:
      - name: ml-container
        image: your-ml-image:latest
        volumeMounts:
        - name: model-storage
          mountPath: /app/models
        command: ["python", "train.py"]
      volumes:
      - name: model-storage
        persistentVolumeClaim:
          claimName: ml-model-pvc
Errores comunes
- No verificar permisos de escritura: Al montar volumes, asegúrate de que el usuario dentro del contenedor tenga permisos para escribir en el directorio montado. Usa
chmodo configura el usuario en el Dockerfile. - Confundir volumes con bind mounts: Los bind mounts dependen de la estructura del host, mientras que los volumes son gestionados por Docker. Para portabilidad en Kubernetes, usa volumes.
- Olvidar limpiar volumes no utilizados: Los volumes pueden acumularse y consumir espacio. Usa
docker volume pruneo gestiona lifecycle policies en Kubernetes. - No probar la persistencia en reinicios: Siempre prueba que los datos sobreviven a un reinicio del contenedor o pod antes de pasar a producción.
Checklist de dominio
- Puedo explicar la diferencia entre el sistema de archivos efímero de un contenedor y un volume persistente.
- Sé cómo definir y usar un volume en Docker Compose para un proyecto de ML.
- Puedo crear un PersistentVolumeClaim y montarlo en un pod de Kubernetes.
- Entiendo cómo configurar permisos para evitar errores de escritura en volumes.
- Puedo listar y limpiar volumes no utilizados en Docker y Kubernetes.
- Sé cómo estructurar mi código de ML para guardar y cargar modelos desde rutas montadas.
- Puedo probar la persistencia de datos tras reiniciar un contenedor o pod.
Implementar persistencia para un modelo de clasificación de imágenes
En este ejercicio, containerizarás un pipeline simple de ML que entrena un modelo de clasificación de imágenes y usa volumes para persistir el modelo entrenado.
- Clona el repositorio de ejemplo:
git clone https://github.com/ejemplo/ml-volume-demo.git - Examina el archivo
train.py. Actualmente guarda el modelo en/tmp/model.pkl. Modifícalo para guardar en/app/models/model.pkl. - Crea un Dockerfile que:
- Use una imagen base de Python 3.9
- Copie el código y instale dependencias (scikit-learn, pandas)
- Cree el directorio
/app/modelsy establezca permisos adecuados - Defina un volume para
/app/models
- Construye la imagen:
docker build -t ml-model:latest . - Crea un archivo
docker-compose.ymlque:- Defina un servicio usando la imagen construida
- Monte un volume llamado
model-storageen/app/models
- Ejecuta con
docker-compose upy verifica que el modelo se guarde. - Detén el contenedor con
docker-compose downy vuelve a ejecutar. El modelo debería persistir.
Pistas
- Recuerda que en Dockerfile, puedes usar VOLUME /app/models para declarar el punto de montaje.
- En docker-compose.yml, define el volume en la sección 'volumes' a nivel superior y refiérelo en el servicio.
- Si tienes errores de permisos, agrega 'USER root' en el Dockerfile temporalmente para debug.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Containerización y Despliegue de Modelos de ML con Docker y Kubernetes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.