

Lección 19 de 25 · Lectura y práctica
Práctica: Implementación de un Sistema RAG Híbrido con pgvector
Concepto claveUn sistema RAG híbrido con pgvector combina la potencia de las búsquedas vectoriales con las capacidades relacionales tradicionales de PostgreSQL. Imagina que tienes una biblioteca donde no solo puedes buscar libros.
Del concepto a la práctica
Taller de esta lección
Un sistema híbrido combina una condición relacional con la similitud vectorial en la misma consulta. Así se evita recuperar contenido semánticamente parecido pero perteneciente a otro cliente, idioma o estado editorial. El filtro debe aplicarse según una regla de negocio explícita y auditable.
Ejemplo resuelto
Considera fragmentos(id, tenant, idioma, publicado, embedding). Hay cuatro filas: a, b y c pertenecen a acme; d pertenece a beta. Solo a y c están publicadas en español. La consulta es:
SELECT id, 1 - (embedding <=> '[1,0]'::vector) AS similitud
FROM fragmentos
WHERE tenant = 'acme' AND idioma = 'es' AND publicado = TRUE
ORDER BY embedding <=> '[1,0]'::vector
LIMIT 2;
El resultado solo puede contener a y c, ordenados por similitud.
Este ejercicio realiza búsqueda vectorial filtrada; una búsqueda híbrida que combine coincidencia textual y vectores necesita además un ranking léxico y una regla de fusión. Deriva el tenant de la sesión autorizada en el servidor. Permitir que el usuario escriba cualquier tenant en la consulta no impone control de acceso. Comprueba que cambiar la pregunta o el límite nunca devuelve d; el permiso debe mantenerse incluso si d tiene la mejor similitud.
Pruébalo
Crea una muestra aislada: a=
acme,es,true,[0.8,0.6]; b=acme,en,true,[1,0]; c=acme,es,true,[0.4,0.916515139]; d=beta,es,true,[1,0].Consulta
[1,0]: las distancias de a y c son aproximadamente 0,2 y 0,6.Ejecuta la consulta.
Cambia
publicadoa falso enay repite.
Comprueba tu resultado
Primero deben aparecer a, luego c; tras despublicar a, solo aparece c.
Error frecuente: filtrar después de recuperar resultados en la aplicación. Corrígelo llevando la condición al WHERE, para que el límite no consuma plazas con datos no autorizados.
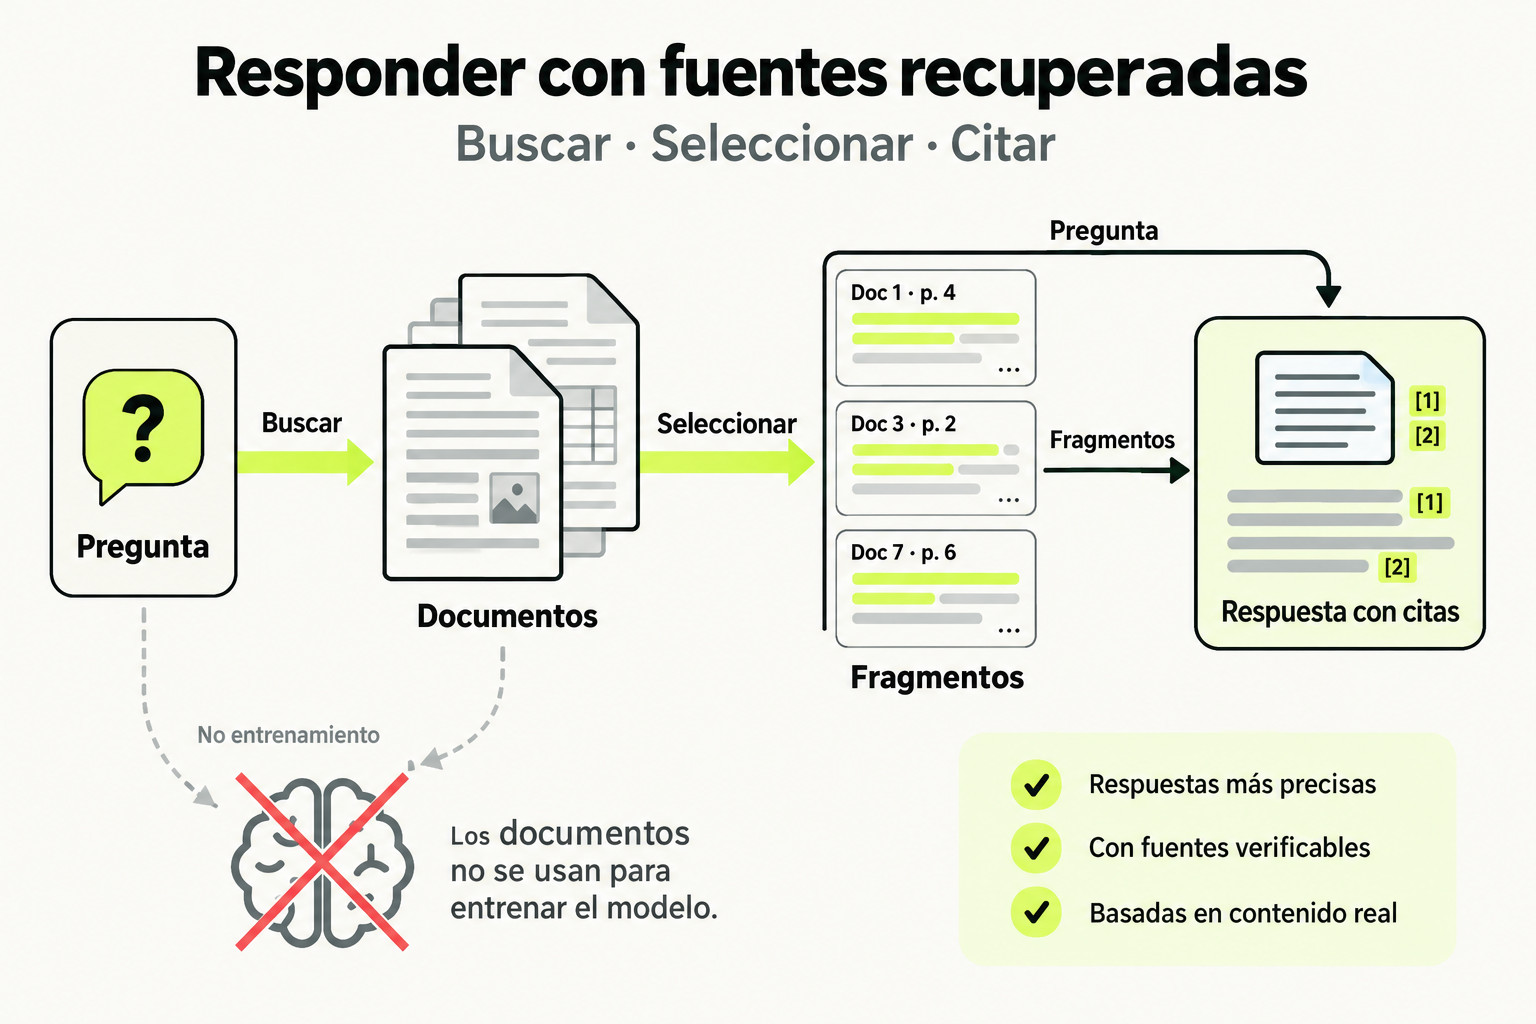
 Mapa de práctica
La pregunta guía la búsqueda de documentos relevantes. Los fragmentos recuperados y sus identificadores acompañan a la pregunta al generar la respuesta. Las citas permiten revisar el respaldo; recuperar documentos no equivale a entrenar el modelo.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
Un sistema RAG híbrido con pgvector combina la potencia de las búsquedas vectoriales con las capacidades relacionales tradicionales de PostgreSQL. Imagina que tienes una biblioteca donde no solo puedes buscar libros por título (búsqueda tradicional), sino también por "sentimiento" o "estilo" (búsqueda vectorial). pgvector permite almacenar y consultar embeddings de texto directamente en PostgreSQL, creando una base de datos que entiende tanto datos estructurados como semántica.
La arquitectura híbrida es crucial porque muchos sistemas reales necesitan filtrar por metadatos (como fecha, categoría o usuario) antes de realizar la búsqueda semántica. Por ejemplo, en un sistema de soporte técnico, primero querrías filtrar por "producto X" y luego buscar preguntas similares. pgvector integra esto en una sola consulta SQL, evitando la complejidad de mantener múltiples sistemas.
"La verdadera ventaja de pgvector no es solo almacenar vectores, sino combinarlos con 30 años de evolución de bases de datos relacionales."
Cómo funciona en la práctica
Implementar un sistema RAG con pgvector sigue estos pasos:
- Preparar la base de datos: Instalar la extensión pgvector y crear tablas con columnas vectoriales.
- Generar y almacenar embeddings: Usar un modelo como sentence-transformers para convertir documentos en vectores y guardarlos en PostgreSQL.
- Consultar híbridamente: Combinar filtros SQL tradicionales con búsqueda por similitud vectorial usando operadores como <-> (distancia euclidiana).
- Integrar con LLM: Tomar los resultados relevantes y usarlos como contexto para un modelo como GPT-4.
Ejemplo de una tabla:
| id | contenido | embedding | categoria | fecha |
|---|---|---|---|---|
| 1 | "Cómo configurar pgvector" | [0.1, 0.2, ...] | tutorial | 2024-01-15 |
| 2 | "Errores comunes en RAG" | [0.3, 0.4, ...] | debugging | 2024-02-20 |
Caso de estudio
Una empresa de e-learning implementó un asistente de preguntas sobre sus cursos usando pgvector. Tenían 10,000 fragmentos de video-transcripciones almacenados en PostgreSQL con metadatos como curso_id, dificultad y duración. Cuando un estudiante pregunta "¿Cómo optimizar consultas SQL?", el sistema:
- Filtra por curso_id = "bases-de-datos"
- Busca los 5 fragmentos más similares usando embeddings
- Combina esos fragmentos en un contexto para GPT-4
- Genera una respuesta precisa citando los videos relevantes
Esto redujo el tiempo de respuesta de soporte en un 70% y mejoró la precisión versus usar solo búsqueda por palabras clave.
Errores comunes
- No normalizar vectores: pgvector funciona mejor con vectores normalizados (magnitud ~1). Usa
embedding / norm(embedding)al almacenar. - Ignorar índices: Sin un índice HNSW o IVFFlat, las consultas serán lentas con más de 10,000 vectores. Crea índices después de insertar datos.
- Mezclar distancias: Usar distancia euclidiana (<->) cuando necesitas similitud coseno. Para similitud coseno, usa 1 - (embedding <=> query_embedding).
- Olvidar mantenimiento: Los índices vectoriales necesitan
REINDEXdespués de muchas inserciones para mantener el rendimiento. - Embeddings de mala calidad: Usar un modelo genérico para dominios especializados (médico, legal) dará resultados pobres. Fine-tune o elige modelos de dominio.
Checklist de dominio
- Puedo instalar y configurar la extensión pgvector en PostgreSQL 12+
- Sé crear tablas con columnas
vector(768)y definir índices HNSW apropiados - He implementado un pipeline que genera embeddings y los inserta en PostgreSQL
- Puedo escribir consultas SQL que combinen filtros WHERE con ORDER BY usando operadores vectoriales
- He integrado los resultados de pgvector con un LLM via API (OpenAI, Anthropic, o local)
- Sé monitorear el rendimiento de consultas vectoriales con EXPLAIN ANALYZE
- Puedo decidir cuándo usar búsqueda híbrida vs. solo vectorial basado en requisitos del negocio
Implementa un sistema de preguntas y respuestas sobre documentación técnica
Construye un sistema RAG que responda preguntas sobre la documentación de PostgreSQL usando pgvector. Sigue estos pasos:
- Configura el entorno:
- Instala PostgreSQL 15+ con pgvector en un entorno local o cloud
- Crea una base de datos llamada
rag_demoy ejecutaCREATE EXTENSION vector;
- Prepara los datos:
- Descarga 50 páginas de la documentación oficial de PostgreSQL (puedes usar web scraping o archivos markdown)
- Divide cada página en fragmentos de 200-300 palabras
- Genera embeddings para cada fragmento usando el modelo
all-MiniLM-L6-v2(dimensión 384)
- Diseña el esquema:
- Crea una tabla
docscon: id (serial), contenido (text), embedding (vector(384)), categoria (text), url (text) - Inserta todos los fragmentos con sus embeddings y metadatos
- Crea un índice HNSW:
CREATE INDEX ON docs USING hnsw (embedding vector_cosine_ops);
- Crea una tabla
- Implementa la búsqueda híbrida:
- Escribe una función SQL que acepte una pregunta (texto), una categoría opcional, y devuelva los 3 fragmentos más relevantes
- La función debe filtrar por categoría si se provee, y usar similitud coseno
- Prueba con: "¿Cómo crear un índice concurrente?" (categoría: "performance")
- Integra con LLM:
- Usa la API de OpenAI o un modelo local (Llama 3) para generar respuestas basadas en los fragmentos recuperados
- Crea un script Python que: 1) convierte la pregunta en embedding, 2) ejecuta la consulta SQL, 3) envía contexto al LLM
- Evalúa:
- Prueba con 5 preguntas técnicas y verifica que las respuestas sean precisas y citen la documentación correcta
- Mide el tiempo de respuesta end-to-end
Pistas
- Usa pgvector 0.5.0+ para soporte completo de HNSW
- Para similitud coseno en pgvector, la distancia es 1 - (embedding <=> query_embedding) donde <=> es el operador de distancia coseno
- Considera usar un pool de conexiones en tu script Python para mejor rendimiento
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.