

Lección 18 de 25 · Lectura y práctica
Optimización de Rendimiento: Índices y Buenas Prácticas
Concepto claveLa optimizacion de rendimiento en bases de datos vectoriales como pgvector se centra en reducir el tiempo de busqueda de vectores similares, conocido como busqueda por similitud. Imagina una biblioteca con millones.
Del concepto a la práctica
Taller de esta lección
Optimizar una búsqueda vectorial exige medir dos propiedades distintas: latencia y recall. La búsqueda exacta compara todos los vectores; un índice aproximado puede responder antes, pero debe comprobarse que no pierda documentos relevantes. El parámetro elegido solo es válido para el conjunto de datos y la carga que se hayan medido.
Ejemplo resuelto
Para una consulta, la respuesta exacta de referencia es [a,b,c]. Un índice devuelve [a,b,d]. Entonces recall@3 = 2/3 = 66,7%. En un registro simulado separado, la búsqueda exacta tarda 24 ms y la indexada 9 ms: la reducción es 15 ms, o 62,5% respecto a 24 ms.
Pruébalo
Define cinco consultas y sus tres resultados relevantes.
Ejecuta cada consulta de forma exacta y con el índice.
Anota los tres primeros IDs y la latencia en milisegundos.
Calcula recall como relevantes recuperados dividido por relevantes esperados.
Comprueba tu resultado
Con referencia [a,b,c] y resultado [a,b,d], el recall debe ser 66,7%; no lo redondees a 67% si necesitas comparar métricas precisas.
Error frecuente: elegir el índice solo por la menor latencia. Corrígelo rechazando una configuración cuyo recall quede bajo el umbral definido, aunque sea más rápida.
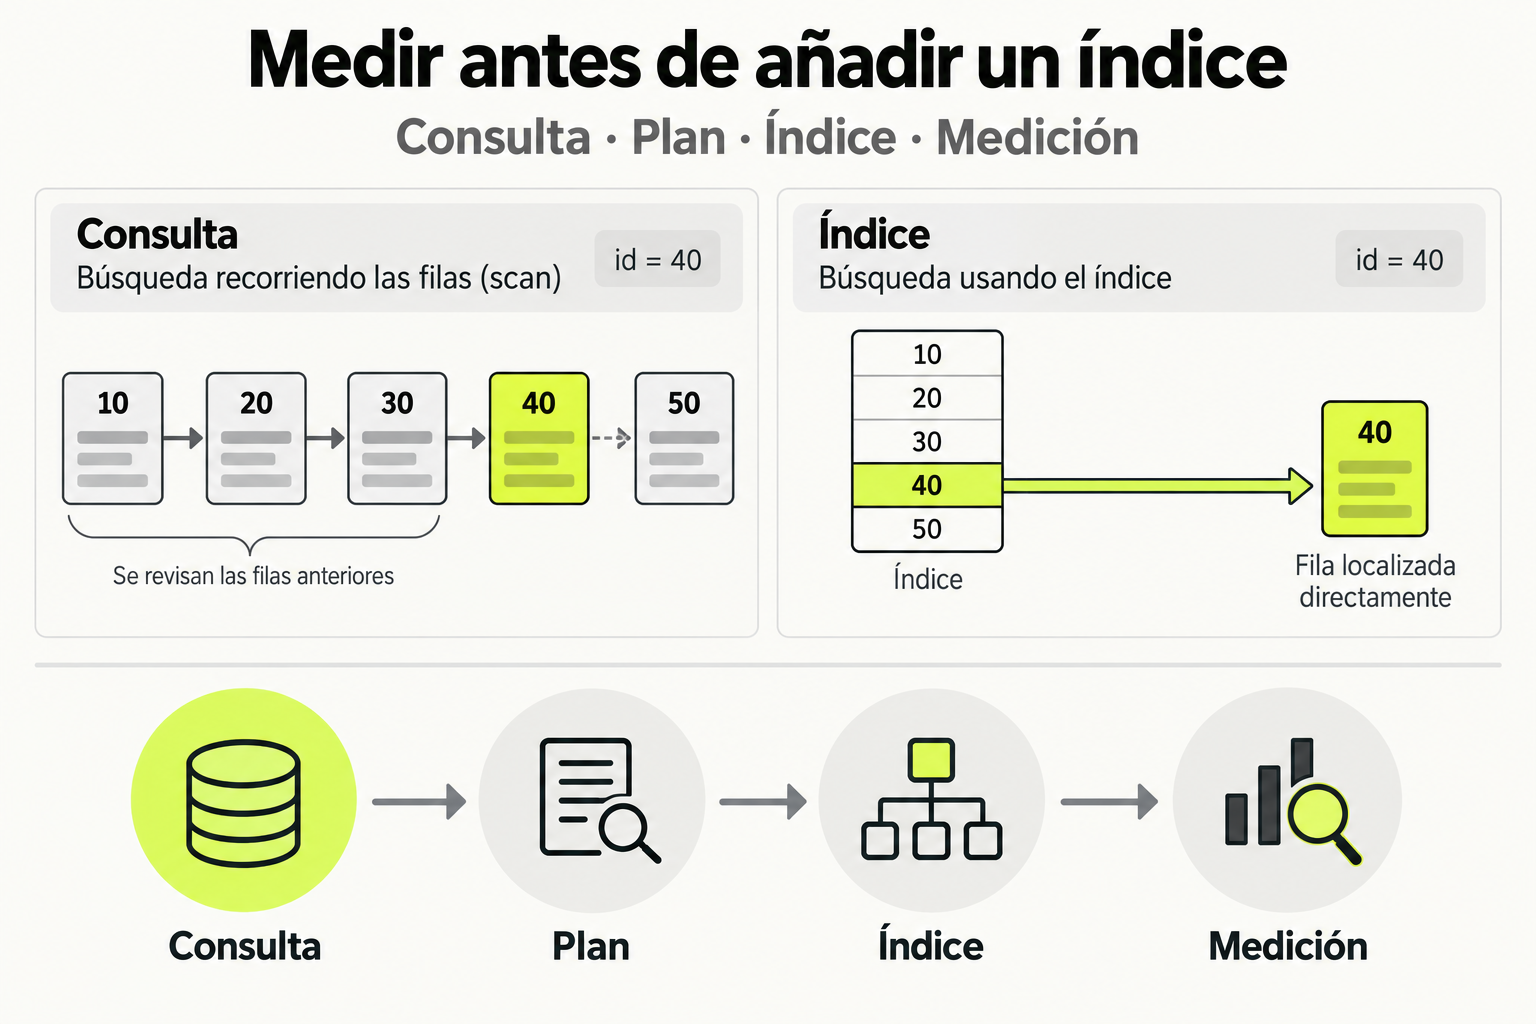
 Mapa de práctica
Un índice puede ayudar a localizar las filas que necesita una consulta. Su utilidad depende del patrón de acceso y del coste de mantenerlo. Mide la consulta, revisa el plan y vuelve a medir después del cambio en lugar de suponer una mejora.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
La optimizacion de rendimiento en bases de datos vectoriales como pgvector se centra en reducir el tiempo de busqueda de vectores similares, conocido como busqueda por similitud. Imagina una biblioteca con millones de libros: sin un sistema de organizacion, encontrar libros similares requeriria revisar cada uno. Los indices vectoriales actuan como un catalogo inteligente que agrupa libros por temas, permitiendo busquedas rapidas. En pgvector, esto se logra mediante algoritmos que precalculan relaciones entre vectores, sacrificando precision minima por ganancias significativas en velocidad.
El rendimiento optimo depende del balance entre recall (capacidad de encontrar todos los vectores relevantes) y latencia (tiempo de respuesta). En sistemas RAG, donde cada consulta del usuario desencadena busquedas vectoriales, una latencia alta puede arruinar la experiencia. Los indices permiten escalar a millones de vectores manteniendo respuestas en milisegundos, crucial para aplicaciones en tiempo real como chatbots o motores de recomendacion.
Como funciona en la practica
pgvector ofrece varios tipos de indices, cada uno con caracteristicas especificas. El mas comun es IVFFlat (Inverted File with Flat Compression), que funciona en dos pasos:
- Entrenamiento: Se toman muestras de los vectores para crear centros (clusters) usando algoritmos como k-means.
- Busqueda: Para un vector de consulta, se buscan los centros mas cercanos y luego se comparan solo los vectores dentro de esos clusters.
Ejemplo de creacion de un indice IVFFlat en PostgreSQL:
CREATE INDEX idx_embeddings_ivfflat ON documentos USING ivfflat (embedding vector_cosine_ops) WITH (lists = 100);El parametro lists controla el numero de clusters: mas lists aumentan la precision pero tambien el tiempo de busqueda. Para 1 millon de vectores, un valor tipico es 100-1000. La busqueda se realiza con:
SELECT id, contenido FROM documentos ORDER BY embedding <=> '[0.1, 0.2, ...]' LIMIT 10;Donde <=> es el operador de distancia coseno. pgvector soporta otras metricas como L2 (euclidiana) y producto interno.
Caso de estudio
Una empresa de e-commerce usa pgvector para un sistema RAG que recomienda productos basados en descripciones de usuarios. Tienen 5 millones de vectores de productos (embedding dimension 384). Inicialmente, las busquedas tomaban 2 segundos, afectando las ventas. Implementaron un indice IVFFlat con lists=500 y ajustaron la configuracion de PostgreSQL:
| Metrica | Antes | Despues |
|---|---|---|
| Latencia promedio | 2000 ms | 50 ms |
| Recall@10 | 100% | 98% |
| Uso de memoria | Bajo | Moderado |
La perdida de 2% en recall es aceptable porque los productos menos relevantes no impactan las recomendaciones, y la ganancia de 40x en velocidad mejora la experiencia de usuario.
Ademas, particionaron la tabla por categoria de producto y usaron HNSW (Hierarchical Navigable Small World) para busquedas exactas en subconjuntos criticos, logrando un balance optimo.
Errores comunes
- Usar listas muy pocas o muchas en IVFFlat: Pocas listas reducen la precision; muchas aumentan la latencia. Solucion: Empezar con sqrt(numero_de_vectores) y ajustar basado en pruebas.
- Ignorar el entrenamiento del indice Crear un indice sin datos representativos lleva a clusters mal formados. Solucion: Insertar al menos 10% de los datos antes de crear el indice, o usar datos de entrenamiento especificos.
- No monitorear el recall Enfocarse solo en velocidad puede resultar en resultados irrelevantes. Solucion: Medir recall periodicamente con un conjunto de prueba y ajustar parametros.
- Olvidar el mantenimiento de la base de datos Inserciones masivas pueden desbalancear los indices. Solucion: Reindexar periodicamente o usar estrategias de actualizacion incremental.
- Usar la metrica de distancia incorrecta Cosine es ideal para texto; L2 para imagenes. Solucion: Elegir basado en el tipo de datos y probar con ejemplos reales.
Checklist de dominio
- He creado un indice IVFFlat en pgvector ajustando el parametro lists segun el tamaño de mis datos.
- He medido el recall y latencia de mis busquedas vectoriales con un conjunto de prueba representativo.
- He configurado PostgreSQL con parametros optimizados para cargas de trabajo vectoriales (ej., shared_buffers, work_mem).
- He considerado el uso de HNSW para casos que requieren alta precision con datos estaticos.
- He implementado una estrategia de mantenimiento para reindexar o actualizar indices periodicamente.
- He elegido la metrica de distancia (coseno, L2, producto interno) apropiada para mi tipo de embeddings.
- He documentado el rendimiento de mi sistema RAG con pgvector, incluyendo metricas clave antes y despues de optimizaciones.
Optimizacion de un Sistema RAG con pgvector
En este ejercicio, optimizaras el rendimiento de un sistema RAG basado en pgvector para una aplicacion de preguntas y respuestas sobre documentacion tecnica. Sigue estos pasos:
- Configura el entorno: Crea una base de datos PostgreSQL con pgvector habilitado. Usa una tabla llamada
docscon columnasid,texto, yembedding(vector de 768 dimensiones). Inserta 100,000 documentos simulados con embeddings generados aleatoriamente. - Mide el rendimiento base: Ejecuta 100 busquedas vectoriales aleatorias sin indice, registrando la latencia promedio y el recall@10 usando un conjunto de 100 consultas de prueba con resultados conocidos.
- Crea y ajusta indices: Implementa un indice IVFFlat con
lists=50. Repite las mediciones de rendimiento. Luego, prueba conlists=200ylists=500, comparando latencia y recall. - Optimiza parametros de PostgreSQL: Ajusta
shared_buffersal 25% de la RAM ywork_mema 64MB. Vuelve a medir el rendimiento con el mejor indice del paso anterior. - Analiza resultados: Genera un informe con una tabla HTML que muestre latencia y recall para cada configuracion, y recomienda la configuracion optima basada en un balance velocidad-precision.
Pistas
- Usa la extension pgvector en PostgreSQL y genera embeddings aleatorios con Python o una herramienta similar para simular datos.
- Para calcular recall@10, define un conjunto de consultas de prueba donde los 10 vectores mas cercanos sean conocidos, y verifica cuantos encuentra tu busqueda.
- Considera que aumentar lists generalmente mejora recall pero aumenta latencia; encuentra un punto de equilibrio para tu caso.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.