

Lección 20 de 25 · Lectura y práctica
Quiz: Evaluación de pgvector y Integración
Tipo de lección: QuizConcepto claveLa integración de pgvector en sistemas RAG transforma PostgreSQL en una base de datos vectorial nativa, permitiendo almacenar y buscar embeddings junto con datos relacionales tradicionales. A.
Del concepto a la práctica
Taller de esta lección
Este repaso comprueba si puedes conectar dimensión, métrica, SQL y consistencia transaccional. La respuesta correcta no depende de memorizar nombres, sino de seguir el recorrido: almacenar vectores compatibles, ordenar por distancia y combinar el resultado con filtros relacionales.
Ejemplo resuelto
En una tabla vector(3), la consulta usa [1,0,0]. Los registros tienen distancias coseno x=0, y=0,25 y z=1. El orden correcto es x, y, z; sus similitudes son 1, 0,75 y 0. Si se solicita LIMIT 2, se recuperan x e y.
Pruébalo
Responde qué ocurre si insertas
[1,0]: debe rechazarse por dimensión.Indica qué operador ordena por distancia coseno:
<=>.Calcula la similitud de distancia
0,4:1 - 0,4.Explica qué debe conservarse junto al vector: el identificador y sus metadatos.
Comprueba tu resultado
Las respuestas son: rechazo por dimensión, <=>, similitud 0,6, e identificación más metadatos.
Error frecuente: confundir la distancia menor con una similitud menor. Corrígelo ordenando ascendentemente por distancia y convirtiéndola a similitud solo al presentar el resultado.
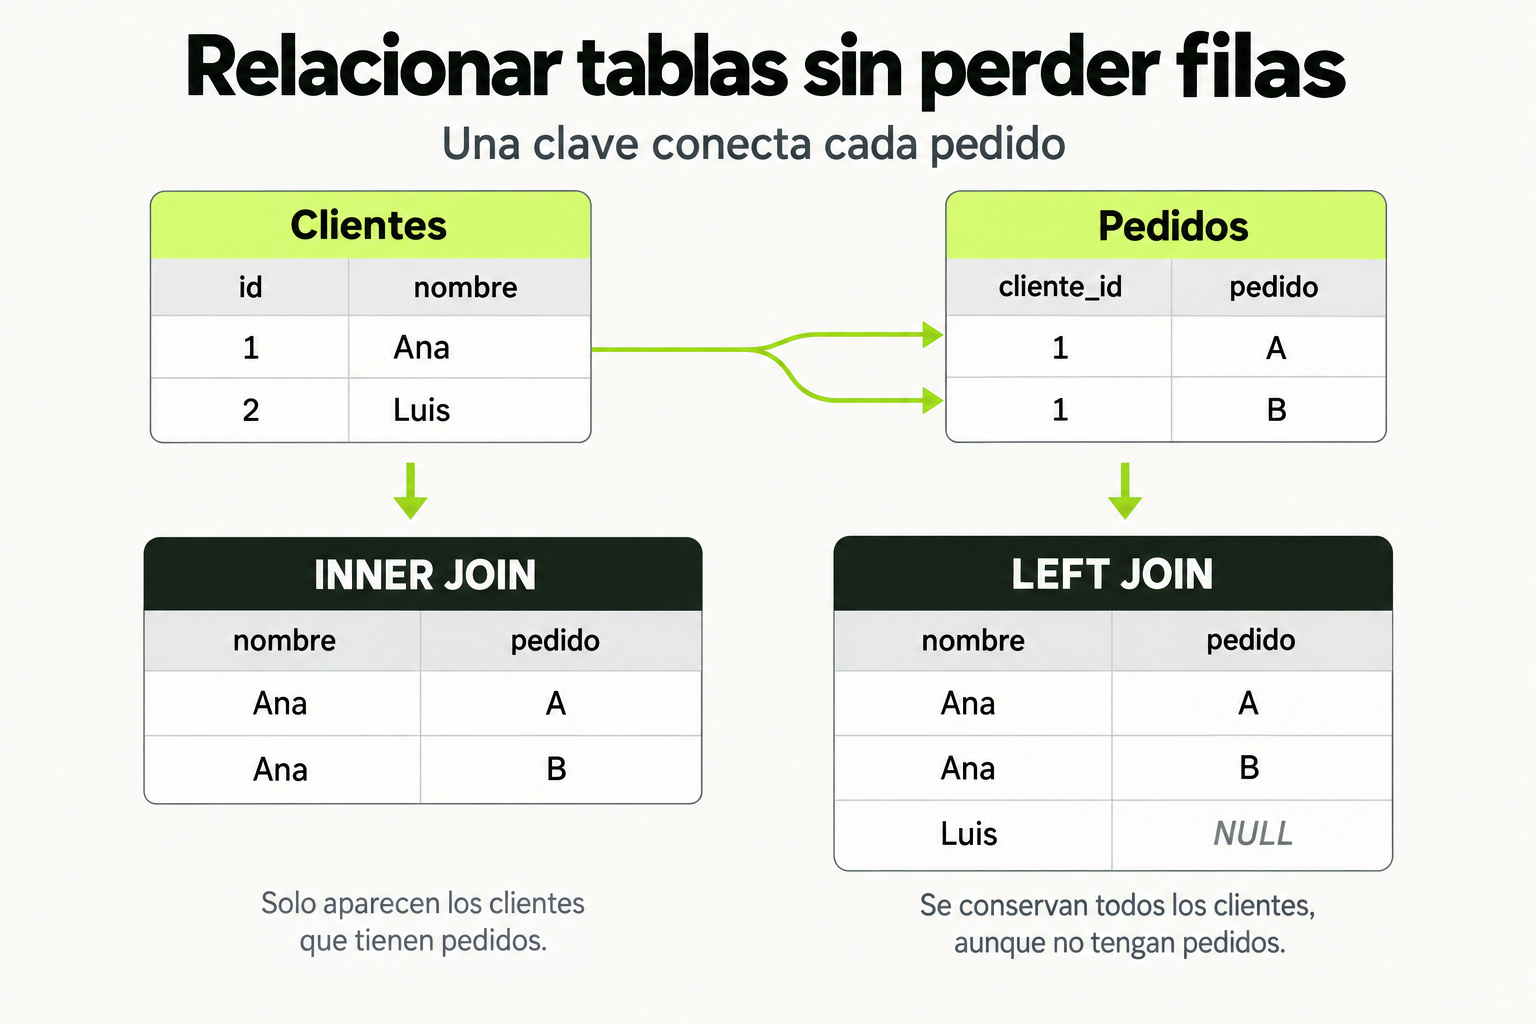
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Quiz
Concepto clave
La integración de pgvector en sistemas RAG transforma PostgreSQL en una base de datos vectorial nativa, permitiendo almacenar y buscar embeddings junto con datos relacionales tradicionales. A diferencia de soluciones externas como Chroma o Pinecone, pgvector opera dentro del mismo motor de base de datos, eliminando la necesidad de sincronización entre sistemas y manteniendo la consistencia ACID.
Imagina que tienes una biblioteca donde cada libro tiene una ficha técnica (datos estructurados) y un resumen vectorizado que captura su contenido semántico. Con pgvector, puedes buscar libros similares por contenido (búsqueda vectorial) y filtrar por autor o año (consultas SQL tradicionales) en una sola operación. Esto es crucial para sistemas RAG donde necesitas recuperar documentos relevantes basados en similitud semántica y luego aplicar lógica de negocio sobre esos resultados.
Cómo funciona en la práctica
Veamos un ejemplo paso a paso de cómo configurar y usar pgvector para un sistema RAG de preguntas y respuestas sobre documentación técnica:
- Primero, instala la extensión pgvector en tu base de datos PostgreSQL:
CREATE EXTENSION IF NOT EXISTS vector; - Crea una tabla que almacene documentos con sus embeddings:
CREATE TABLE technical_docs ( id SERIAL PRIMARY KEY, title VARCHAR(255), content TEXT, embedding VECTOR(1536), -- Dimensión típica para embeddings de OpenAI category VARCHAR(50), created_at TIMESTAMP DEFAULT NOW() ); - Inserta documentos con sus embeddings generados por un modelo como text-embedding-ada-002:
INSERT INTO technical_docs (title, content, embedding, category) VALUES ('Configuración de pgvector', 'Guía completa para instalar y usar pgvector...', '[0.1, -0.2, 0.3, ...]', 'tutorial'); - Realiza una búsqueda semántica para encontrar documentos similares a una consulta del usuario:
SELECT title, content
FROM technical_docs
WHERE category = 'tutorial'
ORDER BY embedding <=> '[0.15, -0.18, 0.28, ...]'
LIMIT 5;
El operador <=> calcula la distancia coseno entre vectores, devolviendo los documentos más similares. Puedes combinar esto con filtros SQL tradicionales para refinar los resultados.
Caso de estudio
Una empresa de e-learning implementó un sistema RAG usando pgvector para su plataforma de cursos. Tenían 50,000 lecciones almacenadas en PostgreSQL, cada una con metadatos (duración, dificultad, instructor) y un embedding del contenido. Cuando un estudiante preguntaba "¿Cómo optimizar consultas SQL lentas?", el sistema:
- Generaba un embedding de la pregunta usando OpenAI
- Buscaba las 10 lecciones más similares en pgvector
- Filtraba por dificultad='intermedia' y duración<30 minutos
- Pasaba los resultados al LLM para generar una respuesta contextualizada
La tabla de resultados mostraba:
| Lección | Similitud | Duración | Instructor |
|---|---|---|---|
| Índices en PostgreSQL | 0.92 | 25 min | María López |
| Optimización de consultas | 0.88 | 28 min | Carlos Ruiz |
| EXPLAIN y ANALYZE | 0.85 | 22 min | Ana Torres |
El tiempo de respuesta promedio se redujo de 2.1 segundos (con Pinecone externo) a 1.4 segundos gracias a la eliminación de latencia de red entre sistemas.
Errores comunes
- Dimensiones incorrectas en los embeddings: Usar una dimensión diferente a la generada por tu modelo de embeddings causa resultados erróneos. Siempre verifica que la columna VECTOR(n) coincida con la dimensión de tus embeddings.
- Falta de índices para búsquedas eficientes: Sin crear índices HNSW o IVFFlat, las búsquedas vectoriales son lentas en conjuntos grandes. Crea índices después de tener datos representativos:
CREATE INDEX ON technical_docs USING hnsw (embedding vector_cosine_ops); - No normalizar vectores antes de almacenarlos: pgvector espera vectores normalizados para la distancia coseno. Normaliza tus embeddings antes de insertarlos o usa la distancia L2 que no requiere normalización.
- Olvidar mantener la consistencia entre embeddings y datos: Si actualizas el contenido de un documento, debes regenerar su embedding. Implementa triggers o procesos batch para mantener la sincronización.
- Usar pgvector para volúmenes masivos sin planificación: Para más de 1 millón de vectores, considera particionamiento o ajuste fino de parámetros de índice. pgvector escala bien pero requiere configuración adecuada.
Checklist de dominio
- ✓ Puedo instalar y habilitar la extensión pgvector en PostgreSQL
- ✓ Sé diseñar tablas con columnas VECTOR de dimensión correcta
- ✓ Puedo realizar búsquedas híbridas (vectorial + SQL) con operadores como <=>
- ✓ Sé crear y mantener índices HNSW/IVFFlat para rendimiento
- ✓ Entiendo cuándo usar distancia coseno vs L2 vs producto interno
- ✓ Puedo integrar pgvector en un pipeline RAG completo
- ✓ Sé monitorear y optimizar el rendimiento de búsquedas vectoriales
Implementación de un sistema RAG con pgvector para documentación de API
En este ejercicio práctico, implementarás un sistema RAG básico usando pgvector para buscar documentación de API relevante. Sigue estos pasos:
- Configuración inicial:
- Crea una base de datos PostgreSQL 15+ (local o en la nube)
- Instala la extensión pgvector ejecutando
CREATE EXTENSION vector;
- Diseño de esquema:
- Crea una tabla
api_docscon estos campos: id (SERIAL), endpoint (VARCHAR), description (TEXT), method (VARCHAR), embedding (VECTOR(1536)) - Inserta 5-10 registros de ejemplo con embeddings ficticios (puedes usar arrays de números aleatorios normalizados)
- Crea una tabla
- Búsqueda semántica:
- Escribe una consulta que busque los 3 endpoints más similares a un embedding de consulta dado
- Agrega un filtro para mostrar solo endpoints con method='GET'
- Optimización:
- Crea un índice HNSW en la columna embedding
- Ejecuta una consulta EXPLAIN para verificar que usa el índice
- Integración simulada:
- Escribe un pseudocódigo que muestre cómo conectarías esta búsqueda a un LLM para generar respuestas
Entrega: Script SQL con todas las operaciones y pseudocódigo de integración.
Pistas
- Recuerda normalizar tus vectores de ejemplo para la distancia coseno
- Usa el operador <=> para búsqueda por similitud coseno en pgvector
- El índice HNSW requiere PostgreSQL 15+ y parámetros como m y ef_construction
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.