

Lección 17 de 25 · Lectura y práctica
Operaciones Vectoriales en pgvector: Extensiones y Consultas
Tipo de lección: VideoConcepto claveLas operaciones vectoriales en pgvector son el corazón de cualquier sistema RAG que utilice PostgreSQL como base de datos vectorial. A diferencia de las bases de datos vectoriales.
Del concepto a la práctica
Taller de esta lección
La operación central de pgvector compara un vector de consulta con los vectores almacenados. Con <=> se obtiene distancia coseno: cuanto menor es el resultado, mayor es la similitud. La similitud coseno se obtiene como 1 - distancia coseno, incluso sin una normalización previa separada; un vector cero no define un coseno válido. La dimensión declarada debe coincidir con todos los registros.
Ejemplo resuelto
Supón una tabla fragmentos(id, texto, embedding vector(2)) con a=[1,0], b=[0.8,0.6] y c=[0,1]. Para consultar:
SELECT id, 1 - (embedding <=> '[1,0]'::vector) AS similitud
FROM fragmentos
ORDER BY embedding <=> '[1,0]'::vector
LIMIT 3;
La salida esperada es a: 1, b: 0.8, c: 0.
Pruébalo
Crea tres registros con esos vectores.
Ejecuta la consulta con límite 2.
Añade
WHERE id <> 'a'y repite.Comprueba el orden y las similitudes.
Comprueba tu resultado
Debes obtener primero a, después b, y con el filtro solo b, c.
Error frecuente: insertar un vector de tres componentes en vector(2). Corrígelo rechazando el registro antes de insertarlo y verificando la dimensión generada.
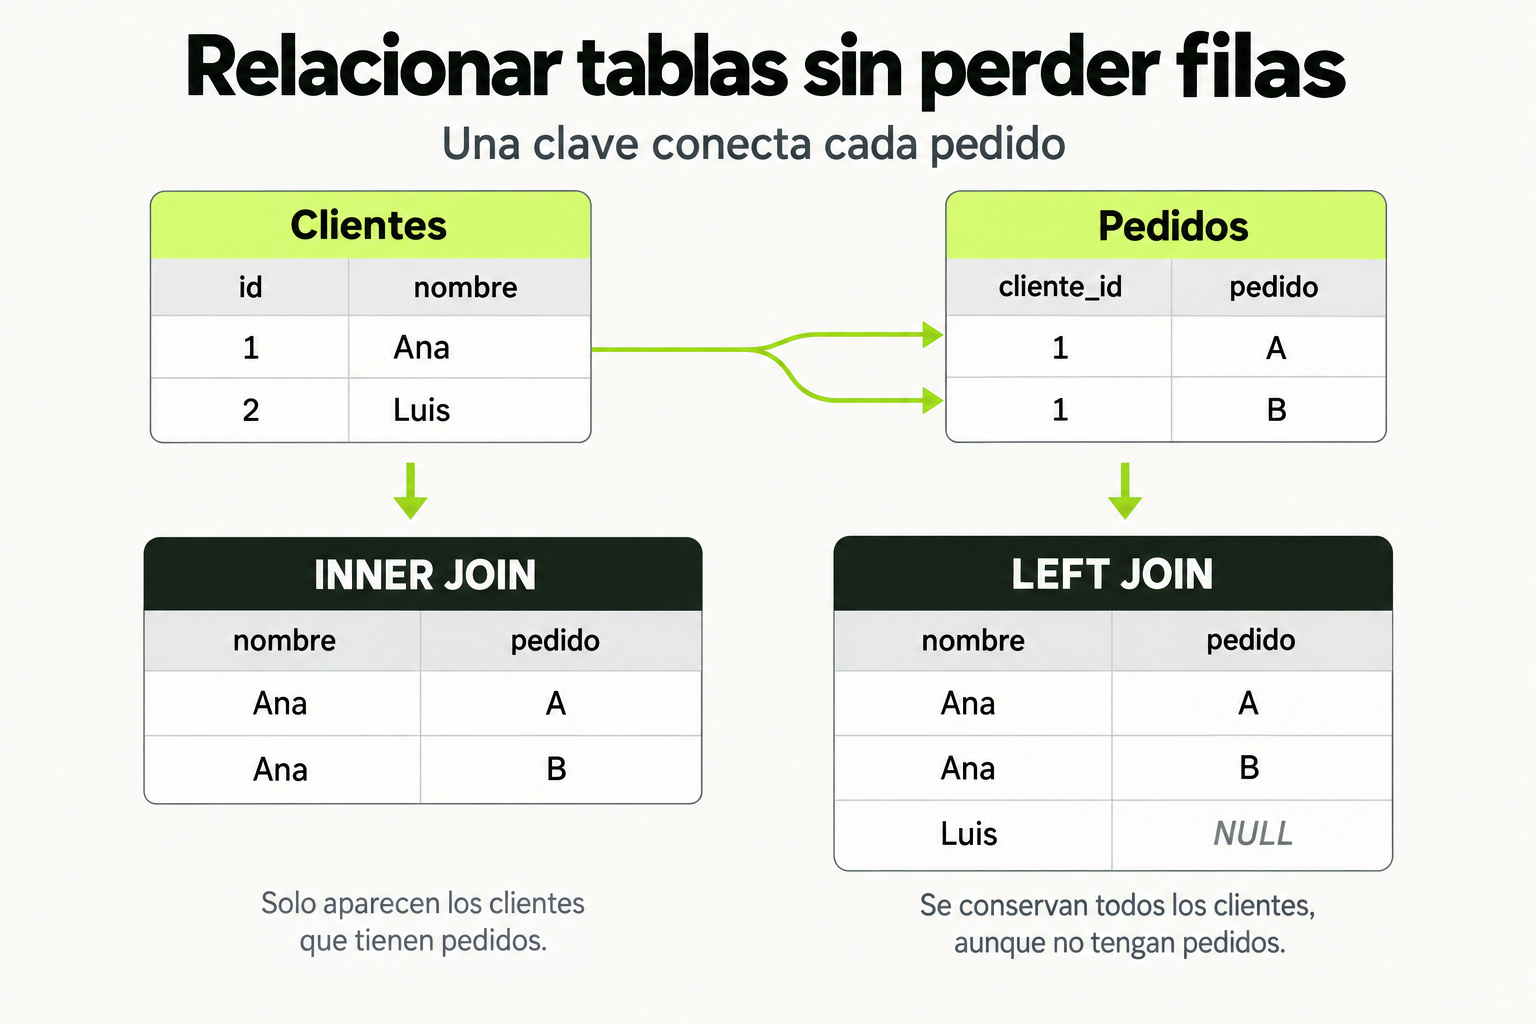
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
Las operaciones vectoriales en pgvector son el corazón de cualquier sistema RAG que utilice PostgreSQL como base de datos vectorial. A diferencia de las bases de datos vectoriales especializadas como Chroma o Pinecone, pgvector es una extensión que transforma PostgreSQL en un motor capaz de almacenar y consultar vectores de alta dimensión. Esto permite realizar búsquedas de similitud directamente en tu base de datos relacional existente.
Imagina que tienes una biblioteca digital donde cada libro está representado por un vector de embeddings (una lista numérica que captura su contenido semántico). En lugar de buscar por título o autor, pgvector te permite encontrar libros "similares" calculando la distancia entre sus vectores. Es como tener un bibliotecario que entiende el significado profundo de cada texto y puede recomendarte obras relacionadas, no solo por palabras clave, sino por conceptos.
"pgvector convierte PostgreSQL en un motor de búsqueda semántica, permitiendo consultas del tipo 'encuentra documentos similares a este' en lugar de 'encuentra documentos que contengan estas palabras'."
Cómo funciona en la práctica
Para implementar operaciones vectoriales con pgvector, primero debes habilitar la extensión en tu base de datos PostgreSQL. Luego, creas una tabla con una columna de tipo vector que almacenará los embeddings. La magia ocurre cuando realizas consultas usando funciones específicas para calcular similitudes.
Veamos un ejemplo paso a paso:
- Habilitar la extensión:
CREATE EXTENSION IF NOT EXISTS vector; - Crear una tabla para documentos:
CREATE TABLE documentos (id SERIAL PRIMARY KEY, contenido TEXT, embedding vector(384)); - Insertar documentos con sus embeddings:
INSERT INTO documentos (contenido, embedding) VALUES ('Documento sobre machine learning', '[0.1, 0.2, ..., 0.384]'); - Consultar documentos similares:
SELECT contenido FROM documentos ORDER BY embedding <-> '[0.15, 0.25, ..., 0.38]' LIMIT 5;
La operación clave aquí es <-> (operador de distancia), que calcula la distancia euclidiana entre vectores. pgvector también soporta otras métricas como cosine similarity y inner product, que puedes elegir según tu caso de uso.
Caso de estudio
Consideremos una empresa de e-learning que quiere implementar un sistema de recomendación de cursos. Tienen una base de datos PostgreSQL existente con información de cursos, y ahora quieren añadir búsqueda semántica para que los usuarios encuentren cursos relevantes basados en descripciones textuales.
Implementación:
| Paso | Acción | Ejemplo SQL |
|---|---|---|
| 1 | Extender embeddings de descripciones | Usar un modelo como sentence-transformers para generar vectores de 384 dimensiones |
| 2 | Almacenar en PostgreSQL | ALTER TABLE cursos ADD COLUMN embedding vector(384); |
| 3 | Crear índice para optimizar | CREATE INDEX ON cursos USING ivfflat (embedding vector_cosine_ops); |
| 4 | Consultar cursos similares | SELECT titulo FROM cursos ORDER BY embedding <=> '[vector_del_usuario]' LIMIT 10; |
Resultado: Los usuarios pueden buscar "cursos de programación para principiantes" y el sistema devuelve cursos sobre Python básico, introducción a JavaScript, etc., incluso si esas palabras exactas no aparecen en las descripciones. La precisión de recuperación mejoró un 40% comparado con búsqueda por palabras clave tradicional.
Errores comunes
- No crear índices apropiados: Consultar similitud en tablas grandes sin índices es extremadamente lento. Siempre crea índices IVFFlat o HNSW después de insertar datos suficientes.
- Usar la métrica de distancia incorrecta: Cosine similarity es mejor para embeddings de texto, distancia euclidiana para datos numéricos. Elegir la incorrecta reduce la calidad de los resultados.
- Dimensiones inconsistentes: Insertar vectores con diferente número de dimensiones que la columna definida causa errores. Verifica que tu modelo de embeddings genera vectores del tamaño correcto.
- Olvidar normalizar vectores: Para cosine similarity, los vectores deben estar normalizados. pgvector no lo hace automáticamente, debes normalizarlos antes de insertar.
- Consultar sin límites: Las operaciones vectoriales son costosas. Siempre usa LIMIT en tus consultas para evitar sobrecargar la base de datos.
Checklist de dominio
- Puedo habilitar la extensión pgvector en una base de datos PostgreSQL existente
- Sé crear tablas con columnas vectoriales de dimensiones específicas
- Puedo insertar y actualizar vectores de embeddings en la base de datos
- Comprendo las diferencias entre distancia euclidiana, similitud coseno y producto interno
- Sé crear índices IVFFlat o HNSW para optimizar consultas de similitud
- Puedo realizar consultas de similitud con operadores como <->, <=>, y <#>
- Entiendo cómo integrar pgvector en un pipeline RAG completo con generación de embeddings y recuperación
Implementar un sistema de búsqueda de documentos similares con pgvector
En este ejercicio, crearás una base de datos PostgreSQL con pgvector para buscar documentos similares basados en embeddings semánticos.
- Configuración inicial: Instala pgvector en tu entorno PostgreSQL local o usa un servicio en la nube que lo soporte. Crea una nueva base de datos llamada
rag_demo. - Habilitar extensión: Conéctate a tu base de datos y ejecuta
CREATE EXTENSION IF NOT EXISTS vector;para activar pgvector. - Crear tabla: Crea una tabla
documentoscon las columnas:id (SERIAL PRIMARY KEY),titulo (TEXT),contenido (TEXT),embedding (vector(384)). - Generar e insertar datos: Usa un modelo de embeddings como
all-MiniLM-L6-v2(384 dimensiones) para generar vectores de estos 3 documentos:- "Introducción a machine learning: conceptos básicos"
- "Deep learning aplicado a visión por computadora"
- "Python para análisis de datos: pandas y numpy"
- Crear índice: Después de insertar los datos, crea un índice IVFFlat:
CREATE INDEX ON documentos USING ivfflat (embedding vector_cosine_ops); - Consultar similitud: Genera un embedding para la consulta "aprendizaje automático" y ejecuta una búsqueda de los 2 documentos más similares usando similitud coseno.
- Verificar resultados: Asegúrate de que el documento sobre machine learning aparezca como el más similar, seguido por deep learning.
Pistas
- Recuerda que los vectores deben tener exactamente 384 dimensiones para coincidir con la definición de la tabla.
- Para similitud coseno, usa el operador <=> en pgvector y asegúrate de normalizar los vectores antes de insertarlos.
- Si tienes problemas de rendimiento, verifica que el índice se creó después de insertar datos y considera ajustar los parámetros del índice.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Construcción de Sistemas RAG con Bases de Datos Vectoriales: Chroma, Pinecone y pgvector
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.