

Lección 15 de 20 · Lectura y práctica
Quiz: Integración y Automatización ETL
Tipo de lección: QuizConcepto claveLa integración de Apache Airflow con herramientas de datos y la automatización ETL se centra en orquestar flujos de trabajo complejos donde múltiples sistemas deben colaborar de manera.
Del concepto a la práctica
Taller de esta lección
La integración ETL se evalúa siguiendo el dato desde su origen hasta el destino. Una conexión autorizada no garantiza una carga correcta: todavía hay que comprobar esquema, tipos, cardinalidad, sumas y comportamiento ante repetición. El orquestador coordina tareas, pero la lógica de calidad debe estar expresada en código o consultas verificables.
Ejemplo resuelto
Un lote contiene cuatro filas, una duplicada por venta_id. La extracción cuenta cuatro; la deduplicación conserva tres; los importes válidos suman 12+7+5=24; la carga guarda tres filas y total 24. Cada diferencia entre etapas queda explicada.
Pruébalo
Registra el conteo inmediatamente después de extraer.
Identifica duplicados por una clave definida.
Valida tipos y calcula el total de filas válidas.
Compara esos indicadores con la tabla de destino.
Comprueba tu resultado
Error frecuente: declarar éxito porque la tarea terminó sin excepción, aunque el destino tenga cuatro filas duplicadas. Corrige añadiendo aserciones de conteo y unicidad. El resultado esperado es extraídas=4, únicas=3, cargadas=3, total=24; cualquier discrepancia debe marcar la ejecución como fallida o incompleta.
Duplicado explícito y límite temporal
[{"venta_id":"V1","fecha":"2026-10-07","importe":12},{"venta_id":"V2","fecha":"2026-10-07","importe":7},{"venta_id":"V3","fecha":"2026-10-07","importe":5},{"venta_id":"V2","fecha":"2026-10-07","importe":7}]La clave es (venta_id,fecha) y el duplicado repite exactamente los mismos valores. Conserva una copia y registra una aparición duplicada: cuatro extraídas, tres únicas, total=24. Si la segunda V2 tuviera un importe distinto, falla el lote como conflicto; no elijas al azar. Usa upsert para conservar tres identidades al repetir.
Una extracción SQL por timestamp usa >= inicio AND < fin parametrizados; {{ ds }} representa una fecha lógica y no reemplaza por sí sola esa ventana. Las Connections o un backend de secretos guardan credenciales; las Variables de configuración comunes no deben convertirse en un sustituto indiscriminado del gestor de secretos. No se requieren cuentas cloud para esta prueba local.
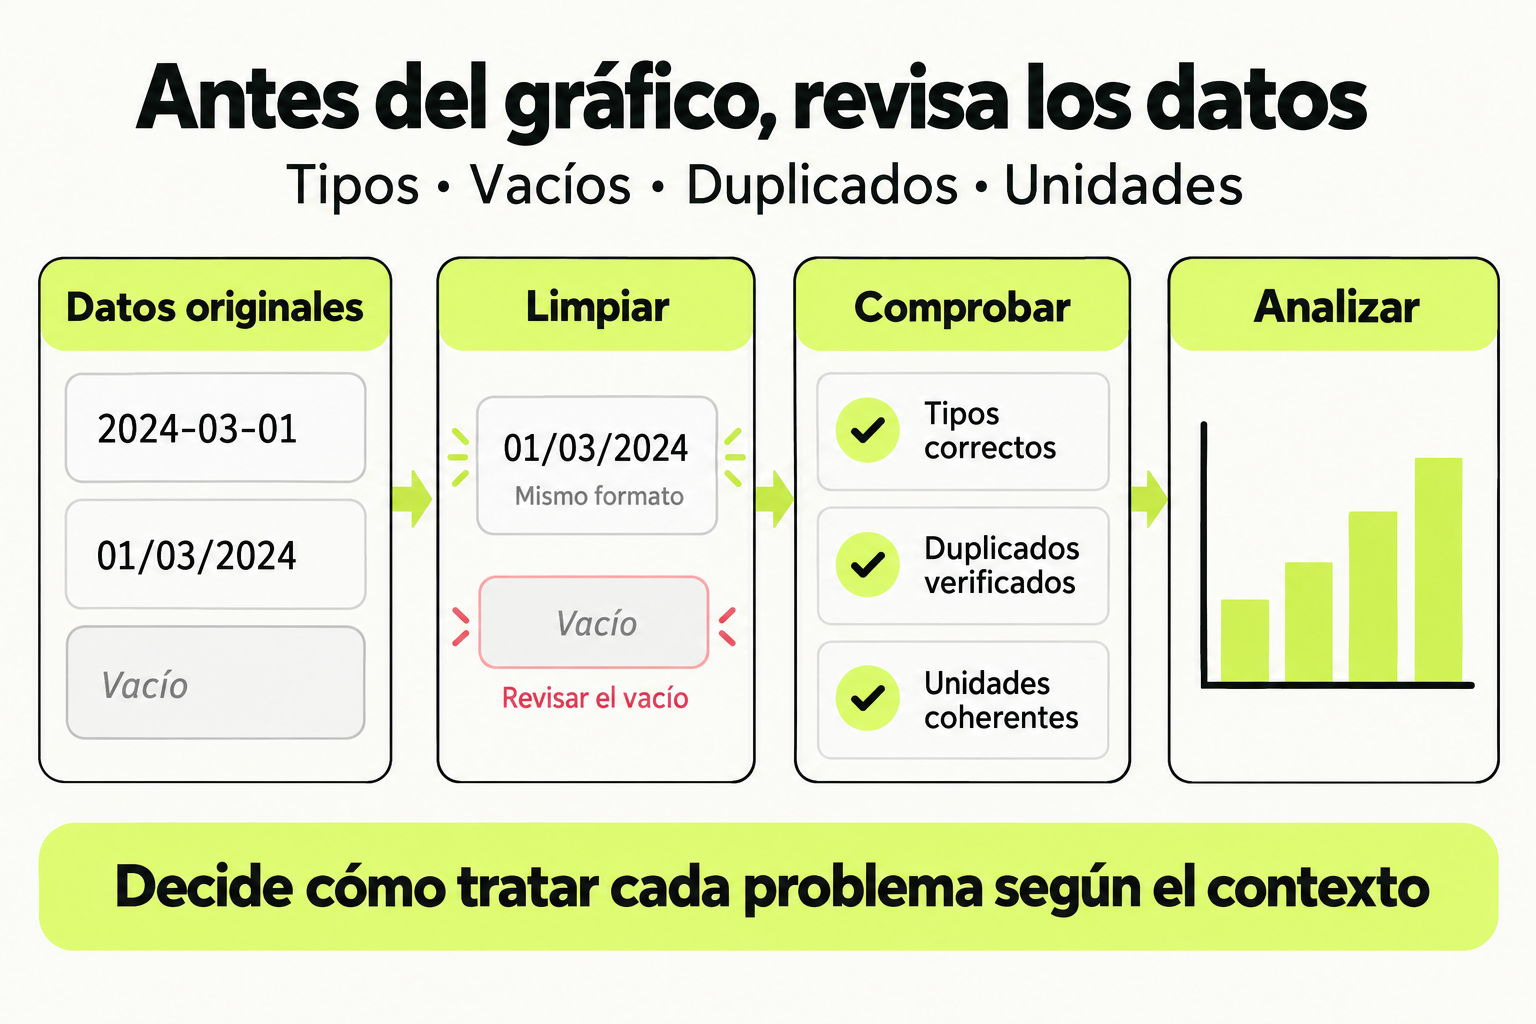
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
La integración de Apache Airflow con herramientas de datos y la automatización ETL se centra en orquestar flujos de trabajo complejos donde múltiples sistemas deben colaborar de manera coordinada. Imagina que eres el director de una orquesta: Airflow es el director que marca el tempo y coordina a cada músico (herramienta), asegurando que todos toquen en el momento correcto y en armonía. En este contexto, las herramientas de datos pueden ser bases de datos, servicios en la nube, APIs o plataformas de procesamiento como Spark.
La automatización ETL va más allá de simplemente ejecutar tareas; implica gestionar dependencias, manejar errores, y garantizar que los datos fluyan de manera confiable desde las fuentes hasta los destinos. Un pipeline bien integrado se adapta a cambios en los datos o en las infraestructuras, manteniendo la consistencia y calidad. La clave está en diseñar DAGs que no solo ejecuten código, sino que también monitoreen y respondan al estado de las herramientas externas.
Cómo funciona en la práctica
Para integrar Airflow con una herramienta como Amazon Redshift, sigue estos pasos:
- Configura un conector (connection) en Airflow para Redshift, almacenando credenciales de forma segura en la interfaz web o mediante variables.
- Crea un operador personalizado o usa uno existente, como
PostgresOperatoradaptado para Redshift, dentro de un DAG. - Define tareas que ejecuten consultas SQL en Redshift, por ejemplo, para cargar datos desde S3 o transformar tablas.
- Establece dependencias entre tareas usando
>>para asegurar que los datos se procesen en el orden correcto. - Configura alertas y reintentos para manejar fallos de conexión o errores en las consultas.
Ejemplo de una tarea simple en un DAG:
from airflow.providers.postgres.operators.postgres import PostgresOperator

load_data = PostgresOperator(
    task_id='load_to_redshift',
    postgres_conn_id='redshift_conn',
    sql='COPY sales FROM ''s3://bucket/data.csv'' CREDENTIALS ''aws_iam_role=arn:aws:iam::123456789012:role/RedshiftRole'' CSV;',
    dag=dag
)
Caso de estudio
Una empresa de e-commerce necesita automatizar su pipeline de análisis de ventas diarias. Los datos provienen de múltiples fuentes: una base de datos MySQL con transacciones, un bucket S3 con logs de clics, y una API externa de clima. El objetivo es consolidar estos datos en un data warehouse de Google BigQuery para reportes.
Implementación con Airflow:
- DAG programado para ejecutarse cada día a las 2 AM.
- Tarea 1: Extraer datos de MySQL usando
MySqlOperatory guardarlos en un archivo Parquet en S3. - Tarea 2: Descargar logs de S3 y transformarlos con un script Python en un
PythonOperator. - Tarea 3: Llamar a la API de clima con
SimpleHttpOperatory parsear la respuesta JSON. - Tarea 4: Cargar todos los datos transformados a BigQuery usando
BigQueryOperator. - Tarea 5: Enviar un correo con
EmailOperatorsi el pipeline falla.
Este caso reduce el tiempo de procesamiento manual de 4 horas a 30 minutos automatizado, con monitoreo en tiempo real.
Errores comunes
- No gestionar conexiones de forma segura: Almacenar credenciales en código plano puede comprometer la seguridad. Usa los conectores de Airflow o herramientas como AWS Secrets Manager.
- Sobrecargar un solo DAG con demasiadas tareas: Esto dificulta el debugging y el mantenimiento. Divide pipelines complejos en DAGs más pequeños y modulares.
- Ignorar el manejo de errores: Sin reintentos o alertas, los fallos en herramientas externas pueden detener todo el pipeline. Configura
retriesyon_failure_callbacken los operadores. - No probar integraciones en un entorno de staging: Ejecutar DAGs directamente en producción puede causar pérdida de datos. Valida con datos de prueba primero.
- Olvidar limpiar recursos temporales: Archivos o conexiones no cerradas pueden llevar a fugas de memoria. Usa context managers o tareas de limpieza al final del DAG.
Checklist de dominio
- ¿Puedes configurar un conector en Airflow para una herramienta como Redshift o BigQuery?
- ¿Sabes diseñar un DAG que orqueste al menos tres herramientas diferentes (ej., base de datos, API, almacenamiento en la nube)?
- ¿Implementas manejo de errores con reintentos y notificaciones en tus pipelines?
- ¿Eres capaz de optimizar el rendimiento usando pools y concurrencia en Airflow?
- ¿Puedes integrar Airflow con un sistema de monitoreo como Prometheus o Datadog?
- ¿Sabes escribir operadores personalizados para herramientas no soportadas nativamente?
- ¿Documentas tus DAGs y flujos de trabajo para facilitar el mantenimiento en equipo?
Crear un DAG que integre MySQL, una API REST y S3
En este ejercicio, desarrollarás un DAG en Apache Airflow que automatice un pipeline ETL simple, integrando múltiples herramientas comunes en entornos de datos.
- Configura el entorno: Asegúrate de tener Airflow instalado y corriendo localmente o en un entorno de prueba. Crea conexiones en la interfaz web de Airflow para MySQL (usando un conector como
mysql_default) y para AWS S3 (usandoaws_default). Para la API, puedes simularla con un endpoint público como JSONPlaceholder. - Diseña el DAG: Crea un archivo Python para el DAG, definiendo un ID único y una programación diaria. El DAG debe incluir tres tareas principales:
- Tarea 1: Extraer datos de una tabla en MySQL (ej.,
SELECT * FROM orders WHERE date = '{{ ds }}') y guardar el resultado en un archivo CSV temporal. - Tarea 2: Llamar a una API REST (ej.,
https://jsonplaceholder.typicode.com/posts/1) para obtener datos adicionales, como información de usuario, y combinarlos con los datos de MySQL en un DataFrame de Pandas. - Tarea 3: Subir el archivo combinado a un bucket de S3 en formato Parquet, usando la biblioteca boto3 o un operador de Airflow.
- Tarea 1: Extraer datos de una tabla en MySQL (ej.,
- Implementa las tareas: Usa operadores apropiados:
- Para MySQL, emplea
MySqlOperatoroPythonOperatorcon una conexión. - Para la API, usa
SimpleHttpOperatoroPythonOperatorcon requests. - Para S3, utiliza
PythonOperatorcon boto3 oS3Hookde Airflow.
- Para MySQL, emplea
- Añade robustez: Configura al menos un reintento para cada tarea en caso de fallos de red o tiempo de espera. Agrega un manejador de errores que registre incidentes en un archivo de log.
- Prueba y valida: Ejecuta el DAG en Airflow y verifica que los datos se procesen correctamente. Revisa los logs para asegurarte de que no haya errores y que el archivo se suba a S3.
Pistas
- Usa variables de Airflow para almacenar URLs o nombres de buckets de manera dinámica y segura.
- Para la combinación de datos en la Tarea 2, considera usar Pandas para manipular DataFrames fácilmente.
- Si encuentras problemas de permisos con S3, verifica que la conexión de AWS tenga las políticas IAM adecuadas.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.