

Lección 16 de 20 · Lectura y práctica
Diseñar la Arquitectura del Pipeline de Datos en Tiempo Real
Concepto claveDiseñar la arquitectura de un pipeline de datos en tiempo real con Apache Airflow implica crear un sistema que procese datos continuamente con baja latencia, utilizando DAGs (Directed Acyclic Graphs) para orquestar.
Del concepto a la práctica
Taller de esta lección
En este contexto, tiempo real significa procesar ventanas con una latencia definida, no prometer que cada evento se transforma instantáneamente. Airflow puede coordinar lecturas periódicas y trabajos de procesamiento; una fuente de eventos conserva los mensajes y el destino debe soportar reintentos o deduplicación. La arquitectura se decide a partir de latencia, volumen, orden y recuperación.
Ejemplo resuelto
Supón ventanas de cinco minutos. La fuente entrega eventos con id, instante y valor; el DAG lee la ventana cerrada, valida tres eventos, suma 4+6+5=15 y guarda la clave 2026-10-08T10:00. Si se repite la ventana, la clave impide crear otro resumen.
Pruébalo
Define tamaño de ventana y retraso máximo aceptado.
Prepara eventos locales de una ventana conocida.
Procesa, registra conteo, suma y marcador de ventana.
Repite la misma ventana y compara el destino.
Comprueba tu resultado
Error frecuente: avanzar el marcador aunque la carga haya fallado, perdiendo eventos en el siguiente intento. Corrige avanzándolo solo después de una carga confirmada. El resultado esperado es una ventana con tres eventos y suma 15, seguida de una repetición que conserva una sola fila y no duplica el total.
Eventos de una ventana finita
[{"id":"E1","ts":"2026-10-08T10:00:00Z","valor":4},{"id":"E2","ts":"2026-10-08T10:02:00Z","valor":6},{"id":"E3","ts":"2026-10-08T10:04:59Z","valor":5}]Selecciona la ventana [10:00:00Z,10:05:00Z): tres eventos, suma=15. El evento E4 en 10:05:00Z se procesa en la siguiente. El resumen se identifica por inicio y fin, y se carga con upsert; repetir conserva un resumen. Para datos tardíos define cuánto tiempo permitirás reprocesar y actualiza ese resumen de modo consistente.
Airflow orquesta trabajos con principio y fin. Este ejercicio es procesamiento periódico por ventanas; un motor de streaming puede mantener un trabajo continuo y Airflow coordinar su ciclo de vida, sin lanzar una nueva copia infinita cada cinco minutos. El tamaño de ventana no garantiza la latencia final: incluye espera, cola y tiempo de procesamiento. Propósito de Airflow.
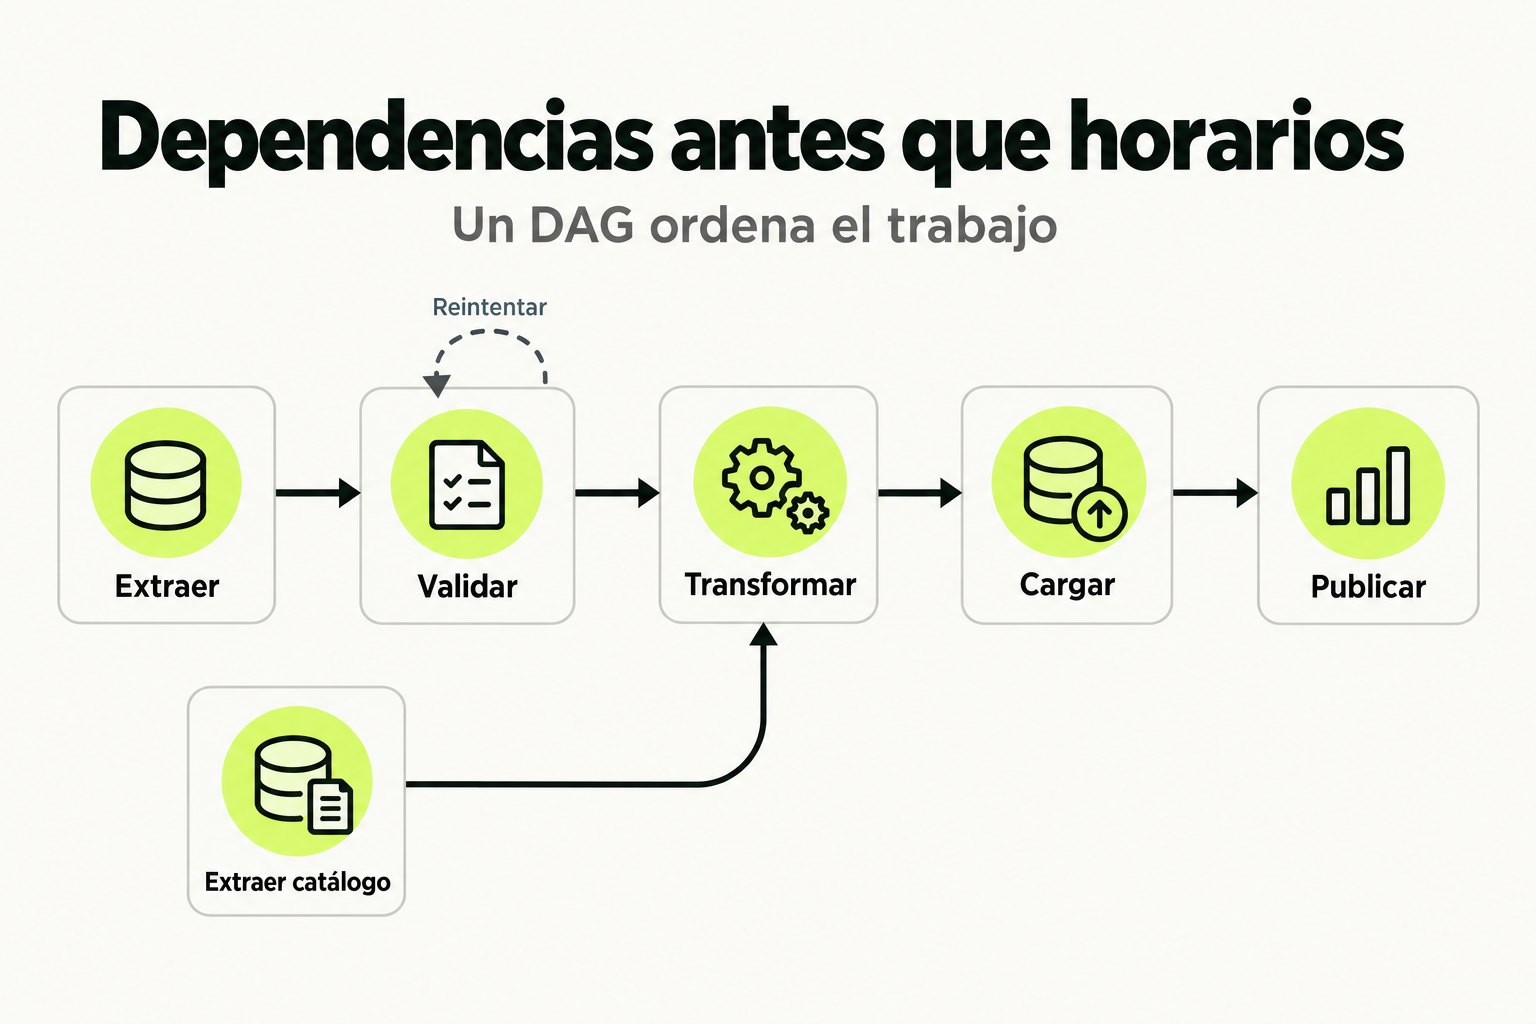
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Concepto clave
Diseñar la arquitectura de un pipeline de datos en tiempo real con Apache Airflow implica crear un sistema que procese datos continuamente con baja latencia, utilizando DAGs (Directed Acyclic Graphs) para orquestar tareas automatizadas. A diferencia de los pipelines por lotes que procesan datos en intervalos fijos, los pipelines en tiempo real manejan flujos de datos que llegan constantemente, como logs de aplicaciones, métricas de servidores o transacciones financieras.
La arquitectura típica combina Airflow como orquestador con tecnologías de streaming como Apache Kafka o AWS Kinesis. Airflow no procesa los datos directamente, sino que coordina cuando inician los trabajos de procesamiento, monitorea su ejecución y maneja fallos. Think of it as the air traffic controller for your data streams – no vuela los aviones, pero asegura que todos lleguen a su destino de manera ordenada y segura.
Cómo funciona en la práctica
Veamos un ejemplo paso a paso para un pipeline que procesa logs de una aplicación web en tiempo real:
- Ingesta de datos: Los logs se envían a un topic de Apache Kafka usando un productor.
- Procesamiento inicial: Un DAG de Airflow programa un job de Spark Streaming que lee del topic de Kafka, limpia los datos y los escribe en un topic procesado.
- Transformación: Otro DAG ejecuta una tarea que consume los datos procesados, aplica reglas de negocio y los carga en una base de datos analítica como PostgreSQL.
- Monitoreo: Un tercer DAG ejecuta checks de calidad de datos cada hora y envía alertas si hay anomalías.
Airflow coordina estos pasos asegurando que cada tarea se ejecute en el orden correcto y con las dependencias adecuadas. Por ejemplo, la transformación no puede comenzar hasta que el procesamiento inicial haya terminado exitosamente.
Caso de estudio
Una empresa de e-commerce necesita monitorear en tiempo real las búsquedas de productos en su sitio web para ajustar recomendaciones. Implementamos esta arquitectura:
| Componente | Tecnología | Función |
|---|---|---|
| Ingesta | Apache Kafka | Recibe eventos de búsqueda desde el frontend |
| Procesamiento | Spark Streaming | Calcula tendencias cada 5 minutos |
| Almacenamiento | Redis | Guarda resultados para acceso rápido |
| Orquestación | Apache Airflow | Coordina el pipeline completo |
El DAG principal tiene estas tareas:
start >> validate_kafka_topic >> trigger_spark_job >> load_to_redis >> send_metricsEl DAG se ejecuta cada 5 minutos, procesando los eventos acumulados en ese intervalo.
Nota clave: En tiempo real no significa procesamiento instantáneo, sino con latencia controlada (segundos o minutos).
Errores comunes
- No planificar para el fallo: Asumir que los streams de datos siempre estarán disponibles. Solución: Implementar mecanismos de reintento y dead-letter queues en Kafka.
- Acoplamiento excesivo: Hacer que el DAG dependa demasiado de una tecnología específica. Solución: Usar operadores genéricos y abstraer la lógica de negocio.
- Ignorar el backpressure: Cuando el sistema de destino no puede mantener el ritmo de los datos entrantes. Solución: Monitorear métricas de lag en Kafka y ajustar la velocidad de procesamiento.
- Falta de idempotencia: Reprocesar los mismos datos puede duplicar resultados. Solución: Diseñar transformaciones idempotentes o usar marcas de tiempo exactas.
- Subestimar los costos: Los pipelines en tiempo real pueden ser costosos en infraestructura. Solución: Comenzar con ventanas de procesamiento más largas y optimizar gradualmente.
Checklist de dominio
- He identificado las fuentes de datos y su frecuencia de llegada
- He seleccionado tecnologías de streaming apropiadas para mi caso de uso
- He diseñado DAGs con tareas idempotentes y tolerantes a fallos
- He definido estrategias para manejar datos tardíos o desordenados
- He planificado el monitoreo y alertas para el pipeline
- He considerado requisitos de escalabilidad horizontal
- He documentado las dependencias entre componentes
Diseña la arquitectura para un pipeline de métricas de servidores
Tu empresa necesita monitorear métricas de CPU y memoria de 100 servidores en tiempo real. Diseña la arquitectura completa:
- Define cómo llegarán los datos desde los servidores (formato, frecuencia, protocolo)
- Selecciona tecnologías para ingesta, procesamiento y almacenamiento
- Diseña un DAG de Airflow con al menos 4 tareas que orqueste el proceso
- Especifica cómo manejarías picos de carga (ej: todos los servidores reportan al mismo tiempo)
- Describe un mecanismo para alertar cuando una métrica supere umbrales críticos
Escribe tu diseño en un documento estructurado con diagramas textuales usando ASCII art o descripciones claras.
Pistas
- Considera usar un agente ligero en cada servidor que envíe datos a un sistema centralizado
- Para el almacenamiento, piensa en qué tipo de consultas necesitarás hacer sobre las métricas
- Incluye en tu DAG una tarea de limpieza de datos antiguos para evitar crecimiento infinito
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.