

Lección 14 de 20 · Lectura y práctica
Ejercicio: Automatizar un Pipeline ETL de Datos de Ventas
Concepto claveEn el mundo de la ingeniería de datos, Apache Airflow actúa como el director de orquesta que coordina múltiples músicos (tareas ETL) para crear una sinfonía armoniosa (pipeline de datos). Imagina una cadena de.
Del concepto a la práctica
Taller de esta lección
Un ETL de ventas se vuelve comprobable cuando cada fase tiene una salida medible. Usa un lote pequeño con una clave de venta, fecha, unidades y precio. La extracción conserva las filas; la transformación calcula importes y separa entradas inválidas; la carga escribe un resumen con una clave de ventana. Esa separación permite localizar una suma incorrecta sin rehacer todo el flujo.
Ejemplo resuelto
Entradas: v1,2026-10-01,2,5, v2,2026-10-01,1,8 y v3,2026-10-01,3,-1. Las dos primeras son válidas y suman 10+8=18; la tercera se rechaza por precio negativo. La carga guarda fecha=2026-10-01, ventas_validas=2, total=18.
Pruébalo
Extrae el archivo sin modificarlo.
Valida fecha, unidades y precio.
Calcula importes solo para filas válidas.
Carga resumen y registro de rechazos.
Ejecuta una segunda vez con la misma ventana.
Comprueba tu resultado
Error frecuente: incluir la fila negativa con importe -3 y ocultar el rechazo. Corrige aplicando la regla antes del cálculo. El resultado esperado es total 18, dos válidas, una rechazada y ningún duplicado tras repetir la ventana.
Archivo íntegro y repetición de ventana
venta_id,fecha,unidades,precio
v1,2026-10-01,2,5
v2,2026-10-01,1,8
v3,2026-10-01,3,-1
La ventana es [2026-10-01T00:00:00Z,2026-10-02T00:00:00Z). Exige cantidad positiva, precio no negativo y fecha válida dentro de esa ventana. El contrato rechaza v3 por precio negativo, conservando dos ventas y total=18. La tabla de resumen usa la fecha de negocio como clave y un upsert; repetir la ventana actualiza una fila, sin sumar otra vez 18. Guarda el rechazo aparte con ID y motivo.
Los datos de prueba son fijos, sin generación aleatoria. Para código nuevo cambia los nombres históricos a los imports del SDK/providers y usa HttpOperator si incorporas HTTP. Una mejora de duración o confiabilidad requiere medición real; las cifras de los casos ilustrativos antiguos no constituyen una garantía de rendimiento.
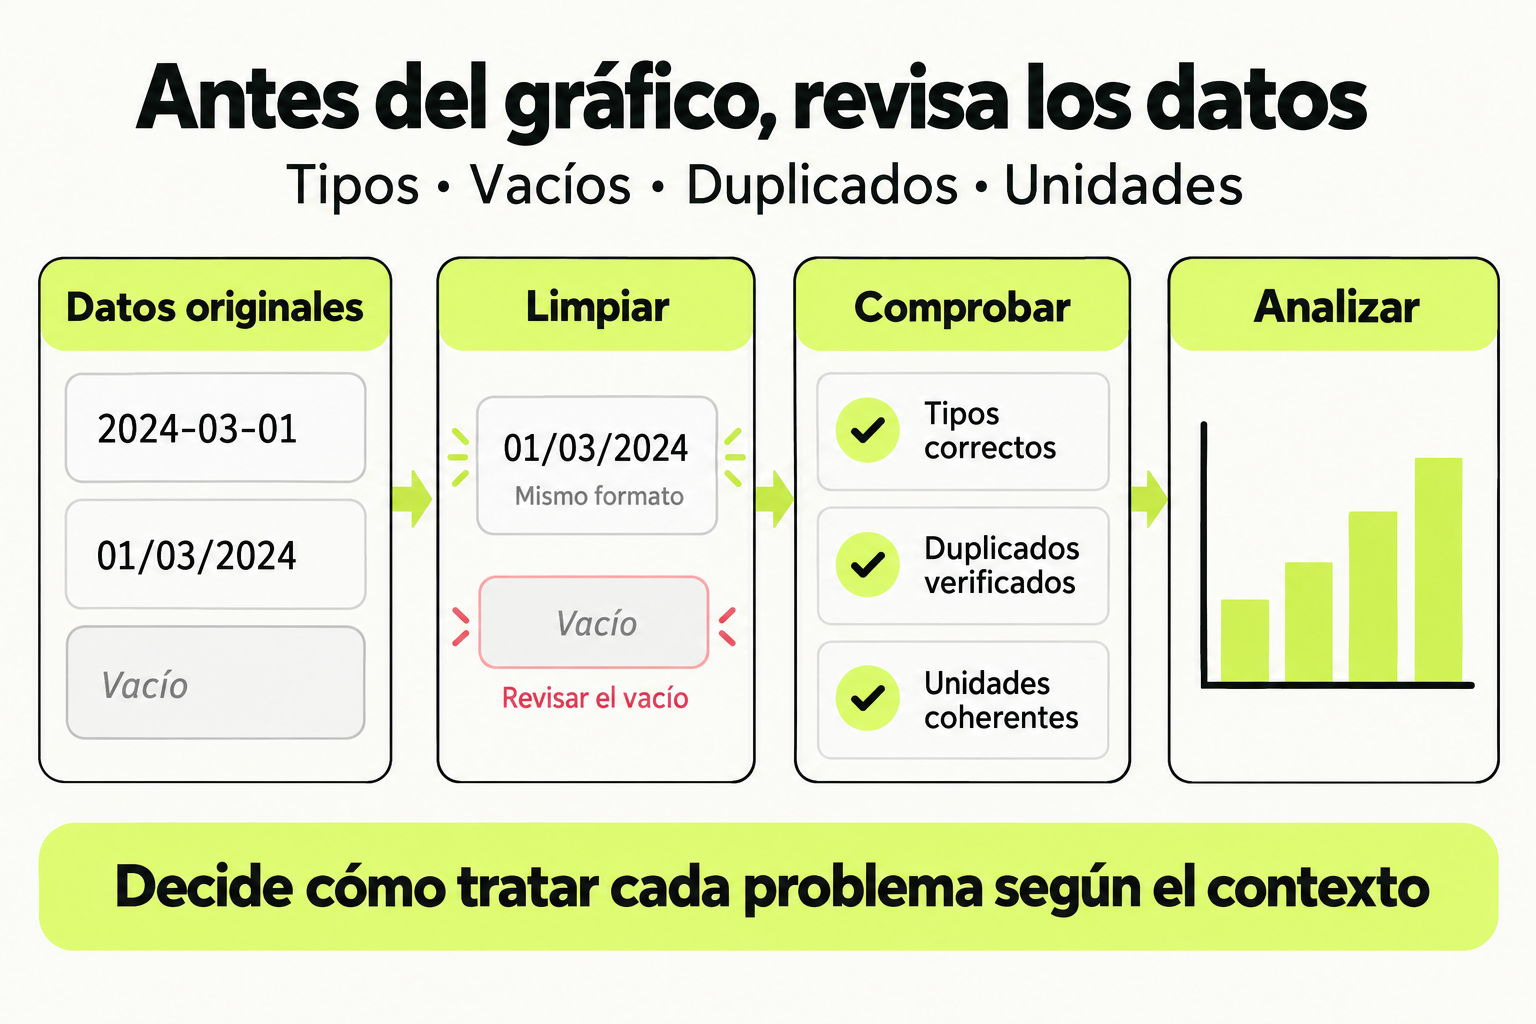
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Concepto clave
En el mundo de la ingeniería de datos, Apache Airflow actúa como el director de orquesta que coordina múltiples músicos (tareas ETL) para crear una sinfonía armoniosa (pipeline de datos). Imagina una cadena de montaje en una fábrica: cada estación realiza una operación específica (extraer, transformar, cargar), y Airflow es el sistema de control que asegura que cada pieza llegue a tiempo y en el orden correcto.
Un DAG (Directed Acyclic Graph) es el plano maestro que define las dependencias entre tareas. Como un mapa de metro, muestra cómo llegar de un punto a otro sin bucles infinitos. En pipelines de ventas, esto significa que primero extraes datos de fuentes como CRM o bases de datos, luego los limpias y agrupas, y finalmente los cargas en un data warehouse para análisis.
Cómo funciona en la práctica
Vamos a construir un pipeline ETL para datos de ventas diarias. Supongamos que tienes datos en una base de datos PostgreSQL y quieres generar un reporte consolidado en BigQuery.
- Extracción: Usa un operador de Airflow como
PostgresOperatorpara ejecutar una consulta SQL que obtenga ventas del día. - Transformación: Implementa una función Python con
PythonOperatorque limpie datos (ej: corregir formatos de fecha) y calcule métricas como ventas totales por región. - Carga: Emplea
BigQueryOperatorpara insertar los datos transformados en una tabla de BigQuery.
El DAG define que la transformación depende de la extracción, y la carga depende de la transformación. Airflow programa la ejecución diaria y maneja reintentos automáticos si falla una tarea.
Caso de estudio
Una empresa retail necesita automatizar su reporte de ventas diarias. Los datos vienen de tres fuentes: ventas online (API REST), ventas en tienda (archivo CSV en S3), y datos de clientes (MySQL).
El pipeline implementado en Airflow incluye:
- Tarea 1: Extraer datos de la API usando
SimpleHttpOperatory guardarlos en un archivo temporal. - Tarea 2: Descargar el CSV de S3 con
S3KeySensoryS3ToLocalOperator. - Tarea 3: Consultar MySQL con
MySqlOperator. - Tarea 4: Unir y transformar todos los datos con un script Python (
PythonOperator). - Tarea 5: Cargar el resultado a Redshift (
RedshiftOperator).
El DAG se ejecuta cada día a las 2 AM, y un dashboard de Metabase consume los datos para mostrar KPIs a los gerentes.
En este caso, el pipeline redujo el tiempo de generación de reportes de 4 horas manuales a 15 minutos automatizados, con una confiabilidad del 99.9%.
Errores comunes
- No manejar fallos de conexión: Si una fuente de datos está caída, el pipeline falla. Solución: Usar sensores (
Sensor) para esperar disponibilidad o implementar lógica de reintento conretriesen los operadores. - Dependencias circulares: Crear un DAG donde la tarea A depende de B y B depende de A, causando un bucle infinito. Solución: Diseñar el grafo asegurando que sea acíclico, revisando visualmente con la interfaz de Airflow.
- No limpiar recursos temporales: Archivos o conexiones que se acumulan tras cada ejecución. Solución: Usar
PythonOperatorcon funciones que borren archivos temporales al final, o configurarcleanupen los operadores. - Ignorar el timezone: Programar ejecuciones en UTC sin considerar husos horarios locales, lo que afecta reportes diarios. Solución: Configurar
start_dateyschedule_intervalcon timezone explícita usandopendulum.
Checklist de dominio
- Puedo diseñar un DAG con al menos 5 tareas y dependencias claras.
- Sé configurar operadores para fuentes comunes (PostgreSQL, S3, APIs).
- Implemento manejo de errores con reintentos y alertas (ej: email on failure).
- Uso variables de Airflow (
Variable) para parámetros configurables como rutas de archivos. - Pruebo el pipeline localmente con el scheduler de Airflow antes de desplegar a producción.
- Documento cada tarea con
doc_mdpara mantener claridad en el equipo. - Mido el performance del pipeline (tiempo de ejecución, uso de recursos) y optimizo si es necesario.
Automatizar un Pipeline ETL de Datos de Ventas con Airflow
Objetivo
Crear un DAG en Airflow que automatice un pipeline ETL para datos de ventas diarias, extrayendo de una fuente simulada, transformando los datos, y cargándolos a un destino.
Pasos
- Configuración inicial: Instala Apache Airflow localmente o usa un entorno como Astronomer. Crea un nuevo archivo Python en la carpeta
dags/llamadosales_etl_pipeline.py. - Diseña el DAG: Define un DAG con ID
sales_etl_daily, programado para ejecutarse diariamente a las 6 AM. Usadefault_argspara configurar reintentos (3) y dueños. - Implementa tareas:
- Tarea 1 (
extract_sales_data): UsaPythonOperatorpara simular extracción. Crea una función que genere datos de ventas aleatorios (ej: lista de diccionarios con campos: fecha, producto, cantidad, precio) y los guarde en un archivo JSON temporal. - Tarea 2 (
transform_sales_data): UsaPythonOperatorpara transformar. Lee el archivo JSON, calcula el total de ventas por producto, y guarda el resultado en un nuevo archivo CSV. - Tarea 3 (
load_sales_data): UsaPythonOperatorpara simular carga. Lee el CSV y muestra un resumen por consola (o, si tienes configurado, carga a una base de datos real como SQLite).
- Tarea 1 (
- Define dependencias: Establece que
transform_sales_datadepende deextract_sales_data, yload_sales_datadepende detransform_sales_data. - Prueba y ejecuta: Activa el DAG en la interfaz de Airflow, verifica que las tareas se ejecuten en orden y revisa los logs para confirmar que los datos se procesen correctamente.
Entrega
Sube el archivo sales_etl_pipeline.py a un repositorio Git o comparte capturas de pantalla de la ejecución exitosa en la interfaz de Airflow.
Pistas
- Usa la libreria random en Python para generar datos de ventas simulados en la extraccion.
- Para las dependencias, en Airflow se usa el operador >>, por ejemplo: tarea1 >> tarea2 >> tarea3.
- Asegurate de manejar rutas de archivos absolutas en las funciones para evitar errores en diferentes entornos.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.