

Lección 17 de 20 · Lectura y práctica
Implementar el DAG con Extracción, Transformación y Carga Continua
Tipo de lección: VideoConcepto claveEn esta lección, implementaremos un DAG (Directed Acyclic Graph) en Apache Airflow que orquesta un pipeline de datos en tiempo real con extracción, transformación y carga continua. A diferencia.
Del concepto a la práctica
Taller de esta lección
Explicación específica
Un flujo casi continuo debe recordar hasta qué evento procesó y evitar duplicados si una ejecución se repite. Una ventana temporal sirve para seleccionar candidatos, pero un identificador único protege frente a eventos con la misma hora.
Ejemplo resuelto
eventos = [
    {"id": "V101", "ts": "2026-10-08T10:00:00Z", "importe": 12.50},
    {"id": "V102", "ts": "2026-10-08T10:02:00Z", "importe": 8.00},
    {"id": "V103", "ts": "2026-10-08T10:03:00Z", "importe": 5.50},
]
inicio = "2026-10-08T10:00:00Z"
fin = "2026-10-08T10:05:00Z"
procesados = {"V101"}
nuevos = [e for e in eventos if inicio <= e["ts"] < fin and e["id"] not in procesados]
assert sum(e["importe"] for e in nuevos) == 13.50
Pruébalo
Separa extracción, transformación y carga como tareas dependientes.
Guarda la marca solo después de cargar correctamente.
Usa el identificador del evento como clave de deduplicación.
Repite la ejecución y compara el número de filas cargadas.
Comprueba tu resultado
Error frecuente: actualizar la marca antes de la carga; una caída puede perder eventos. Corrige el orden y confirma la marca al final.
Ejercicio: añade V104, con hora 10:04 e importe 4.50, y repite el cálculo. Resultado esperado: tres eventos nuevos respecto a V101, con total 18.00.
Eventos con la misma hora y confirmación de estado
El ejemplo usa un formato UTC idéntico en todos los timestamps, por lo que su comparación textual es válida para esa fixture; en una fuente real normaliza timestamps a fechas conscientes de zona horaria. El límite inicial es inclusivo y el final exclusivo. Antes de V104 hay dos eventos pendientes (V102 y V103), total=13.50; después hay tres (V102, V103 y V104), total=18.00.
Añade otra prueba con V105 a 10:00:00Z, importe=2: si su ID no se ha procesado, entra también y el total es 20. Un filtro estricto ts > última_hora lo perdería. Un timestamp no garantiza completitud de llegada: usa un cursor fiable de la fuente o ventanas con margen para retrasados más deduplicación persistente. Confirma carga y cursor transaccionalmente cuando sea posible; si están en sistemas separados, diseña recuperación idempotente para un fallo entre ambos. No mantengas la lista de IDs solo en una variable global de un worker.
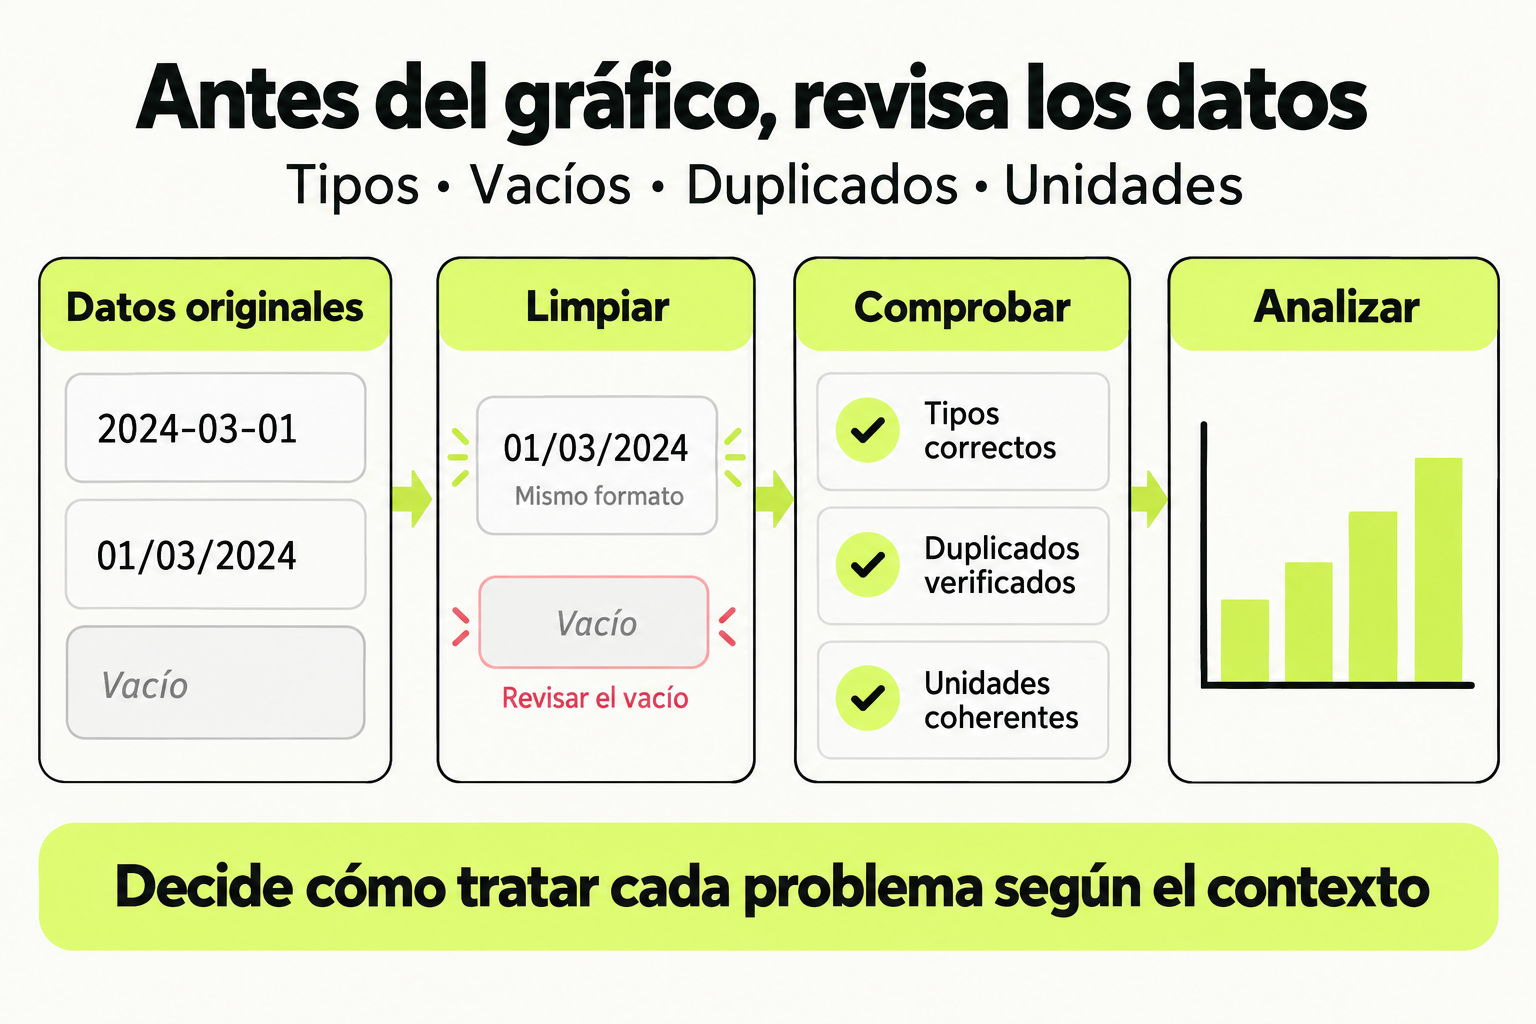
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
En esta lección, implementaremos un DAG (Directed Acyclic Graph) en Apache Airflow que orquesta un pipeline de datos en tiempo real con extracción, transformación y carga continua. A diferencia de los pipelines batch tradicionales que se ejecutan en intervalos fijos, este enfoque maneja flujos de datos que llegan constantemente, como logs de aplicaciones, métricas de servidores o transacciones financieras.
La clave está en diseñar tareas que sean idempotentes (pueden ejecutarse múltiples veces sin efectos secundarios) y utilizar sensores o triggers basados en eventos para iniciar el procesamiento cuando hay datos nuevos. Imagina esto como una línea de ensamblaje en una fábrica que nunca se detiene: los datos son las piezas que llegan continuamente, y cada estación (tarea del DAG) realiza una operación específica antes de pasar al siguiente paso.
Cómo funciona en la práctica
Vamos a construir un DAG paso a paso para procesar datos de ventas en tiempo real desde una API REST. El pipeline incluye:
- Extracción: Una tarea que consulta una API cada 5 minutos para obtener nuevas ventas.
- Transformación: Limpieza de datos, cálculo de totales y agregación por categoría.
- Carga: Inserción de los resultados en una base de datos analítica como PostgreSQL.
Usaremos operadores de Airflow como PythonOperator para lógica personalizada y PostgresOperator para la carga. Aquí un fragmento de código clave para la extracción:
def extract_sales_data(**context):
    import requests
    response = requests.get('https://api.ejemplo.com/ventas')
    data = response.json()
    context['ti'].xcom_push(key='sales_data', value=data)
    return data
Este código se ejecuta como parte de una tarea en el DAG, empujando los datos a XCom para que otras tareas los usen.
Caso de estudio
Considera una empresa de e-commerce que necesita analizar ventas en tiempo real para ajustar inventarios. Implementamos un DAG con las siguientes tareas:
| Tarea | Operador | Frecuencia |
|---|---|---|
| extraer_ventas | PythonOperator | Cada 5 min |
| transformar_datos | PythonOperator | Depende de extraer_ventas |
| cargar_a_postgres | PostgresOperator | Depende de transformar_datos |
Los datos de entrada son JSON con campos como product_id, quantity, y price. En la transformación, calculamos el total por venta y agrupamos por categoría de producto. La salida se carga en una tabla ventas_agregadas para dashboards en tiempo real.
En un despliegue real, este DAG procesa hasta 10,000 ventas por hora, con latencia menor a 1 minuto desde la venta hasta el reporte.
Errores comunes
- No manejar fallos en la extracción: Si la API falla, el pipeline se detiene. Solución: Usar retries y timeouts en las tareas, o implementar un sensor que espere hasta que la API esté disponible.
- Procesamiento no idempotente Ejecutar la misma tarea múltiples veces puede duplicar datos. Solución: Diseñar transformaciones que usen timestamps o IDs únicos para evitar duplicados.
- Falta de monitoreo de recursos Pipelines en tiempo real pueden consumir mucha memoria o CPU. Solución: Configurar límites en los operadores y usar métricas de Airflow para alertas.
- Ignorar la calidad de datos Datos corruptos pueden propagarse. Solución: Incluir validaciones en la transformación, como checks de tipos de datos o rangos.
Checklist de dominio
- ¿Puedes diseñar un DAG con tareas para extracción, transformación y carga continua?
- ¿Sabes usar XCom para pasar datos entre tareas en Airflow?
- ¿Implementas idempotencia en tus pipelines para evitar duplicados?
- ¿Configuras retries y alertas para manejar fallos en tiempo real?
- ¿Validas la calidad de datos durante la transformación?
- ¿Optimizas el rendimiento ajustando la concurrencia y recursos?
- ¿Documentas el DAG con descripciones claras y tags?
Implementa un DAG para procesar logs de servidor en tiempo real
En este ejercicio, crearás un DAG en Airflow que procese logs de servidor en tiempo real. Sigue estos pasos:
- Configura un entorno local de Airflow o usa un sandbox en la nube.
- Crea un archivo Python para el DAG llamado
logs_realtime_dag.py. - Define una tarea de extracción que simule leer logs desde un archivo
/tmp/server.logcada 2 minutos. Usa unPythonOperatorcon una función que lea las líneas nuevas. - Añade una tarea de transformación que cuente el número de errores (líneas que contengan 'ERROR') en los logs. Pasa el resultado usando XCom.
- Implementa una tarea de carga que inserte el conteo de errores en una tabla SQLite o PostgreSQL, usando un
PostgresOperatoroSQLiteOperator. - Configura las dependencias entre tareas para que se ejecuten en secuencia.
- Prueba el DAG ejecutándolo manualmente y verifica los resultados en la base de datos.
Pistas
- Usa
open()con modo 'r' para leer el archivo de logs, y considera almacenar la última posición leída para evitar reprocesar. - Para la transformación, puedes usar una expresión regular o
str.count()para identificar errores. - Si usas SQLite, asegúrate de que la base de datos esté accesible desde Airflow y crea la tabla de antemano.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Apache Airflow para ETL: Integraciones y Pipelines en Tiempo Real
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.