

Lección 7 de 24 · Lectura y práctica
Práctica: Reducción de Latencia en Microservicio
Tipo de lección: VideoConcepto claveLa reducción de latencia en microservicios con Rust se centra en minimizar el tiempo entre la solicitud y la respuesta, crucial para sistemas financieros, juegos en tiempo real o.
Del concepto a la práctica
Taller de esta lección
En un servicio simulado conviene medir la ruta interna antes de hablar de red. Divide el tiempo en validación, cálculo y serialización; así sabrás qué cambio afecta realmente a la respuesta. Un payload pequeño y fijo permite comprobar el resultado sin depender de un framework o una versión concreta.
Ejemplo resuelto
use std::time::Instant;
fn procesar(valor: i64) -> Result<i64, &'static str> {
    if valor < 0 { return Err("valor negativo"); }
    valor.checked_mul(2).ok_or("desbordamiento")
}
fn main() {
    let t = Instant::now();
    let r = procesar(21);
    println!("{:?} {}", r, t.elapsed().as_nanos());
}
La salida funcional contiene Ok(42); el tiempo se observa localmente.
Pruébalo
Mide validación y cálculo por separado.
Usa los mismos valores en cada ejecución.
Registra unidad y número de muestras.
Compara antes y después de eliminar una copia innecesaria.
Comprueba tu resultado
Error frecuente: declarar que el endpoint mejoró midiendo solo una ejecución. Corrección: usa una muestra y conserva la respuesta.
Ejercicio: procesa 21, 0 y -1; los resultados esperados son Ok(42), Ok(0) y Err("valor negativo").
La función solo valida y calcula; el snippet no serializa ni usa red, así que su tiempo no representa un endpoint. Con i64::MAX devuelve desbordamiento por checked_mul. Conserva los tres casos21,0,-1 y registra varias muestras antes de comparar. Una respuesta de error no debe reaprovechar un resultado parcial.
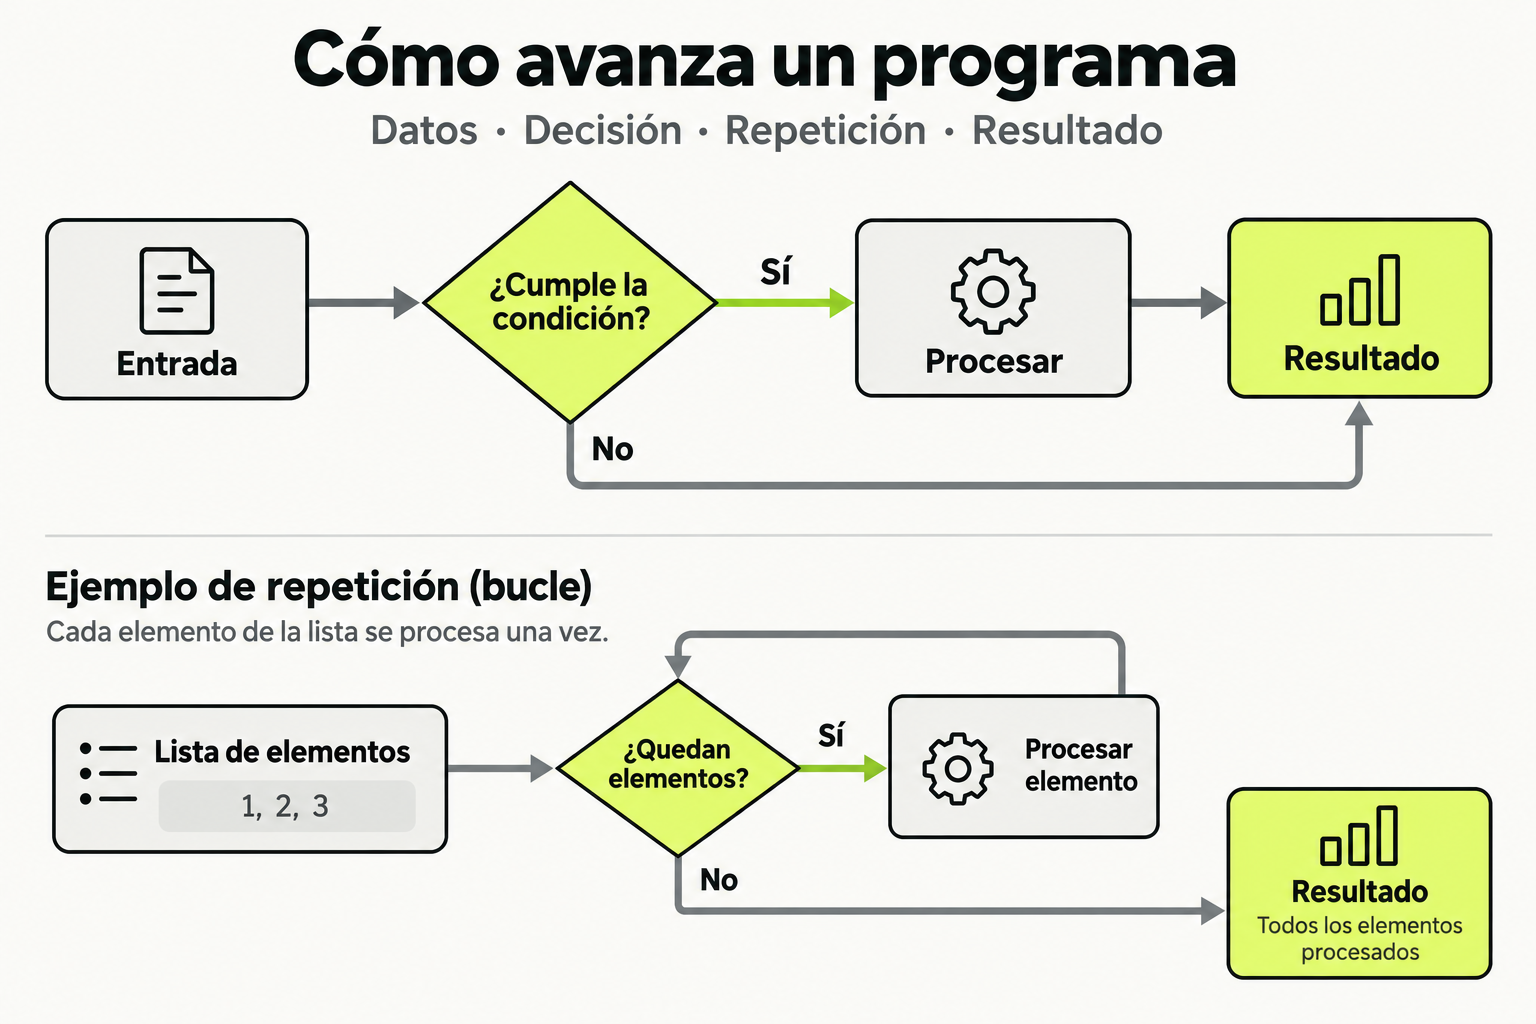
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
La reducción de latencia en microservicios con Rust se centra en minimizar el tiempo entre la solicitud y la respuesta, crucial para sistemas financieros, juegos en tiempo real o telecomunicaciones. Piensa en un sistema de transacciones bancarias: cada milisegundo cuenta para evitar pérdidas o retrasos críticos. Rust, con su control de memoria sin recolector de basura y su capacidad para optimización a bajo nivel, permite eliminar pausas no deterministas y reducir overhead.
La latencia total se compone de varios factores: procesamiento de CPU, acceso a memoria, llamadas de red y espera de E/S. En Rust, puedes atacar cada uno mediante técnicas como zero-copy deserialization (evitar copias de datos), async/await con ejecutores ligeros (como tokio) para concurrencia eficiente, y perfilado con herramientas como flamegraph para identificar cuellos de botella. Una analogía: optimizar un microservicio es como afinar un motor de carreras; cada componente debe ajustarse para máxima eficiencia sin sacrificar seguridad.
Cómo funciona en la práctica
Vamos a implementar un endpoint de microservicio que procesa datos JSON con baja latencia. Usaremos Actix-web como framework y serde para serialización.
use actix_web::{web, App, HttpResponse, HttpServer, Responder};
use serde::{Deserialize, Serialize};
use std::time::Instant;

#[derive(Deserialize, Serialize)]
struct Transaction {
    id: u64,
    amount: f64,
    timestamp: i64,
}

async fn process_transaction(data: web::Json) -> impl Responder {
    let start = Instant::now();
    // Simular procesamiento: validar y transformar
    let processed = Transaction {
        id: data.id,
        amount: data.amount * 1.01, // Aplicar tasa
        timestamp: data.timestamp,
    };
    let latency = start.elapsed().as_micros();
    println!("Latencia: {} microsegundos", latency);
    HttpResponse::Ok().json(processed)
}

#[actix_web::main]
async fn main() -> std::io::Result<()> {
    HttpServer::new(|| {
        App::new()
            .route("/transaction", web::post().to(process_transaction))
    })
    .bind("127.0.0.1:8080")?
    .run()
    .await
}
Pasos para reducir latencia en este código:
- Usar perfilado con
cargo flamegraphpara medir tiempos de ejecución. - Implementar zero-copy en deserialización: en serde, usar referencias (
&'a str) en estructuras para evitar copias de strings. - Configurar el ejecutor async con tokio::runtime::Builder para ajustar hilos y prioridades.
- Optimizar allocaciones: reutilizar buffers con
Vec::with_capacityo tipos comoBytes.
Caso de estudio
En un sistema de trading de alta frecuencia, un microservicio en Rust procesa órdenes de compra/venta. Los requisitos: latencia < 100 microsegundos, 99.99% uptime. Implementación real:
| Componente | Técnica de Optimización | Resultado |
|---|---|---|
| Deserialización JSON | Usar simd-json con zero-copy | Reducción de 50% en tiempo de parsing |
| Red | Configurar TCP_NODELAY y usar QUIC | Latencia de red reducida en 30% |
| Memoria | Pool de conexiones con bb8 y arena allocators | Menos fragmentación y allocaciones |
Dato clave: En pruebas, Rust logró latencias de 15 microsegundos para procesamiento crítico, vs 100+ en lenguajes con GC.
Lecciones aprendidas: el perfilado continuo es esencial; herramientas como perf en Linux ayudan a identificar cuellos de botella a nivel de CPU. Además, diseñar APIs con mensajes binarios (ej., Protocol Buffers) en lugar de JSON puede reducir latencia en un 70%.
Errores comunes
- Usar clones innecesarios: En Rust, clonar datos grandes (como
VecoString) añade overhead. Solución: usar referencias (&) o tipos comoArcpara compartir ownership. - Ignorar el costo de allocaciones: Cada
Vec::new()oString::frompuede causar latencia. Evitar con pre-asignación de capacidad o reutilización de buffers. - Mal configuración del runtime async: Tokio por defecto puede no ser óptimo; ajustar el número de hilos de trabajo (
tokio::runtime::Builder::new_multi_thread()) según cores de CPU. - No medir en producción: Asumir que optimizaciones funcionan sin métricas. Usar herramientas como Prometheus para monitorear latencia en tiempo real.
- Sobrecargar el microservicio con lógica compleja: Mantener endpoints simples y delegar tareas pesadas a workers separados.
Checklist de dominio
- ¿Has perfilado tu microservicio con
flamegraphoperfpara identificar hotspots? - ¿Usas zero-copy deserialization (ej., con serde y referencias) en estructuras de datos?
- ¿Has configurado el runtime async (tokio) con parámetros optimizados para tu hardware?
- ¿Minimizas allocaciones de memoria reutilizando buffers o usando pools?
- ¿Implementas monitoreo de latencia con métricas (ej., percentiles p95, p99) en producción?
- ¿Diseñas APIs con formatos binarios (Protobuf, Cap'n Proto) para reducir overhead de serialización?
- ¿Probaste tu microservicio bajo carga con herramientas como
wrkolocust?
Optimizar un microservicio de procesamiento de logs para baja latencia
Implementa un microservicio en Rust que recibe logs en formato JSON y los procesa con latencia < 500 microsegundos. Sigue estos pasos:
- Crea un proyecto Rust con
cargo new log_processor --biny añade dependencias: actix-web, serde, tokio, y simd-json. - Define una estructura
LogEntrycon campos: id (u64), message (String), timestamp (i64). Usa zero-copy deserialization con referencias donde sea posible. - Implementa un endpoint POST
/logque recibaLogEntry, valide que el message no esté vacío, y devuelva el log procesado (ej., añadir un campo 'processed_at'). - Configura el runtime de tokio para usar 2 hilos (ajustado a sistemas pequeños) y habilita TCP_NODELAY en el servidor.
- Perfila la aplicación con
cargo flamegraphy mide la latencia usandoInstant::now()en el endpoint. Optimiza basado en los resultados, por ejemplo, reduciendo clones o usando simd-json. - Prueba con una herramienta como
wrkpara enviar 1000 solicitudes y verifica que la latencia promedio esté bajo 500 microsegundos.
Pistas
- Usa
#[derive(Deserialize)]conserdey campos como&'a strpara zero-copy en strings. - En tokio, configura el runtime con
tokio::runtime::Builder::new_multi_thread().worker_threads(2).enable_all().build(). - Para medir latencia, incluye
let start = std::time::Instant::now();al inicio del handler y calcula la diferencia al final.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Trading: Concurrencia, Seguridad y Baja Latencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.