

Lección 8 de 24 · Lectura y práctica
Manejo de Memoria para Máximo Rendimiento
Concepto claveEn sistemas de baja latencia, el manejo de memoria no es solo sobre evitar fugas, sino sobre predictibilidad temporal. Rust ofrece control preciso mediante ownership, borrowing y lifetimes, pero para máximo.
Del concepto a la práctica
Taller de esta lección
Una capacidad fija puede hacer predecible un camino que conoce su límite, pero también puede rechazar entradas legítimas. El diseño correcto expresa ambos hechos: capacidad disponible y error de saturación. Un buffer de eventos no debe sobrescribir silenciosamente el registro anterior para aparentar rendimiento.
Ejemplo resuelto
struct Buffer { datos: [u64; 3], usados: usize }
impl Buffer {
    fn push(&mut self, x: u64) -> Result<(), &'static str> {
        if self.usados == self.datos.len() { return Err("lleno"); }
        self.datos[self.usados] = x; self.usados += 1; Ok(())
    }
}
fn main() {
    let mut b = Buffer { datos: [0; 3], usados: 0 };
    println!("{:?} {:?}", b.push(7), b.push(8));
}
La salida funcional es Ok(()) Ok(()).
Pruébalo
Inserta tres valores.
Intenta un cuarto.
Conserva el error.
Comprueba
usadosdespués de cada operación.
Comprueba tu resultado
Error frecuente: usar unsafe para saltarse la comprobación de capacidad. Corrección: valida el índice y documenta el límite.
Ejercicio: insertar 7,8,9,10 debe producir tres éxitos, luego Err("lleno"), y usados debe permanecer en 3.
Si el tipo se expone como módulo de biblioteca, conserva usados privado y comprueba usados>=len como defensa del límite. El array no es un ring: no ofrece extracción ni reutilización de posiciones. Para liberar capacidad define clear o pop con su contrato, en vez de modificar usados desde fuera. Fija tres inserciones y la cuarta fallida sin alterar los tres datos originales.
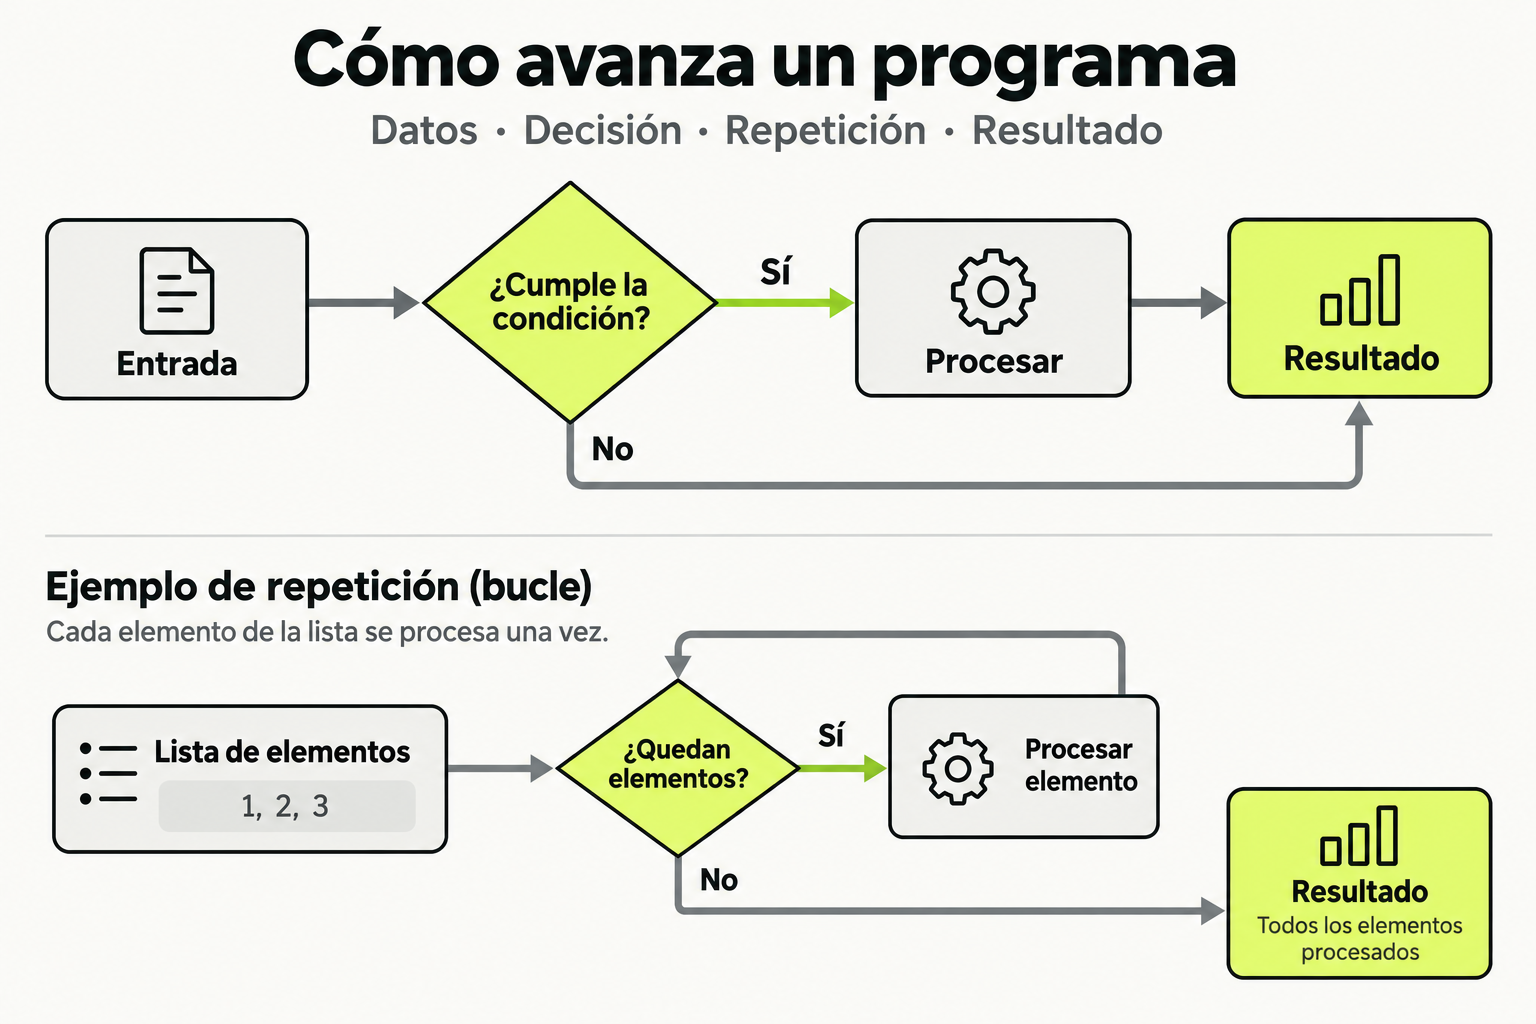
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
En sistemas de baja latencia, el manejo de memoria no es solo sobre evitar fugas, sino sobre predictibilidad temporal. Rust ofrece control preciso mediante ownership, borrowing y lifetimes, pero para máximo rendimiento necesitas entender como estas abstracciones se traducen a operaciones de memoria concretas.
La memoria en sistemas críticos opera bajo dos principios: localidad espacial (datos usados juntos deben estar juntos) y localidad temporal (datos usados pronto deben permanecer accesibles). En Rust, esto significa estructurar tus datos para minimizar cache misses y evitar allocations dinámicas en hot paths.
"En sistemas de baja latencia, cada nanosegundo cuenta. Una allocation imprevista puede introducir variabilidad de microsegundos que arruina tus SLAs." - Ingeniero de sistemas financieros
Cómo funciona en la práctica
Considera un sistema de procesamiento de ordenes bursátiles donde cada microsegundo importa. Vamos a optimizar una estructura de datos clave:
// Versión inicial - problemas de performance
struct OrderBook {
    orders: Vec,
    timestamp: u64,
}

// Versión optimizada
struct OptimizedOrderBook {
    orders: [Order; 1024],  // Array de tamaño fijo
    count: usize,
    timestamp: u64,
    _padding: [u8; 64],    // Alineación de cache line
}
La versión optimizada:
- Usa array de tamaño fijo en lugar de Vec para evitar allocations del heap
- Mantiene los datos contiguos en memoria para mejor localidad
- Agrega padding para alinear con cache lines (64 bytes)
- Trackea count manualmente para evitar bounds checking overhead
Tabla comparativa de impactos
| Operación | Vec | [Order; N] | Impacto en latencia |
|---|---|---|---|
| Insertar orden | Posible reallocation | Ninguna | Hasta 1000ns |
| Iterar 100 ordenes | Cache misses frecuentes | Cache friendly | 200-500ns |
| Acceso random | Bounds checking | Bounds checking (opt) | 10-20ns |
Caso de estudio
Un exchange de criptomonedas procesaba 50,000 ordenes/segundo con picos de latencia de 2ms. El problema: allocations frecuentes en el matching engine. La solucion:
Problema identificado: Cada nueva orden causaba allocation en Vec::push()
Solucion implementada:
// Pool de memoria pre-asignada
struct OrderPool {
    blocks: Box<[Order; 65536]>,
    free_list: Vec,
}

impl OrderPool {
    fn allocate(&mut self) -> &mut Order {
        match self.free_list.pop() {
            Some(idx) => &mut self.blocks[idx],
            None => panic!("Pool exhausted"),
        }
    }

    fn deallocate(&mut self, idx: usize) {
        self.free_list.push(idx);
    }
}
Resultado: Latencia reducida a 800μs (60% mejora) y variabilidad disminuida en 75%.
Errores comunes
- Usar Vec cuando sabes el tamaño maximo: Siempre que conozcas el limite superior, usa arrays o Box<[T]> para allocations estaticas.
- Ignorar alignment: Estructuras mal alineadas causan cache misses. Usa #[repr(align(64))] para estructuras criticas.
- Boxear primitivas pequeñas: Evita Box
o Rc . El overhead supera el beneficio. - No reutilizar memoria: En loops criticos, reutiliza buffers en lugar de crear nuevos.
- Subestimar drop times: Destructores complejos pueden introducir latencia inesperada.
Checklist de dominio
- ¿Puedes identificar todas las allocations de heap en tu hot path?
- ¿Tus estructuras de datos estan alineadas con cache lines?
- ¿Usas iteradores en lugar de indexing manual cuando es posible?
- ¿Has medido el impacto de bounds checking en tu codigo critico?
- ¿Tienes un memory pool para objetos frecuentemente allocados?
- ¿Evitas trait objects en codigo de baja latencia?
- ¿Comprendes el layout de memoria de tus enums mas grandes?
Optimizacion de un Message Router para Baja Latencia
Implementa un router de mensajes que procese paquetes de red con latencia sub-microsegundo.
- Crea una estructura
PacketBufferque almacene hasta 4096 paquetes de 256 bytes cada uno- Usa memoria pre-asignada (no allocations dinamicas)
- Implementa un ring buffer para manejo eficiente
- Asegura alineacion de 64 bytes
- Implementa el metodo
process_batch(&mut self, count: usize) -> usize- Procesa multiples paquetes en un solo ciclo
- Devuelve el numero de paquetes procesados exitosamente
- Evita bounds checking innecesario usando iteradores
- Agrega metricas de performance
- Mide el tiempo por lote procesado
- Trackea cache misses usando contadores
- Verifica que no haya allocations durante el procesamiento
- Escribe benchmarks que demuestren:
- Latencia consistente bajo 1μs por lote de 100 paquetes
- Cero allocations durante operacion normal
- Uso eficiente de cache lines
Pistas
- Considera usar unsafe code solo donde sea absolutamente necesario y documentalo completamente
- Los ring buffers funcionan mejor cuando su tamaño es potencia de dos
- Usa #[inline(always)] para funciones criticas en el hot path
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Rust para Trading: Concurrencia, Seguridad y Baja Latencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.