

Lección 8 de 21 · Lectura y práctica
Quiz: Evaluación de Técnicas de Cache con Redis
Tipo de lección: QuizConcepto claveEl caching con Redis es una técnica que almacena datos frecuentemente accedidos en memoria para reducir la latencia y la carga en bases de datos principales. Imagina una biblioteca donde los.
Del concepto a la práctica
Taller de esta lección
La evaluación contrasta rendimiento con consistencia. Una copia cacheada es válida solo dentro de su política: clave correcta, TTL definido, serialización recuperable e invalidación cuando cambia la fuente. También debes distinguir una tasa de hit de una reducción de latencia; son métricas relacionadas, no idénticas.
Ejemplo resuelto
Con 10 solicitudes, 6 hits y 4 misses, la tasa de hit es 6/10*100 = 60%. Si los misses consultan la fuente, hubo 4 consultas reales, pero no se puede deducir una latencia exacta sin mediciones.
Fixture completo para10 solicitudes: H,H,M,H,M,H,H,M,H,M da6hits/4misses y60%. Para las cinco claves usa TTL observados30,20,−2,15,−2 en un instante de prueba;−2 indica ausencia, no una cache con vida negativa. No presupongas que existencia de una clave equivale a contenido válido/autorizado; comprueba versión/forma y la política de privacidad.
Pruébalo
Revisa cinco claves y anota su TTL.
Marca cada solicitud como hit o miss.
Calcula la tasa con la fórmula indicada.
Busca una escritura que requiera invalidación.
Comprueba tu resultado
Error frecuente: afirmar que 60% de hit significa 60% menos latencia. Corrige presentando ambas métricas por separado. Resultado esperado: la clasificación coincide con la existencia de cada clave, la tasa se calcula sobre 10 solicitudes y ninguna latencia se reporta sin tiempos medidos.
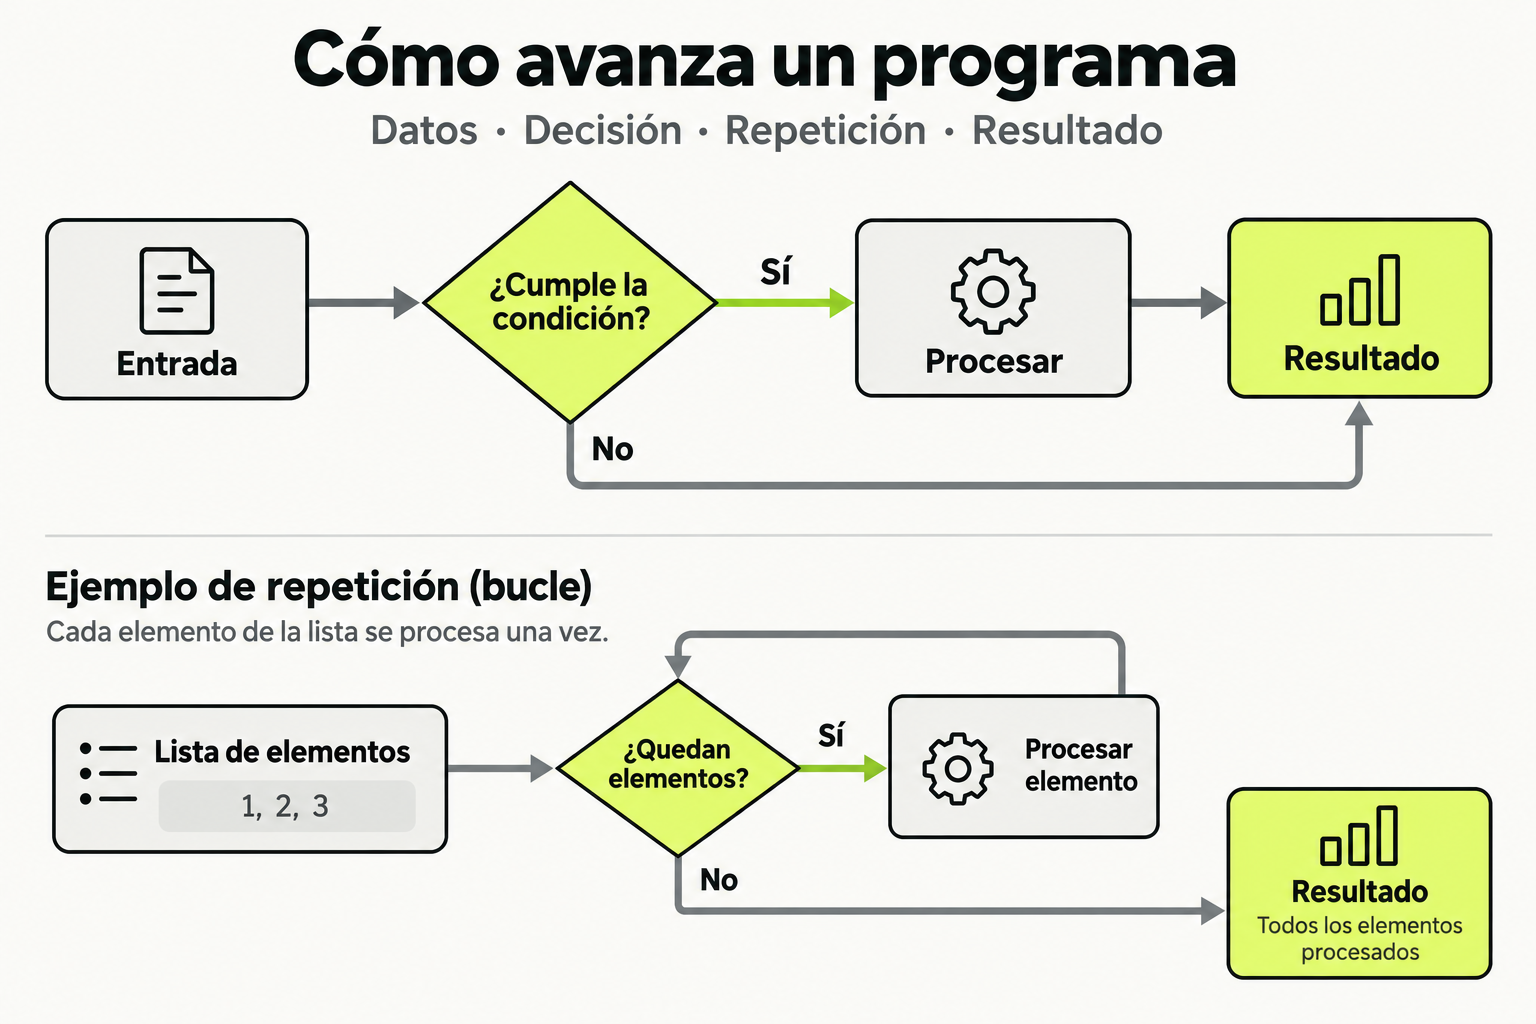
 Mapa de práctica
Una condición decide qué camino ejecuta el programa. Un bucle repite una operación mientras queden elementos, y termina cuando la lista se agota. Separar ambas ideas ayuda a seguir el flujo y comprobar casos límite.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
El caching con Redis es una técnica que almacena datos frecuentemente accedidos en memoria para reducir la latencia y la carga en bases de datos principales. Imagina una biblioteca donde los libros más populares están en un estante especial al frente, en lugar de tener que buscarlos en los archivos cada vez. Esto acelera el acceso, pero requiere gestionar la consistencia (asegurar que los datos en cache coincidan con la fuente de verdad) y la caducidad (eliminar datos obsoletos). En producción, un cache efectivo puede reducir tiempos de respuesta de segundos a milisegundos, mejorando la experiencia del usuario y escalabilidad.
Redis es ideal para cache porque es rápido (en memoria), soporta estructuras de datos flexibles como strings y hashes, y ofrece comandos como SETEX para caducidad automática. Sin embargo, no es solo un almacén pasivo; estrategias como cache-aside (la aplicación gestiona la lectura/escritura) o write-through (escribir en cache y base de datos simultáneamente) determinan cómo se integra. Un error común es tratar el cache como almacenamiento permanente, lo que puede llevar a pérdida de datos si Redis se reinicia sin persistencia configurada.
Cómo funciona en la práctica
Implementar cache con Redis sigue un flujo paso a paso. Supongamos una aplicación web que muestra perfiles de usuario:
- Diseñar la clave de cache: Usa un patrón como
user:{id}:profilepara identificar datos únicamente. Por ejemplo,user:123:profilepara el usuario con ID 123. - Leer datos: Al recibir una solicitud para el perfil del usuario 123, la aplicación primero verifica Redis con
GET user:123:profile. Si existe (cache hit), devuelve los datos inmediatamente. - Manejar cache miss: Si no está en cache (cache miss), consulta la base de datos principal, almacena el resultado en Redis con
SETEX user:123:profile 3600 '{"name":"Ana","email":"ana@example.com"}'(caduca en 3600 segundos), y luego devuelve los datos. - Actualizar datos: Cuando el perfil cambia, invalida el cache con
DEL user:123:profileo actualízalo directamente para mantener consistencia.
Este enfoque reduce la carga en la base de datos, pero requiere monitorear métricas como la tasa de hits (éxitos) vs. misses (fallos) para ajustar la caducidad o estrategias.
Caso de estudio
Una plataforma de e-commerce con alto tráfico usa Redis para cachear productos populares. Cada producto tiene detalles como nombre, precio y stock. Implementan cache-aside:
- Escenario: Durante el Black Friday, miles de usuarios buscan el producto "Smartphone X". Sin cache, cada solicitud consulta la base de datos, causando latencia de 500ms.
- Solución: Configuran Redis con una clave
product:789:detailspara el producto ID 789, almacenando un JSON con los datos. UsanSETEXcon 300 segundos de caducidad, ya que el precio puede cambiar rápidamente. - Resultado: El 90% de las solicitudes son cache hits, reduciendo la latencia a 50ms. La base de datos maneja solo el 10% de las consultas, evitando cuellos de botella. Incluyen una tabla de métricas:
| Métrica | Sin Cache | Con Cache |
|---|---|---|
| Latencia promedio | 500 ms | 50 ms |
| Carga en base de datos | 1000 consultas/seg | 100 consultas/seg |
| Tasa de cache hit | 0% | 90% |
En producción, un cache bien configurado puede mejorar el rendimiento en un orden de magnitud, pero requiere balancear caducidad y consistencia para datos dinámicos.
Errores comunes
- No configurar caducidad (TTL): Almacenar datos indefinidamente puede llevar a stale data (datos obsoletos) si cambian en la fuente. Usa
SETEXoEXPIREpara definir un tiempo de vida basado en la volatilidad de los datos. - Cachear datos poco accedidos: Si un dato se consulta raramente, cachearlo ocupa memoria innecesaria en Redis. Analiza patrones de acceso con herramientas como
INFO statspara enfocarte en datos calientes (hot data). - Ignorar la serialización: Almacenar objetos complejos sin convertirlos a un formato como JSON puede causar errores de lectura. Usa bibliotecas como JSON.stringify en Node.js o pickle en Python antes de guardar.
- Sobreescribir el cache en escrituras: En estrategias write-through, asegúrate de actualizar tanto Redis como la base de datos; de lo contrario, puede haber inconsistencia. Considera usar transacciones o pipelines de Redis para atomicidad.
- No monitorear el uso de memoria: Redis es en memoria, y si se llena, puede rechazar nuevas escrituras. Configura límites con
maxmemoryy políticas comoallkeys-lrupara evicción automática.
Checklist de dominio
- ¿Puedes diseñar claves de cache únicas y descriptivas para tu aplicación (ej:
user:{id}:data)? - ¿Implementas una estrategia de cache (como cache-aside) con manejo de cache hits y misses?
- ¿Configuras TTL apropiado basado en la frecuencia de cambio de los datos (ej: 300 segundos para precios)?
- ¿Invalidas o actualizas el cache cuando los datos cambian en la fuente para mantener consistencia?
- ¿Monitoreas métricas como tasa de cache hit y uso de memoria en Redis con comandos como
INFO? - ¿Serializas datos complejos a formatos como JSON antes de almacenar en Redis?
- ¿Planificas para fallos de cache (ej: usar base de datos como respaldo si Redis no está disponible)?
Implementa Cache-aside para una API de Productos
En este ejercicio, simularás una API backend que usa Redis para cachear detalles de productos. Sigue estos pasos:
- Configura un entorno local: Instala Redis en tu máquina o usa un contenedor Docker. Asegúrate de que esté corriendo en el puerto predeterminado 6379.
- Crea una aplicación simple: Usa un lenguaje como Node.js, Python o Java. Crea un endpoint
/product/:idque devuelva detalles de un producto (ej: nombre, precio) desde una base de datos simulada (puede ser un objeto en memoria). - Integra Redis: Conecta tu aplicación a Redis usando una biblioteca cliente (ej: redis para Node.js, redis-py para Python). Implementa la lógica de cache-aside:
- Al recibir una solicitud para un producto ID, primero intenta obtenerlo de Redis con una clave como
product:{id}:details. - Si está en cache (cache hit), devuelve los datos y registra un log.
- Si no está (cache miss), consulta la base de datos simulada, almacena el resultado en Redis con
SETEXy un TTL de 60 segundos, luego devuelve los datos.
- Al recibir una solicitud para un producto ID, primero intenta obtenerlo de Redis con una clave como
- Prueba el flujo: Usa una herramienta como curl o Postman para hacer solicitudes a tu endpoint. Verifica que la primera solicitud sea un cache miss y las subsiguientes (dentro de 60 segundos) sean cache hits.
- Agrega invalidación: Crea otro endpoint
/product/:id/updateque simule actualizar el producto en la base de datos. Asegúrate de invalidar el cache correspondiente conDELpara mantener consistencia.
Al final, deberías tener una API funcional que demuestre cómo Redis acelera las lecturas y maneja actualizaciones.
Pistas
- Usa el comando SETEX en Redis para almacenar datos con caducidad automática, evitando datos obsoletos.
- En un cache miss, asegúrate de serializar los datos a un formato como JSON antes de guardar en Redis para compatibilidad.
- Monitorea los logs para verificar cache hits y misses; esto te ayudará a ajustar el TTL si es necesario.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Redis en Producción: Cache, Sesiones y Colas para Backend Engineers
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.