

Lección 8 de 20 · Lectura y práctica
Manejo de límites de contexto y estrategias de chunking
Tipo de lección: VideoConcepto claveLos límites de contexto son restricciones de longitud en las APIs de GPT y Claude que definen cuánto texto pueden procesar en una sola solicitud. Imagina que estás intentando contar una.
Del concepto a la práctica
Taller de esta lección
El chunking debe conservar significado y posición. Divide un manual por párrafos, limita cada fragmento a una cantidad definida y añade solapamiento solo cuando una idea cruza el corte. Guarda el índice para reconstruir el orden.
Ejemplo resuelto
Párrafos [P1,P2,P3,P4], tamaño máximo 2 y solapamiento 1 producen [P1,P2], [P2,P3], [P3,P4]. P2 y P3 aparecen dos veces para preservar continuidad; el orden original se recupera ordenando por índice inicial.
Pruébalo
Numera seis párrafos.
Usa tamaño 3 y solapamiento 1.
Registra inicio, fin y texto de cada fragmento.
Comprueba que ningún fragmento exceda el límite.
Error frecuente: cortar por caracteres sin respetar párrafos; corrígelo usando separadores semánticos y una regla para párrafos largos.
Comprueba tu resultado
Con seis párrafos, el resultado esperado es [P1,P2,P3], [P3,P4,P5], [P5,P6]. Los índices iniciales son 1, 3 y 5; no debe perderse ningún párrafo.
Límite por párrafos y límite por tokens
El tamaño del ejemplo es cantidad de párrafos, no tokens. Un solo párrafo puede exceder la ventana: define una división secundaria por frases y después por segmentos medidos. Valida 0 <= solapamiento < tamaño, porque un avance cero crearía un bucle. Conserva documento_id, posiciones y versión; deduplica citas por posición al reconstruir P2 y P3. Con seis párrafos y tamaño3/solapamiento1, cubres P1–P6 en tres fragmentos, sin asumir que caben en un modelo específico.
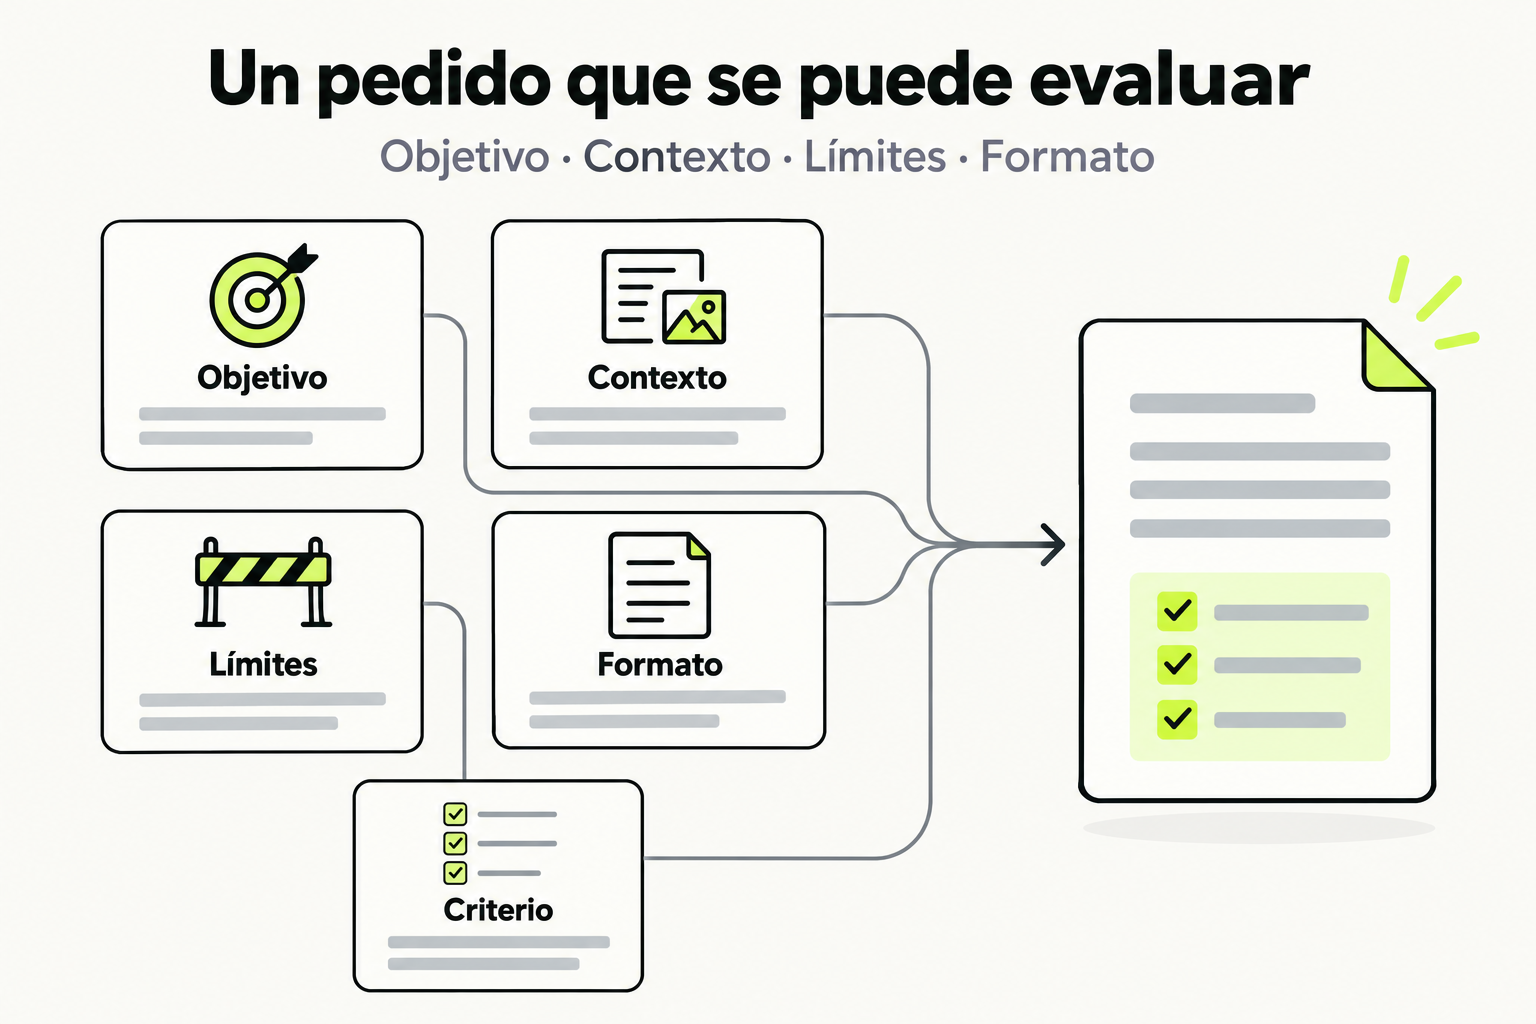
 Mapa de práctica
Un pedido útil explica qué resultado se busca y aporta el contexto necesario. Los límites y el formato reducen ambigüedades. Un criterio observable permite revisar el resultado y pedir un ajuste concreto.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Video
Concepto clave
Los límites de contexto son restricciones de longitud en las APIs de GPT y Claude que definen cuánto texto pueden procesar en una sola solicitud. Imagina que estás intentando contar una historia muy larga a alguien con memoria limitada: si superas su capacidad, olvidará el principio. En el mundo real, esto se parece a cuando un abogado debe analizar un contrato de 100 páginas pero solo puede revisar 10 páginas a la vez, necesitando estrategias para mantener la coherencia.
El chunking es la técnica de dividir textos largos en fragmentos manejables que respeten estos límites. No es simplemente cortar al azar, sino hacerlo de forma inteligente que preserve el significado. Piensa en cómo un editor de video divide una película en escenas: cada escena tiene sentido por sí misma, pero juntas cuentan la historia completa. En desarrollo de sistemas, esto evita errores como truncamiento de respuestas o pérdida de información crítica.
Cómo funciona en la práctica
Veamos un ejemplo paso a paso para procesar un documento técnico de 15,000 tokens (el límite típico de GPT-4 es 8,192 tokens para el contexto):
- Análisis inicial: Primero, evalúa la longitud total del texto usando una función de tokenización. No asumas que 1 palabra = 1 token; en español, los tokens suelen ser más cortos.
- División estratégica: Divide en fragmentos basándote en párrafos, secciones o puntos naturales de ruptura. Nunca cortes en medio de una oración o idea.
- Procesamiento secuencial: Envía cada fragmento a la API con instrucciones claras sobre el contexto. Mantén un resumen o estado entre fragmentos.
- Síntesis final: Combina los resultados parciales en una respuesta coherente.
Un error común es intentar procesar todo de una vez y recibir un error de "context length exceeded". La solución sistemática previene esto.
Código en acción
Aquí un ejemplo funcional en Python usando la biblioteca tiktoken para tokenización y la API de OpenAI:
import tiktoken
import openai
from typing import List

def chunk_text(text: str, max_tokens: int = 4000) -> List[str]:
    """Divide texto en fragmentos respetando límites de tokens"""
    encoding = tiktoken.get_encoding("cl100k_base")
    tokens = encoding.encode(text)

    chunks = []
    current_chunk = []
    current_length = 0

    for token in tokens:
        if current_length + 1 > max_tokens:
            # Finaliza el fragmento actual y comienza uno nuevo
            chunks.append(encoding.decode(current_chunk))
            current_chunk = [token]
            current_length = 1
        else:
            current_chunk.append(token)
            current_length += 1

    if current_chunk:
        chunks.append(encoding.decode(current_chunk))

    return chunks

# Ejemplo de uso
long_document = """[Contenido de un documento largo aquí...]"""
fragments = chunk_text(long_document, max_tokens=4000)
print(f"Documento dividido en {len(fragments)} fragmentos")
Ahora, el código mejorado que preserva párrafos completos:
def chunk_by_paragraphs(text: str, max_tokens: int = 4000) -> List[str]:
    """Divide por párrafos completos, mejorando la coherencia"""
    encoding = tiktoken.get_encoding("cl100k_base")
    paragraphs = text.split('\n\n')

    chunks = []
    current_chunk = []
    current_length = 0

    for para in paragraphs:
        para_tokens = encoding.encode(para)
        para_length = len(para_tokens)

        if current_length + para_length > max_tokens and current_chunk:
            # Cierra el fragmento actual
            chunks.append('\n\n'.join(current_chunk))
            current_chunk = [para]
            current_length = para_length
        else:
            current_chunk.append(para)
            current_length += para_length

    if current_chunk:
        chunks.append('\n\n'.join(current_chunk))

    return chunks

# Comparación: el primer método puede cortar párrafos, el segundo los preserva
Errores comunes
- Corte en medio de oraciones: Dividir sin considerar la estructura gramatical produce fragmentos sin sentido. Solución: Usa división por párrafos o puntos de ruptura lógicos.
- Ignorar el overhead del prompt: No reservar tokens para las instrucciones del sistema y del usuario. Solución: Calcula max_tokens = límite_contexto - tokens_instrucciones - tokens_respuesta.
- Pérdida de contexto entre fragmentos: Procesar cada parte de forma aislada. Solución: Incluye resúmenes o referencias cruzadas entre solicitudes.
- Asumir longitud constante: Creer que 1,000 palabras = 1,000 tokens. Solución: Siempre usa tokenización real antes de enviar.
- No manejar errores de límite: No tener plan B cuando el texto excede capacidades. Solución: Implementa truncamiento inteligente o procesamiento jerárquico.
Checklist de dominio
- ¿Calculas los tokens exactos antes de enviar a la API?
- ¿Divides los textos en puntos naturales (párrafos, secciones)?
- ¿Incluyes contexto suficiente entre fragmentos para mantener coherencia?
- ¿Reservas tokens para el prompt del sistema y la respuesta esperada?
- ¿Tienes estrategia para documentos que exceden todos los límites (ej: resumen jerárquico)?
- ¿Validas que los fragmentos mantengan significado independiente?
- ¿Documentas los límites específicos de cada modelo que usas?
Implementa un sistema de procesamiento de contratos legales
Desarrolla un script que procese contratos legales largos usando chunking inteligente. Sigue estos pasos:
- Descarga un contrato de ejemplo de 20 páginas (puedes usar texto de prueba).
- Implementa una función que divida el contrato por secciones (identificadas por títulos como "1. DEFINICIONES", "2. OBLIGACIONES").
- Para cada sección, verifica si excede 3,000 tokens. Si es así, subdivídela por párrafos.
- Procesa cada fragmento con un prompt que extraiga: partes involucradas, obligaciones clave y fechas límite.
- Combina los resultados en un resumen estructurado del contrato completo.
- Agrega manejo de errores para cuando algún fragmento aún exceda los límites.
Entrega: Código Python funcional con al menos 3 fragmentos de contrato de prueba.
Pistas
- Usa expresiones regulares para identificar secciones por números y títulos en mayúsculas.
- Mantén un diccionario de contexto que pases entre fragmentos (ej: 'En la sección anterior, las partes eran X e Y').
- Considera usar un modelo con contexto extendido (como GPT-4-128k) para secciones particularmente largas.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.