

Lección 5 de 20 · Lectura y práctica
Evaluación de técnicas básicas de prompting
Tipo de lección: QuizConcepto claveLa evaluacion de tecnicas de prompting es el proceso sistematico de probar, medir y comparar diferentes enfoques para interactuar con APIs de lenguaje como GPT y Claude. No se trata solo de.
Del concepto a la práctica
Taller de esta lección
Evaluar un prompt significa comparar salidas contra una referencia definida. Para una extracción de fechas, la exactitud exige igualdad normalizada, mientras que una respuesta abierta necesita criterios separados. El conjunto de prueba debe incluir entradas completas y ambiguas.
Ejemplo resuelto
Referencias con formato de entrada declarado DD/MM/AAAA: "Pago el 03/04/2026"→2026-04-03, "sin fecha"→null, "el viernes"→requiere_contexto. Una variante acierta 2 de 3 si devuelve exactamente los dos primeros resultados esperados y para la tercera inventa una fecha en lugar de devolver requiere_contexto. Si devuelve requiere_contexto, acierta 3 de 3.
Pruébalo
Crea seis casos con tres categorías.
Fija una salida esperada por caso.
Normaliza espacios y mayúsculas, no el significado.
Cuenta aciertos y fallos por categoría.
Error frecuente: cambiar la referencia para favorecer al prompt; corrígelo congelando el conjunto antes de probar.
Comprueba tu resultado
Tu tabla debe tener seis filas, una columna de referencia y otra de salida. La tasa global será aciertos/6; además debe mostrar cuántos fallos pertenecen a sin fecha y requiere_contexto.
Congela la regla de normalización
03/04/2026 se interpreta como 3 de abril solo por la convención declarada. Con una fuente sin localidad usa requiere_contexto, en lugar de adivinar mes/día. null es ausencia y requiere_contexto es una categoría distinta. Define qué casos son inválidos antes de evaluar y no cambies sus referencias al ver las salidas. Documenta también rechazos y truncamientos; no los retires del denominador para mejorar la tasa.
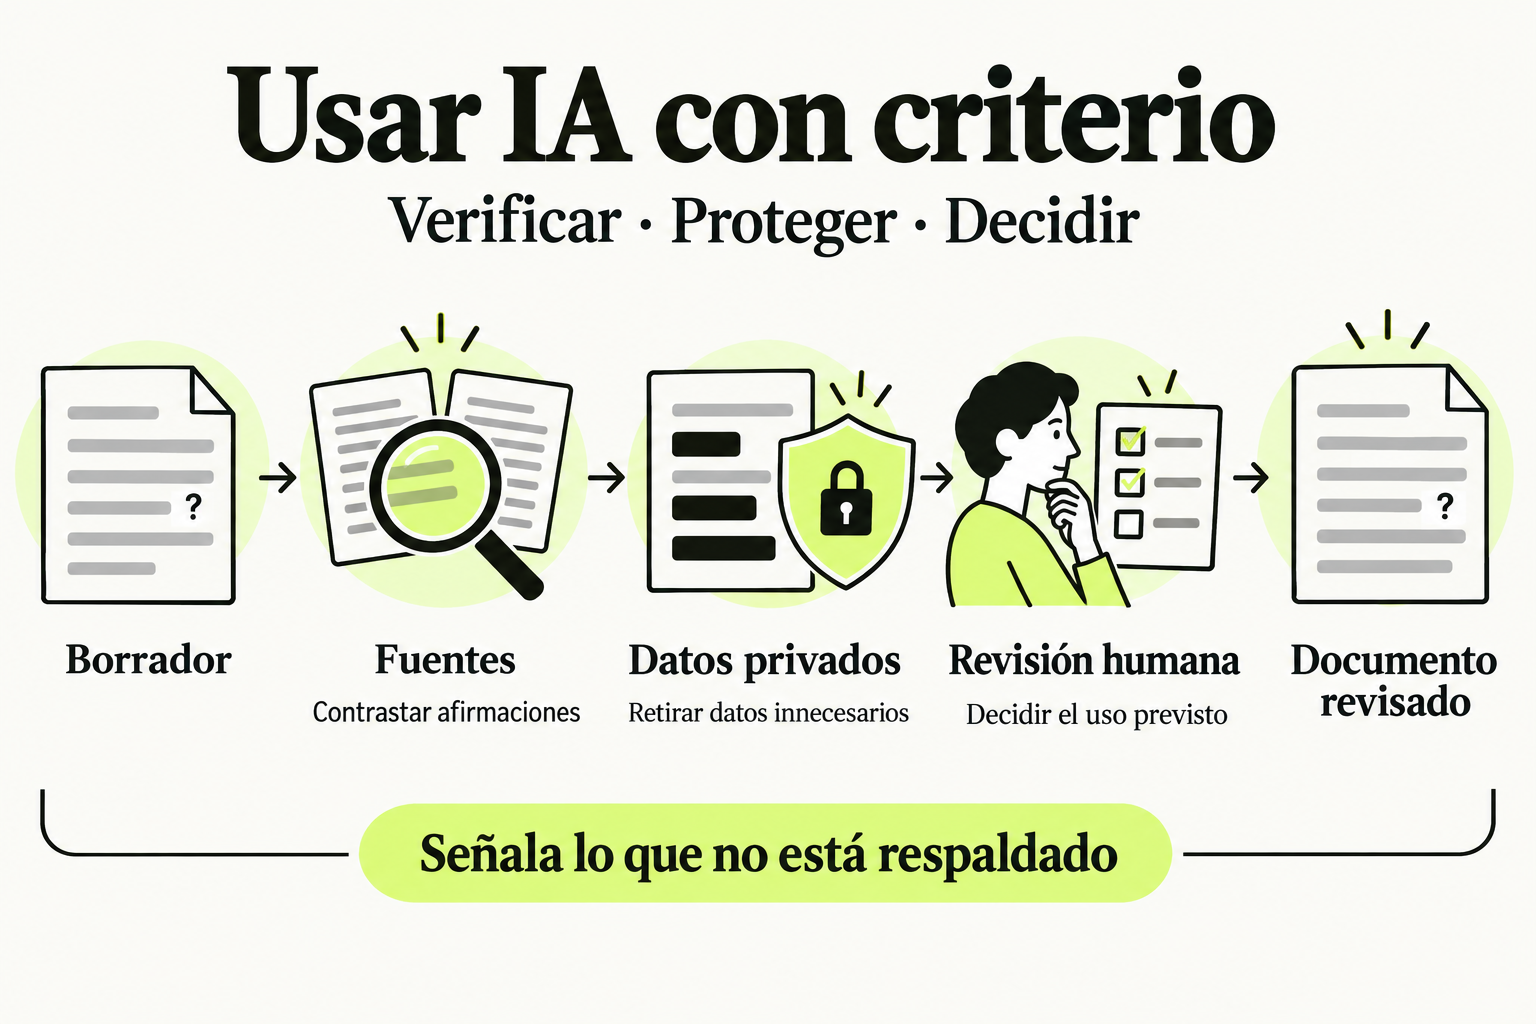
 Mapa de práctica
Contrasta las afirmaciones con fuentes y señala lo que no está respaldado. Retira datos privados innecesarios antes de compartir el material. La revisión humana decide si el borrador sirve para su uso previsto y conserva las incertidumbres relevantes.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Tipo de lección: Quiz
Concepto clave
La evaluacion de tecnicas de prompting es el proceso sistematico de probar, medir y comparar diferentes enfoques para interactuar con APIs de lenguaje como GPT y Claude. No se trata solo de escribir prompts, sino de validar que funcionen de manera consistente y predecible en entornos de produccion.
Imagina que eres un chef probando recetas: no basta con que un plato sepa bien una vez, debes asegurarte de que cualquier cocinero pueda replicarlo con los mismos ingredientes y obtener resultados identicos. En el contexto de desarrollo, esto significa crear prompts que sean robustos ante variaciones en las entradas y que mantengan su efectividad a lo largo del tiempo.
Como funciona en la practica
El proceso de evaluacion sigue un ciclo de cuatro pasos:
- Definir metricas claras: ¿Que consideras exito? Puede ser precision, relevancia, formato de salida, o tiempo de respuesta.
- Crear conjunto de pruebas: Un set de casos representativos de tu aplicacion real.
- Ejecutar comparaciones: Probar diferentes versiones de prompts con las mismas entradas.
- Analizar resultados: Identificar patrones y puntos de falla para iterar.
Por ejemplo, si estas construyendo un sistema que extrae fechas de documentos, tu conjunto de pruebas deberia incluir diferentes formatos de fecha ("15/03/2024", "Marzo 15, 2024", "2024-03-15") y casos limite como fechas incompletas o ambiguas.
Codigo en accion
Antes: Evaluacion manual y subjetiva
# Ejemplo de evaluacion basica (no recomendado)
import openai

response = openai.ChatCompletion.create(
    model="gpt-4",
    messages=[
        {"role": "system", "content": "Extrae la fecha del texto"},
        {"role": "user", "content": "La reunion sera el proximo lunes"}
    ]
)
print(response.choices[0].message.content)
# Salida: "La fecha es el proximo lunes"
# ¿Es correcto? Depende de la interpretacion
Despues: Evaluacion sistematica con metricas
# Evaluacion estructurada con conjunto de pruebas
import openai
from datetime import datetime

test_cases = [
    {"input": "La reunion sera el 15/03/2024", "expected": "2024-03-15"},
    {"input": "Nos vemos el proximo lunes", "expected": "fecha_relativa"},
    {"input": "El evento es en Marzo 2024", "expected": "2024-03"}
]

def evaluate_prompt(prompt_template, test_cases):
    results = []
    for test in test_cases:
        response = openai.ChatCompletion.create(
            model="gpt-4",
            messages=[
                {"role": "system", "content": prompt_template},
                {"role": "user", "content": test["input"]}
            ],
            temperature=0  # Para consistencia
        )
        output = response.choices[0].message.content

        # Metrica simple: coincidencia exacta
        is_correct = (output == test["expected"])
        results.append({
            "input": test["input"],
            "expected": test["expected"],
            "actual": output,
            "correct": is_correct
        })

    accuracy = sum([r["correct"] for r in results]) / len(results)
    return {"accuracy": accuracy, "details": results}

# Probamos dos versiones de prompt
prompt_v1 = "Extrae la fecha del texto y devuelvela en formato YYYY-MM-DD"
prompt_v2 = "Analiza el texto. Si contiene una fecha especifica, convertila a formato ISO (YYYY-MM-DD). Si es una fecha relativa, responde 'fecha_relativa'. Si es un mes y ano, usa YYYY-MM."

print("Version 1:", evaluate_prompt(prompt_v1, test_cases)["accuracy"])
print("Version 2:", evaluate_prompt(prompt_v2, test_cases)["accuracy"])
Errores comunes
- Evaluar con muy pocos casos: Tres o cuatro ejemplos no representan el comportamiento real. Solucion: Crear conjuntos de pruebas con al menos 20-30 casos variados.
- Usar solo metricas binarias: "Correcto/Incorrecto" ignora matices. Solucion: Incluir metricas como precision, recall, o puntuaciones de calidad.
- Olvidar el contexto de produccion: Lo que funciona en desarrollo puede fallar con datos reales. Solucion: Incluir ejemplos de produccion en las pruebas.
- Ignorar la consistencia: Un prompt que funciona el 90% del tiempo puede ser inaceptable. Solucion: Ejecutar multiples iteraciones y medir varianza.
- No documentar los resultados: Perder el aprendizaje entre iteraciones. Solucion: Mantener un registro de prompts, metricas y observaciones.
Checklist de dominio
- Tengo definidas metricas claras y medibles para mis prompts
- Mi conjunto de pruebas incluye casos normales, limite y de error
- Comparo al menos dos versiones de cada prompt importante
- Documento los resultados y las decisiones de diseno
- He probado los prompts con temperatura=0 para consistencia
- Incluyo ejemplos de produccion en mis evaluaciones
- Reviso regularmente el rendimiento en entorno real
Evaluacion comparativa de prompts para extraccion de informacion
En este ejercicio practico, vas a crear y evaluar dos versiones diferentes de prompts para extraer informacion estructurada de textos. Sigue estos pasos:
- Prepara tu entorno: Asegurate de tener acceso a una API de GPT o Claude (puedes usar OpenAI Playground o Anthropic Console si no tienes credenciales).
- Define el caso de uso: Vas a extraer informacion de productos de un e-commerce. Los textos pueden ser: "iPhone 15 Pro 256GB Negro - $999", "Samsung Galaxy S24 Ultra 512GB Azul en oferta", "Auriculares Sony WH-1000XM5 - Entrega gratis".
- Crea dos prompts diferentes:
- Version 1: Instrucciones simples para extraer nombre, capacidad, color y precio.
- Version 2: Instrucciones detalladas con ejemplos y reglas para manejar casos incompletos.
- Construye un conjunto de pruebas: Crea 5-7 ejemplos variados que incluyan productos con informacion completa, parcial, y formatos diferentes.
- Implementa la evaluacion: Usa el patron de codigo de la leccion para comparar ambas versiones. Mide precision y consistencia.
- Analiza resultados: Identifica en que casos cada prompt funciona mejor y por que.
- Documenta tus hallazgos: Crea un breve informe con metricas, ejemplos de salidas, y recomendaciones.
Pistas
- Comienza con casos simples y luego agrega complejidad gradualmente
- Presta atencion a como cada prompt maneja informacion faltante o ambigua
- Considera usar JSON como formato de salida para facilitar la validacion
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.