

Lección 16 de 20 · Lectura y práctica
Diseño de arquitectura para aplicaciones con LLM APIs
Concepto claveEl diseño de arquitectura para aplicaciones con LLM APIs se refiere a la estructura organizada de componentes que integran modelos de lenguaje como GPT o Claude en sistemas full stack. Imagina construir una fábrica.
Del concepto a la práctica
Taller de esta lección
Una arquitectura mantenible separa responsabilidades: la ruta recibe datos, el servicio construye el prompt, el adaptador comunica con el proveedor y el validador comprueba la salida. Esta separación permite probar la lógica sin llamar a un servicio real.
Ejemplo resuelto
Flujo: POST /clasificar → normalizar() → crearPrompt() → adaptador.simular() → validar() → respuesta. Si el adaptador devuelve {"intención":"envío","urgencia":"media"}, el validador acepta; si falta intención, responde error 502 interno traducido a mensaje seguro.
Pruébalo
Dibuja las seis piezas.
Define un contrato entre cada frontera.
Sustituye el adaptador real por una respuesta fija.
Prueba éxito y salida inválida.
Error frecuente: poner la clave y la lógica de negocio en la ruta; corrígelo encapsulando proveedor y configuración.
Comprueba tu resultado
La prueba simulada debe funcionar sin red. Una salida sin intención debe rechazarse antes de llegar al frontend, y ninguna respuesta debe incluir secretos.
Validador que se puede ejecutar sin proveedor
INTENCIONES = {"producto", "envío", "pago", "ambiguo"}
URGENCIAS = {"baja", "media", "alta"}
def validar(d):
    if not isinstance(d, dict) or set(d) != {"intención", "urgencia"}:
        raise ValueError("Contrato incompleto")
    if not isinstance(d["intención"], str) or d["intención"] not in INTENCIONES:
        raise ValueError("Intención inválida")
    if not isinstance(d["urgencia"], str) or d["urgencia"] not in URGENCIAS:
        raise ValueError("Urgencia inválida")
    return dict(d)
assert validar({"intención": "envío", "urgencia": "media"})["urgencia"] == "media"
Una respuesta que solo trae intención no cumple este contrato. El adaptador simulado la devuelve para probar el error 502 público sin exponer su contenido bruto. Separa error de entrada, de proveedor y de contrato para que el frontend pueda conservar el mensaje original del usuario.
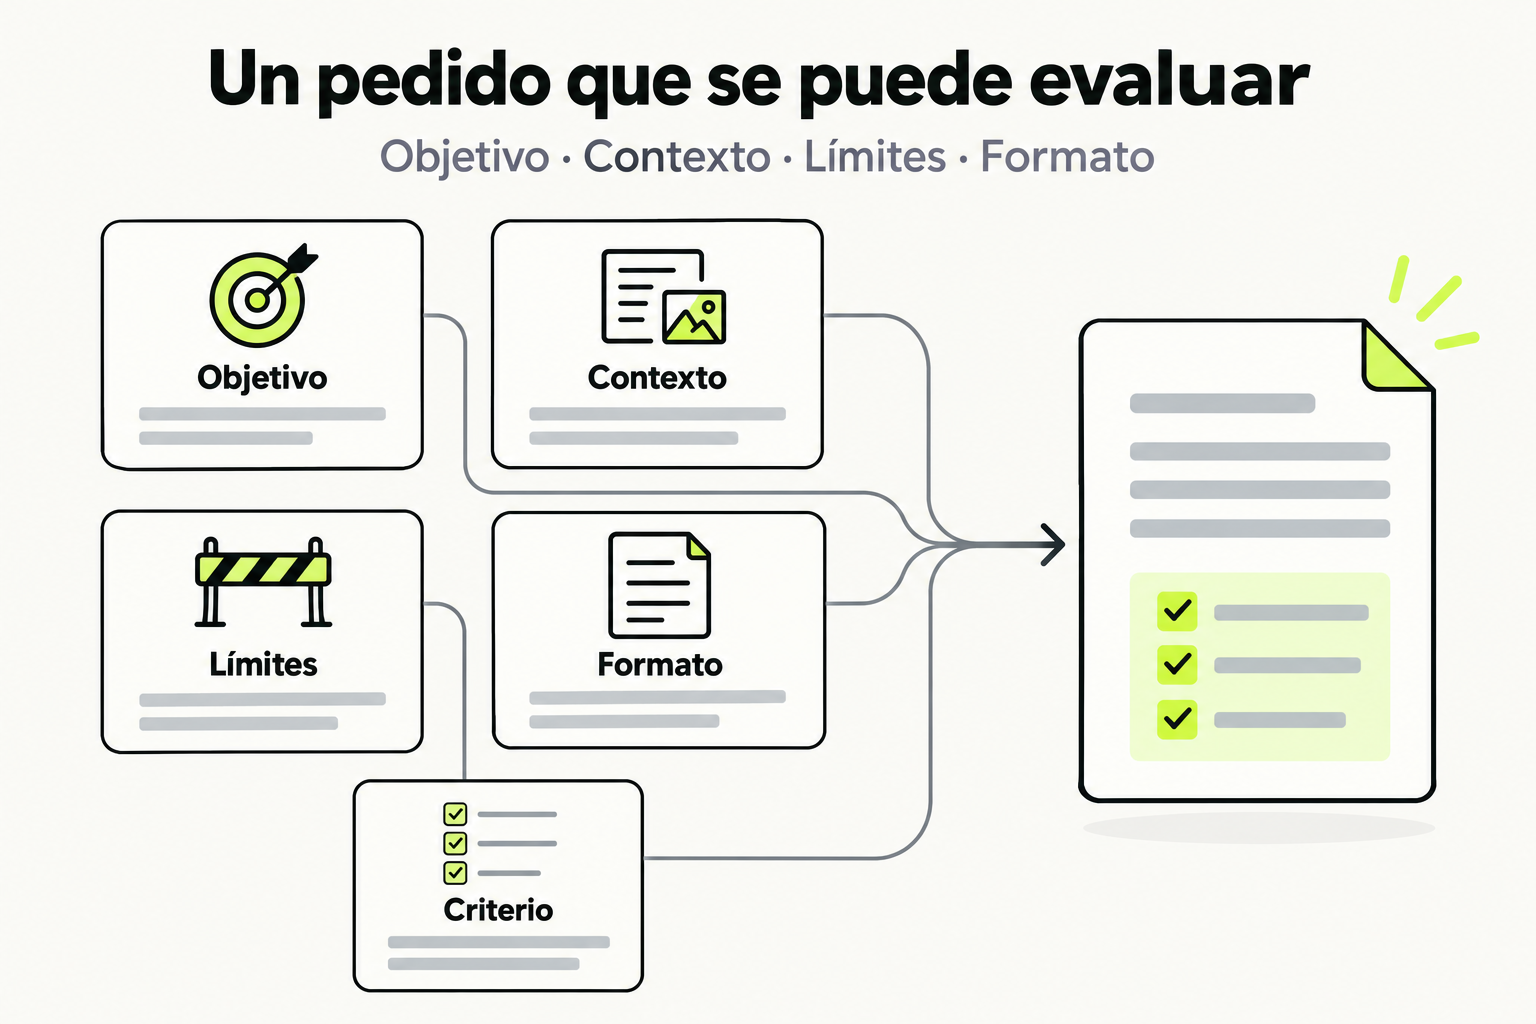
 Mapa de práctica
Un pedido útil explica qué resultado se busca y aporta el contexto necesario. Los límites y el formato reducen ambigüedades. Un criterio observable permite revisar el resultado y pedir un ajuste concreto.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
El diseño de arquitectura para aplicaciones con LLM APIs se refiere a la estructura organizada de componentes que integran modelos de lenguaje como GPT o Claude en sistemas full stack. Imagina construir una fábrica inteligente: no basta con tener máquinas potentes (los LLMs), necesitas cintas transportadoras (APIs), controles de calidad (validación de prompts) y líneas de ensamblaje (flujos de trabajo) que funcionen en armonía. En desarrollo de software, esto significa crear una arquitectura escalable donde los prompts no sean instrucciones sueltas, sino partes de un sistema que maneje contexto, estado y lógica de negocio.
La clave está en separar responsabilidades: una capa para gestión de prompts, otra para comunicación con APIs, y una más para procesamiento de respuestas. Piensa en cómo un restaurante de alta cocina organiza su cocina: el chef (LLM) recibe pedidos estructurados (prompts optimizados) de los sous-chefs (sistema de prompting), quienes a su vez coordinan con meseros (interfaz de usuario) y almacén (base de datos). Esta separación permite mantenibilidad y adaptabilidad, crucial cuando trabajas con modelos que evolucionan o cuando necesitas cambiar proveedores de APIs.
Cómo funciona en la práctica
Vamos a diseñar una arquitectura para un asistente de soporte técnico integrado en una aplicación web. Paso 1: Identifica los componentes principales. Necesitarás: un módulo de interfaz (frontend), un servidor (backend), un servicio de gestión de prompts, y el cliente de API del LLM. Paso 2: Define el flujo de datos. El usuario escribe una consulta en el frontend, que envía al backend; el servicio de prompts estructura la consulta con contexto (ej., historial de conversación) y la envía al LLM; la respuesta se valida y procesa antes de devolverla al usuario.
Paso 3: Implementa la separación de capas. Por ejemplo, crea un directorio en tu proyecto con archivos como promptManager.js para manejar plantillas de prompts, llmService.js para llamadas a la API, y responseHandler.js para limpiar y estructurar respuestas. Esto evita el anti-patrón de mezclar lógica de negocio con llamadas directas al LLM, que puede llevar a código espagueti difícil de depurar.
Código en acción
Aquí un ejemplo básico de cómo estructurar el servicio de prompts en Node.js, mostrando el antes y después de refactorizar:
Antes (código acoplado):
// En el archivo principal del backend
export async function handleSupportQuery(userInput) {
  const prompt = `Responde como soporte técnico: ${userInput}`;
  const response = await fetch('https://api.openai.com/v1/chat/completions', {
    method: 'POST',
    headers: { 'Authorization': 'Bearer API_KEY', 'Content-Type': 'application/json' },
    body: JSON.stringify({ model: 'gpt-4', messages: [{ role: 'user', content: prompt }] })
  });
  const data = await response.json();
  return data.choices[0].message.content;
}
Después (arquitectura separada):
// promptManager.js
export class PromptManager {
  constructor(context) {
    this.context = context; // ej., historial de usuario
  }

  generateSupportPrompt(userInput) {
    return `Eres un asistente de soporte técnico experto. Contexto previo: ${this.context}. Usuario pregunta: ${userInput}. Responde de manera clara y concisa.`;
  }
}

// llmService.js
export class LLMService {
  constructor(apiKey, model = 'gpt-4') {
    this.apiKey = apiKey;
    this.model = model;
  }

  async callAPI(prompt) {
    const response = await fetch('https://api.openai.com/v1/chat/completions', {
      method: 'POST',
      headers: { 'Authorization': `Bearer ${this.apiKey}`, 'Content-Type': 'application/json' },
      body: JSON.stringify({ model: this.model, messages: [{ role: 'user', content: prompt }] })
    });
    return await response.json();
  }
}

// Uso en el backend principal
import { PromptManager } from './promptManager.js';
import { LLMService } from './llmService.js';

export async function handleSupportQuery(userInput, userContext) {
  const promptManager = new PromptManager(userContext);
  const llmService = new LLMService(process.env.API_KEY);
  const prompt = promptManager.generateSupportPrompt(userInput);
  const apiResponse = await llmService.callAPI(prompt);
  return apiResponse.choices[0].message.content;
}
Errores comunes
- Acoplamiento excesivo: Integrar llamadas al LLM directamente en la lógica de negocio, lo que dificulta cambios y pruebas. Solución: Usa servicios separados como en el ejemplo de código.
- Falta de gestión de contexto: Enviar prompts sin historial o estado, llevando a respuestas inconsistentes. Solución: Implementa un sistema que almacene y inyecte contexto relevante en cada prompt.
- Ignorar límites de tokens: Superar los límites de longitud de prompts, causando errores o costos elevados. Solución: Recorta o resume entradas largas antes de enviarlas.
- No manejar errores de API: Asumir que el LLM siempre responde, sin plan para fallos de red o cuotas excedidas. Solución: Agrega reintentos, timeouts y respuestas de respaldo.
- Prompting estático: Usar los mismos prompts para todos los usuarios, perdiendo personalización. Solución: Dinamiza prompts basados en datos de usuario o analytics.
Checklist de dominio
- ¿He separado la lógica de prompting en módulos independientes del resto de la aplicación?
- ¿Mi arquitectura permite cambiar fácilmente entre diferentes LLM APIs (ej., de GPT a Claude)?
- ¿He implementado validación y sanitización de respuestas del LLM antes de mostrarlas al usuario?
- ¿El sistema maneja adecuadamente el estado y contexto entre interacciones?
- ¿He incluido mecanismos de fallback para cuando la API del LLM no esté disponible?
- ¿Los prompts están parametrizados y son fáciles de ajustar sin modificar código?
- ¿He considerado la escalabilidad, como el uso de colas para manejar picos de solicitudes?
Diseña e implementa un servicio de prompting para un chatbot de e-commerce
En este ejercicio, crearás una arquitectura básica para un chatbot que ayuda en un sitio de e-commerce. Sigue estos pasos:
- Configura un proyecto Node.js simple con Express o un framework similar.
- Crea tres módulos:
promptBuilder.jspara generar prompts,llmClient.jspara comunicarte con una API de LLM (usa un mock o una API real si tienes clave), yresponseProcessor.jspara limpiar respuestas. - En
promptBuilder.js, define una función que tome un producto y una pregunta del usuario, y devuelva un prompt estructurado para el LLM (ej., incluye detalles del producto como contexto). - En
llmClient.js, implementa una función que envíe el prompt a la API y devuelva la respuesta cruda. - En
responseProcessor.js, añade lógica para extraer información clave o formatear la respuesta. - Integra estos módulos en una ruta de tu servidor que maneje consultas POST desde un frontend simulado.
- Prueba el flujo completo con al menos dos consultas diferentes.
Pistas
- Usa variables de entorno para almacenar claves de API y evitar hardcodear.
- Considera agregar un sistema de caché para respuestas frecuentes y reducir costos.
- Si no tienes acceso a una API real, simula respuestas con un objeto JSON para probar la arquitectura.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.