

Lección 2 de 20 · Lectura y práctica
Anatomía de un prompt efectivo: tokens, contextos y parámetros
Concepto claveUn prompt efectivo es como una especificacion de trabajo para un asistente humano experto. No solo pides algo, sino que defines claramente el contexto, las restricciones y el formato esperado. En APIs como GPT y.
Del concepto a la práctica
Taller de esta lección
Un prompt operativo separa objetivo, datos y contrato. Para clasificar una devolución, la instrucción fija las etiquetas permitidas, el contexto aporta el mensaje y el formato exige JSON; así la aplicación puede validar sin interpretar prosa.
Ejemplo resuelto
Entrada: "La cremallera llegó rota".
Prompt: Clasifica el mensaje. Etiquetas: producto, envío, pago. Devuelve JSON con intención y urgencia. Mensaje: .... Una salida válida es {"intención":"producto","urgencia":"alta"}. Temperatura, límite de salida y modelo son decisiones externas al contenido.
Pruébalo
Escribe tres bloques: objetivo, datos y formato.
Añade una etiqueta para mensajes ambiguos.
Cuenta caracteres de la instrucción y del mensaje por separado.
Verifica que la salida solo acepte etiquetas declaradas.
Error frecuente: mezclar un ejemplo con la entrada real; corrígelo delimitando ambos y validando campos.
Comprueba tu resultado
Prueba "¿Cuándo llega?": debe producir envío o ambiguo, pero nunca devolución. Comprueba además que intención y urgencia existan y sean cadenas permitidas.
Define etiquetas y unidades
Fija intención en producto/envío/pago/ambiguo y urgencia en baja/media/alta. Para el fixture cremallera rota, declara explícitamente la política producto+alta: esa prioridad es una decisión del laboratorio, no una verdad universal. Un prompt que pide JSON no garantiza el esquema. Usa salida estructurada compatible y valida el resultado en tu servicio. Caracteres no son tokens: recoge usage del proveedor o su contador/tokenizador compatible; reserva presupuesto para instrucciones, ejemplos, respuesta y, según modelo, razonamiento. No todos los modelos aceptan los mismos parámetros de temperatura.
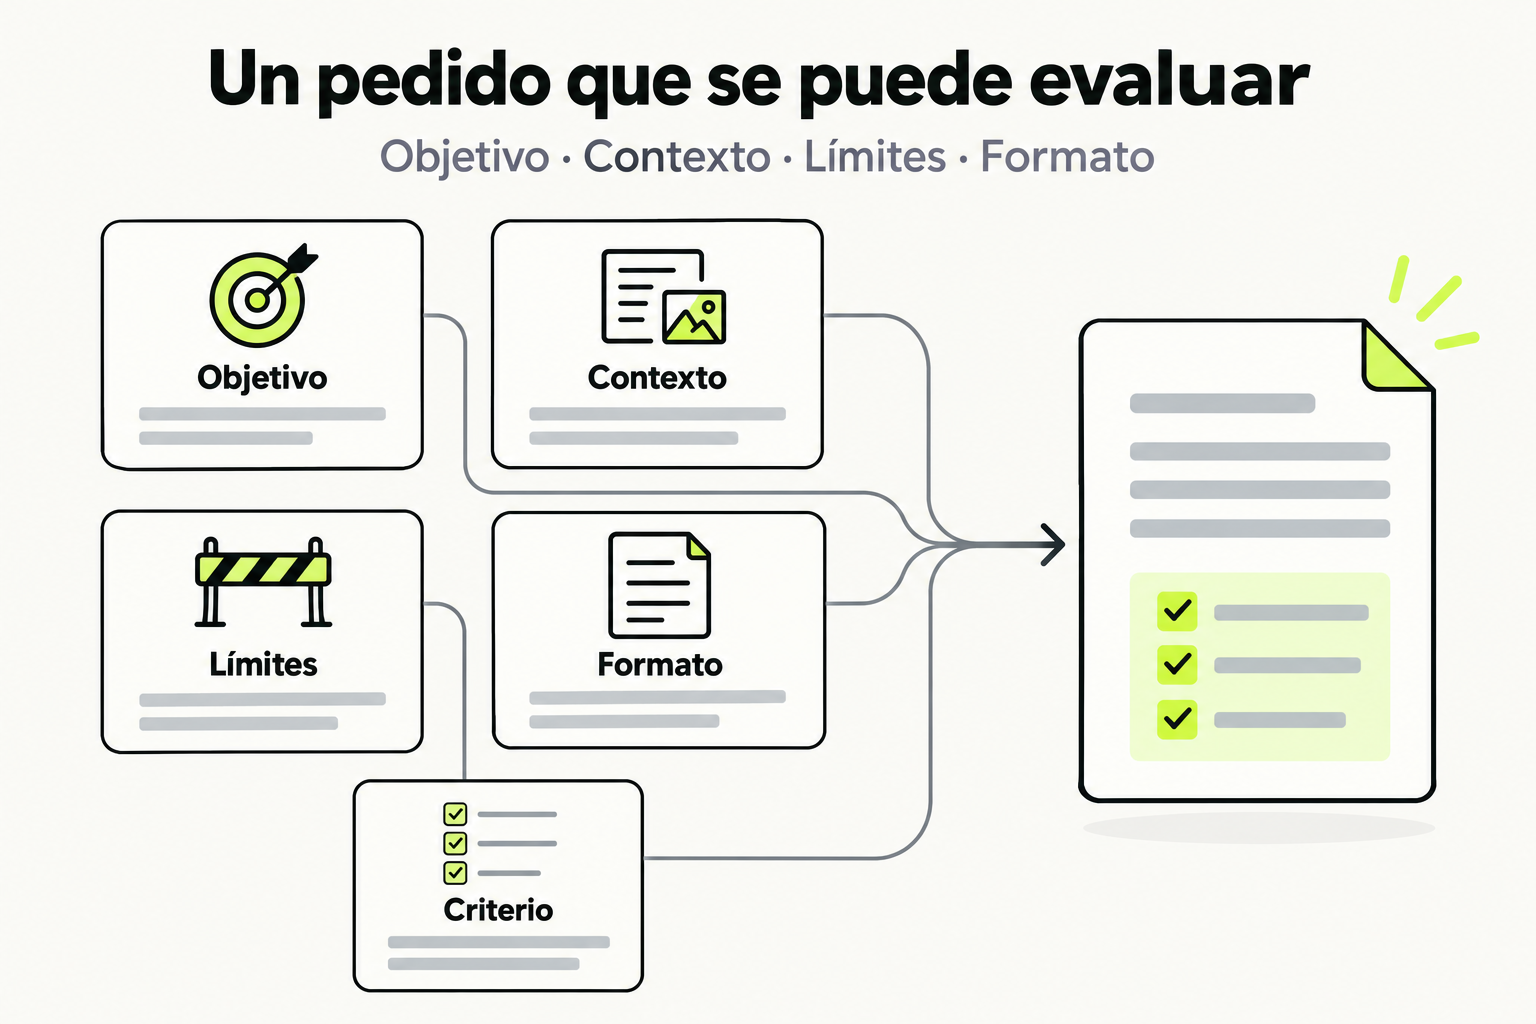
 Mapa de práctica
Un pedido útil explica qué resultado se busca y aporta el contexto necesario. Los límites y el formato reducen ambigüedades. Un criterio observable permite revisar el resultado y pedir un ajuste concreto.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Concepto clave
Un prompt efectivo es como una especificacion de trabajo para un asistente humano experto. No solo pides algo, sino que defines claramente el contexto, las restricciones y el formato esperado. En APIs como GPT y Claude, esto se traduce en tres componentes fundamentales: tokens (las unidades basicas de texto que procesa el modelo), contexto (la informacion que proporcionas para guiar la respuesta) y parametros (configuraciones tecnicas como temperatura o max_tokens).
Imagina que necesitas que un arquitecto diseñe una casa. Si solo dices "diseña una casa", obtendras algo generico. Pero si especificas: "Diseña una casa moderna de 3 habitaciones para una familia con dos niños, con espacio de oficina, usando materiales sostenibles, y entregame los planos en formato CAD", el resultado sera preciso y util. Los tokens son cada palabra de tu solicitud, el contexto es la descripcion detallada, y los parametros serian equivalentes a decir "entregalo en 48 horas" (un limite de tiempo).
Como funciona en la practica
Vamos a crear un prompt para una API que genera codigo. Primero, identificamos los elementos:
- Tokens: Cada palabra, numero o simbolo cuenta. Un prompt largo consume mas tokens, lo que puede afectar costos y limites de la API.
- Contexto: Proporcionamos informacion especifica sobre lo que queremos. Por ejemplo, el lenguaje de programacion, el framework, y los requisitos funcionales.
- Parametros: Configuramos opciones como temperature (controla la creatividad, donde 0.0 es determinista y 1.0 es muy creativo) y max_tokens (limita la longitud de la respuesta).
Ejemplo paso a paso:
- Objetivo: Generar una funcion en Python que valide emails.
- Contexto inicial: "Escribe una funcion en Python que valide direcciones de email usando expresiones regulares."
- Mejora con contexto: Agregamos detalles como "La funcion debe llamarse validar_email, aceptar un string como argumento, devolver True o False, y manejar casos comunes como dominios .com, .org, .net."
- Parametros: Configuramos temperature=0.2 para respuestas consistentes y max_tokens=200 para respuestas concisas.
Codigo en accion
Aqui hay un ejemplo funcional usando la API de OpenAI (GPT) en Python. Primero, un prompt basico que puede dar resultados inconsistentes:
import openai

openai.api_key = 'tu_api_key_aqui'

response = openai.ChatCompletion.create(
    model="gpt-3.5-turbo",
    messages=[
        {"role": "user", "content": "Escribe una funcion para validar emails"}
    ]
)
print(response.choices[0].message.content)
Ahora, un prompt mejorado con contexto claro y parametros optimizados:
import openai

openai.api_key = 'tu_api_key_aqui'

response = openai.ChatCompletion.create(
    model="gpt-3.5-turbo",
    messages=[
        {"role": "system", "content": "Eres un asistente de programacion especializado en Python."},
        {"role": "user", "content": "Escribe una funcion en Python llamada validar_email que tome un string como argumento y devuelva True si es una direccion de email valida o False en caso contrario. Usa expresiones regulares para validar formatos comunes como usuario@dominio.com, .org, .net. Incluye comentarios en el codigo."}
    ],
    temperature=0.2,
    max_tokens=200
)
print(response.choices[0].message.content)
Errores comunes
- Contexto insuficiente: No proporcionar detalles especificos lleva a respuestas vagas. Solucion: Siempre incluye el rol (ej., "Eres un experto en X"), el formato esperado y ejemplos si es necesario.
- Ignorar los limites de tokens Un prompt muy largo puede exceder los limites de la API o aumentar costos innecesariamente. Solucion: Se conciso, usa resumenes para contexto extenso y ajusta max_tokens segun lo necesario.
- Parametros mal configurados: Usar temperature alta (ej., 0.9) para tareas que requieren precision, como generacion de codigo, resulta en respuestas inconsistentes. Solucion: Usa temperature baja (0.0 a 0.3) para tareas deterministicas y alta para creativas.
- No estructurar el prompt: Enviar todo en un solo mensaje sin separar instrucciones de contexto. Solucion: Usa el rol "system" para contexto y "user" para instrucciones especificas en APIs como GPT.
- Olvidar el formato de salida: No especificar como quieres la respuesta (ej., en JSON, como lista, etc.). Solucion: Incluye instrucciones claras como "Devuelve el resultado en formato JSON con claves 'email' y 'valido'."
Checklist de dominio
- Defino claramente el rol del asistente (ej., "Eres un desarrollador senior") en el contexto.
- Especifico el formato de entrada y salida esperado en el prompt.
- Ajusto los parametros temperature y max_tokens segun la tarea (baja temperatura para precision, alta para creatividad).
- Verifico que el prompt no exceda los limites de tokens de la API (ej., 4096 tokens para GPT-3.5-turbo).
- Incluyo ejemplos o restricciones para reducir ambiguedades.
- Uso mensajes estructurados (system/user/assistant) cuando la API lo soporta.
- Pruebo el prompt con diferentes entradas para asegurar consistencia.
Refactorizacion de un prompt para una API de generacion de contenido
En este ejercicio, practicaras la mejora de un prompt basico para hacerlo mas efectivo usando tokens, contexto y parametros. Sigue estos pasos:
- Analiza el prompt inicial: Lee el siguiente prompt diseñado para generar descripciones de productos: "Escribe una descripcion para un producto." Identifica que le falta: contexto especifico, parametros y estructura.
- Amplia el contexto: Modifica el prompt para incluir detalles como: tipo de producto (ej., smartphone), audiencia objetivo (ej., profesionales), tono (ej., formal), y elementos clave a mencionar (ej., bateria, camara). Usa un rol como "Eres un copywriter experto en tecnologia."
- Ajusta los parametros: Configura parametros apropiados para la API. Por ejemplo, usa temperature=0.5 para un balance entre creatividad y consistencia, y max_tokens=150 para una descripcion concisa.
- Estructura el prompt: Organiza el prompt usando mensajes si es posible (ej., system para contexto, user para instrucciones). Asegurate de especificar el formato de salida, como "Devuelve la descripcion en un parrafo de 3-4 oraciones."
- Prueba y compara: Si tienes acceso a una API como GPT o Claude, prueba ambos prompts (el inicial y el mejorado) y compara los resultados. Nota como la version mejorada produce contenido mas util y especifico.
Pistas
- Piensa en los detalles que un copywriter necesitaria para escribir una descripcion efectiva, como caracteristicas del producto y audiencia.
- Recuerda que los parametros como temperature afectan la variabilidad de las respuestas; ajustalos segun si quieres descripciones creativas o estandar.
- Usa ejemplos en el prompt si es necesario, como "Ejemplo de tono: 'Este smartphone ofrece...'" para guiar mejor al modelo.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prompt Engineering Avanzado para APIs de GPT y Claude: Desarrollo de Sistemas Inteligentes
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.