

Lección 4 de 17 · Lectura y práctica
Quiz: Evaluación de Conceptos de Schemas
Tipo de lección: QuizConcepto claveEl schema en Prisma es el corazon de tu aplicacion. Define la estructura de tu base de datos, las relaciones entre entidades y las reglas de validacion. Piensalo como el plano arquitectonico de.
Del concepto a la práctica
Taller de esta lección
Este repaso evalúa decisiones, no solo nombres de atributos. Una respuesta sólida distingue una clave única, una relación y una regla que debe validarse antes de persistir. Usa un caso de publicaciones: un autor puede tener muchos artículos, pero cada artículo tiene un solo autor obligatorio.
Ejemplo resuelto
Si email identifica a una cuenta, @unique evita duplicados. Si Post.authorId apunta a User.id, la relación evita autores inexistentes. Si el título no puede estar vacío, la validación de entrada debe rechazar una cadena vacía antes de crear el registro.
La base compara email según tipo/collation y no normaliza automáticamente espacios o mayúsculas: define una política de email antes de crear el índice único. Estos dos emails idénticos colisionan inequívocamente. createdAt ordenable corresponde al tipo/date+orderBy, no a una garantía de unicidad; para paginar añade id como desempate y un índice por autor/fecha cuando esté justificado.
Pruébalo
Clasifica cada regla como unicidad, relación o validación de entrada.
Explica qué registro impediría cada restricción.
Elige un índice para listar artículos por autor y fecha.
Calcula qué filas son válidas con los datos dados.
Comprueba tu resultado
Con usuarios u1 y u2, emails a@x.test y a@x.test, solo uno puede persistir; el segundo viola unicidad.
Error frecuente: creer que un índice sustituye una restricción única. Corrígelo usando la declaración adecuada para cada propósito.
Ejercicio: clasifica email único, authorId existente, title no vacío y createdAt ordenable; el resultado esperado es una categoría correcta para cada regla.
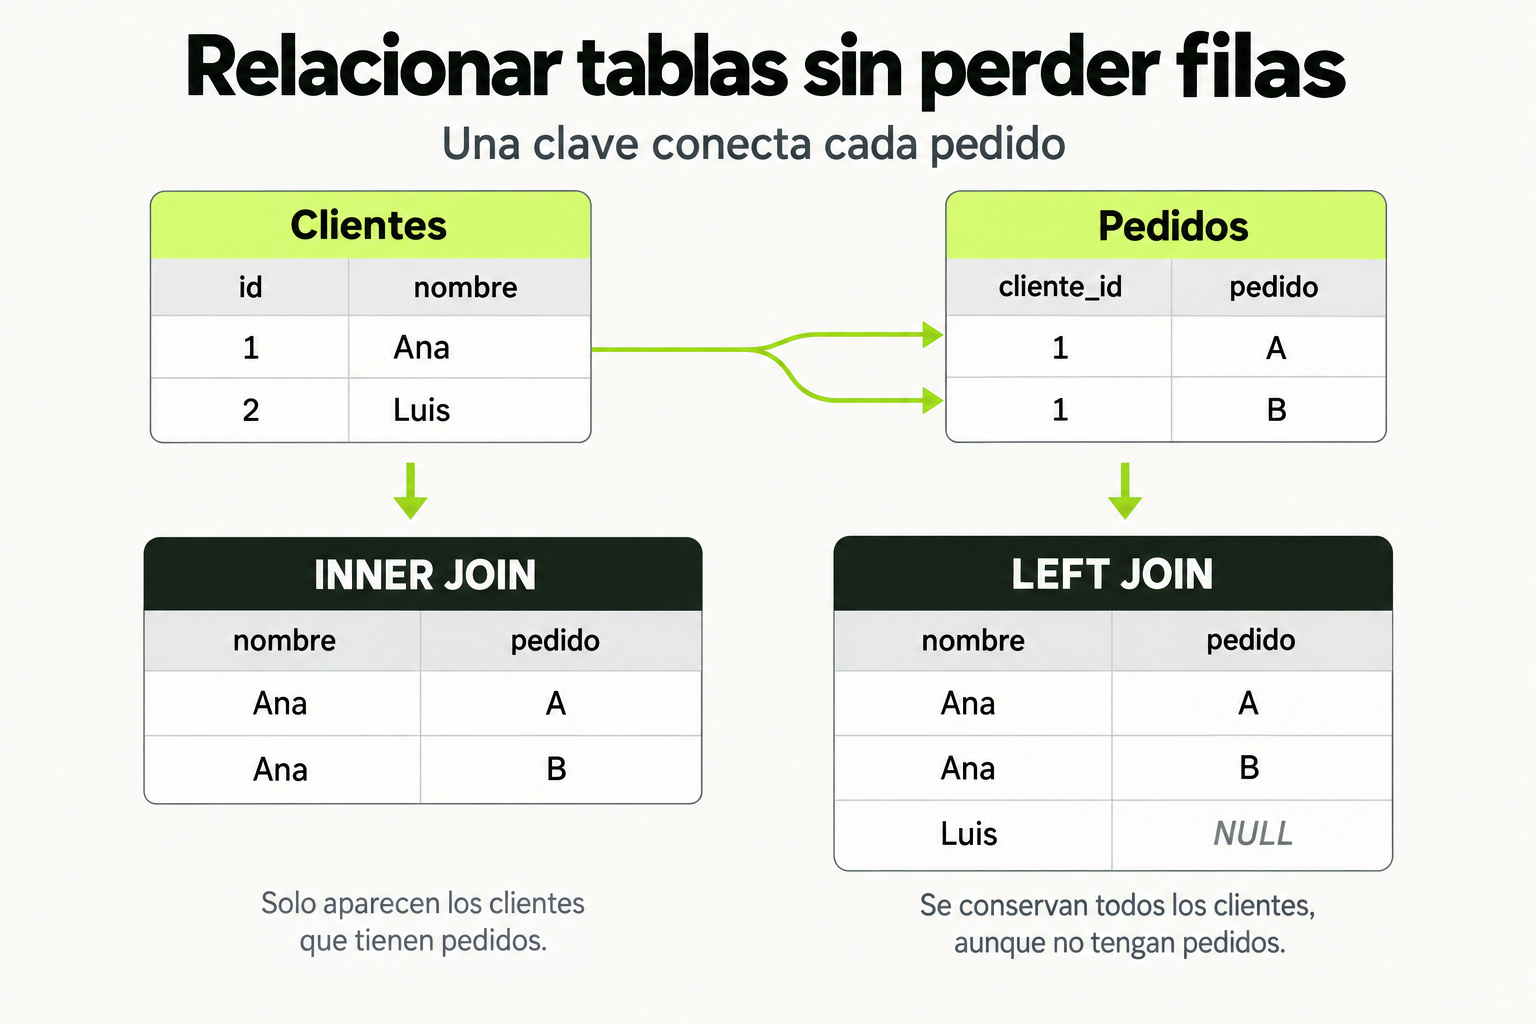
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Tipo de lección: Quiz
Concepto clave
El schema en Prisma es el corazon de tu aplicacion. Define la estructura de tu base de datos, las relaciones entre entidades y las reglas de validacion. Piensalo como el plano arquitectonico de un edificio: si el plano esta mal disenado, el edificio tendra problemas estructurales. En produccion, un schema bien disenado no solo garantiza la integridad de los datos, sino que tambien optimiza el rendimiento de las queries.
Un schema profesional va mas alla de definir tablas y columnas. Debe considerar: escalabilidad (como crecera tu aplicacion en 2 anos), normalizacion (evitar datos duplicados), y relaciones (uno-a-uno, uno-a-muchos, muchos-a-muchos). Por ejemplo, en una aplicacion de e-commerce, un schema mal disenado podria permitir que un producto tenga multiples precios simultaneos, causando errores en facturacion.
Como funciona en la practica
Vamos a disenar un schema para un sistema de blog con usuarios, posts y comentarios. Primero, identificamos las entidades: User, Post, Comment. Luego, definimos las relaciones: un User puede tener muchos Posts (uno-a-muchos), un Post puede tener muchos Comments (uno-a-muchos), y un Comment pertenece a un User (muchos-a-uno).
Paso 1: Creamos el archivo schema.prisma. Paso 2: Definimos cada modelo con sus campos y tipos. Paso 3: Especificamos las relaciones usando @relation. Paso 4: Aplicamos migraciones con prisma migrate dev. Este proceso transforma nuestro schema en tablas reales en la base de datos.
Codigo en accion
Schema inicial basico (antes de optimizar):
model User {
  id        Int      @id @default(autoincrement())
  email     String   @unique
  name      String?
  posts     Post[]
  comments  Comment[]
}

model Post {
  id        Int      @id @default(autoincrement())
  title     String
  content   String?
  authorId  Int
  author    User     @relation(fields: [authorId], references: [id])
  comments  Comment[]
}

model Comment {
  id        Int      @id @default(autoincrement())
  text      String
  postId    Int
  post      Post     @relation(fields: [postId], references: [id])
  userId    Int
  user      User     @relation(fields: [userId], references: [id])
}
Schema optimizado para produccion (despues de refactorizar):
model User {
  id        String   @id @default(cuid())
  email     String   @unique
  name      String?
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt
  posts     Post[]
  comments  Comment[]
  @@map("users")
}

model Post {
  id        String   @id @default(cuid())
  title     String   @db.VarChar(255)
  content   String?  @db.Text
  published Boolean  @default(false)
  authorId  String
  author    User     @relation(fields: [authorId], references: [id], onDelete: Cascade)
  comments  Comment[]
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt
  @@map("posts")
  @@index([authorId])
}

model Comment {
  id        String   @id @default(cuid())
  text      String   @db.VarChar(500)
  postId    String
  post      Post     @relation(fields: [postId], references: [id], onDelete: Cascade)
  userId    String
  user      User     @relation(fields: [userId], references: [id])
  createdAt DateTime @default(now())
  @@map("comments")
  @@index([postId])
}
Errores comunes
- No usar tipos de datos apropiados para produccion: Usar
Intpara IDs en lugar deStringcon@default(cuid())puede causar problemas de escalabilidad. Los CUIDs son mas seguros y escalables. - Olvidar timestamps: No incluir
createdAtyupdatedAtdificulta el debugging y auditoria en produccion. - Relaciones sin cascada: No definir
onDeleteoonUpdatepuede dejar datos huerfanos. Por ejemplo, si borras un usuario, sus posts deberian borrarse automaticamente. - Falta de indices: No agregar
@@indexen campos usados frecuentemente en queries (comoauthorIden Post) ralentiza la aplicacion. - Nombres de tabla por defecto: No usar
@@mappara personalizar nombres de tablas puede llevar a conflictos con convenciones de base de datos existentes.
Checklist de dominio
- ¿Usas CUIDs o UUIDs para IDs en lugar de autoincrementales?
- ¿Incluyes timestamps (
createdAt,updatedAt) en todos tus modelos? - ¿Defines acciones de cascada (
onDelete,onUpdate) en relaciones criticas? - ¿Agregas indices a campos usados en filtros, ordenamientos o joins frecuentes?
- ¿Personalizas nombres de tablas con
@@mappara seguir convenciones de tu equipo? - ¿Usas tipos de base de datos especificos (ej.
@db.VarChar(255)) para controlar el almacenamiento? - ¿Validas que las relaciones reflejen correctamente la logica de negocio (ej. un Comment debe tener un User)?
Refactoriza un Schema de E-commerce para Produccion
Te dan un schema basico para una tienda online. Tu tarea es optimizarlo para produccion aplicando las mejores practicas aprendidas.
- Copia el siguiente schema inicial a un archivo
schema.prisma:
model Product {
  id          Int      @id @default(autoincrement())
  name        String
  price       Float
  categoryId  Int
  category    Category @relation(fields: [categoryId], references: [id])
}

model Category {
  id          Int      @id @default(autoincrement())
  name        String
  products    Product[]
}

model Order {
  id          Int      @id @default(autoincrement())
  userId      Int
  user        User     @relation(fields: [userId], references: [id])
  total       Float
}

model User {
  id          Int      @id @default(autoincrement())
  email       String
  orders      Order[]
}- Refactoriza el schema para hacerlo listo para produccion. Considera: cambiar IDs a CUIDs, agregar timestamps, definir cascadas, agregar indices, y usar tipos de base de datos especificos.
- Ejecuta
prisma migrate dev --name refactor_schemapara aplicar los cambios (simulado, no necesitas base de datos real). - Verifica que tu schema final no tenga errores comunes listados en la leccion.
Pistas
- Piensa en que campos son frecuentemente filtrados (ej. categoryId en Product) para agregar indices.
- Usa @db.Decimal para price en lugar de Float para precision monetaria.
- Agrega un campo status en Order para manejar estados como 'pending', 'shipped'.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Prisma ORM Profesional: Schemas, Migraciones y Queries Optimizadas para Producción
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.