

Lección 7 de 25 · Lectura y práctica
Optimización de Joins y Subqueries
Tipo de lección: VideoConcepto claveEn aplicaciones de alta concurrencia, los joins y subqueries mal optimizados son como cuellos de botella en una autopista: cada consulta lenta bloquea recursos y afecta a miles de usuarios.
Del concepto a la práctica
Taller de esta lección
La forma de una subquery influye en cuántas veces se repite el trabajo. Una subquery correlacionada puede evaluarse para cada fila candidata, mientras que EXISTS expresa una prueba de existencia y permite detenerse al hallar coincidencia. La equivalencia debe verificarse con datos que incluyan clientes sin pedidos y pedidos duplicados.
Ejemplo resuelto
Para obtener clientes con al menos un pedido enviado, se usa EXISTS en lugar de unir y aplicar DISTINCT:
SELECT c.id
FROM clientes c
WHERE EXISTS (
  SELECT 1 FROM pedidos p
  WHERE p.cliente_id = c.id AND p.estado = 'enviado'
);
Define la semántica: una fila por cliente.
Incluye clientes con cero, uno y varios pedidos.
Ejecuta la consulta original y la reescrita.
Compara conjuntos y planes.
Error frecuente: reemplazar un JOIN por EXISTS cuando se necesitan columnas del pedido. Corrección: conserva el join o separa la existencia de la proyección.
Datos completos: clientes(1,Ana),(2,Bruno),(3,Carla); pedidos(11,cliente1,enviado),(12,cliente1,enviado),(13,cliente2,cancelado). Añade ORDER BY c.id si comparas secuencias, aunque aquí solo sale1. EXISTS permite una estrategia semijoin, pero el planificador puede transformar ambas expresiones y no garantiza que una siempre sea más rápida; verifica semántica y plan en el mismo fixture.
Pruébalo
Usa clientes 1, 2 y 3; asigna dos pedidos enviados al 1 y uno cancelado al 2.
Comprueba tu resultado
La salida debe contener solo 1, una vez, demostrando que no se multiplican filas.
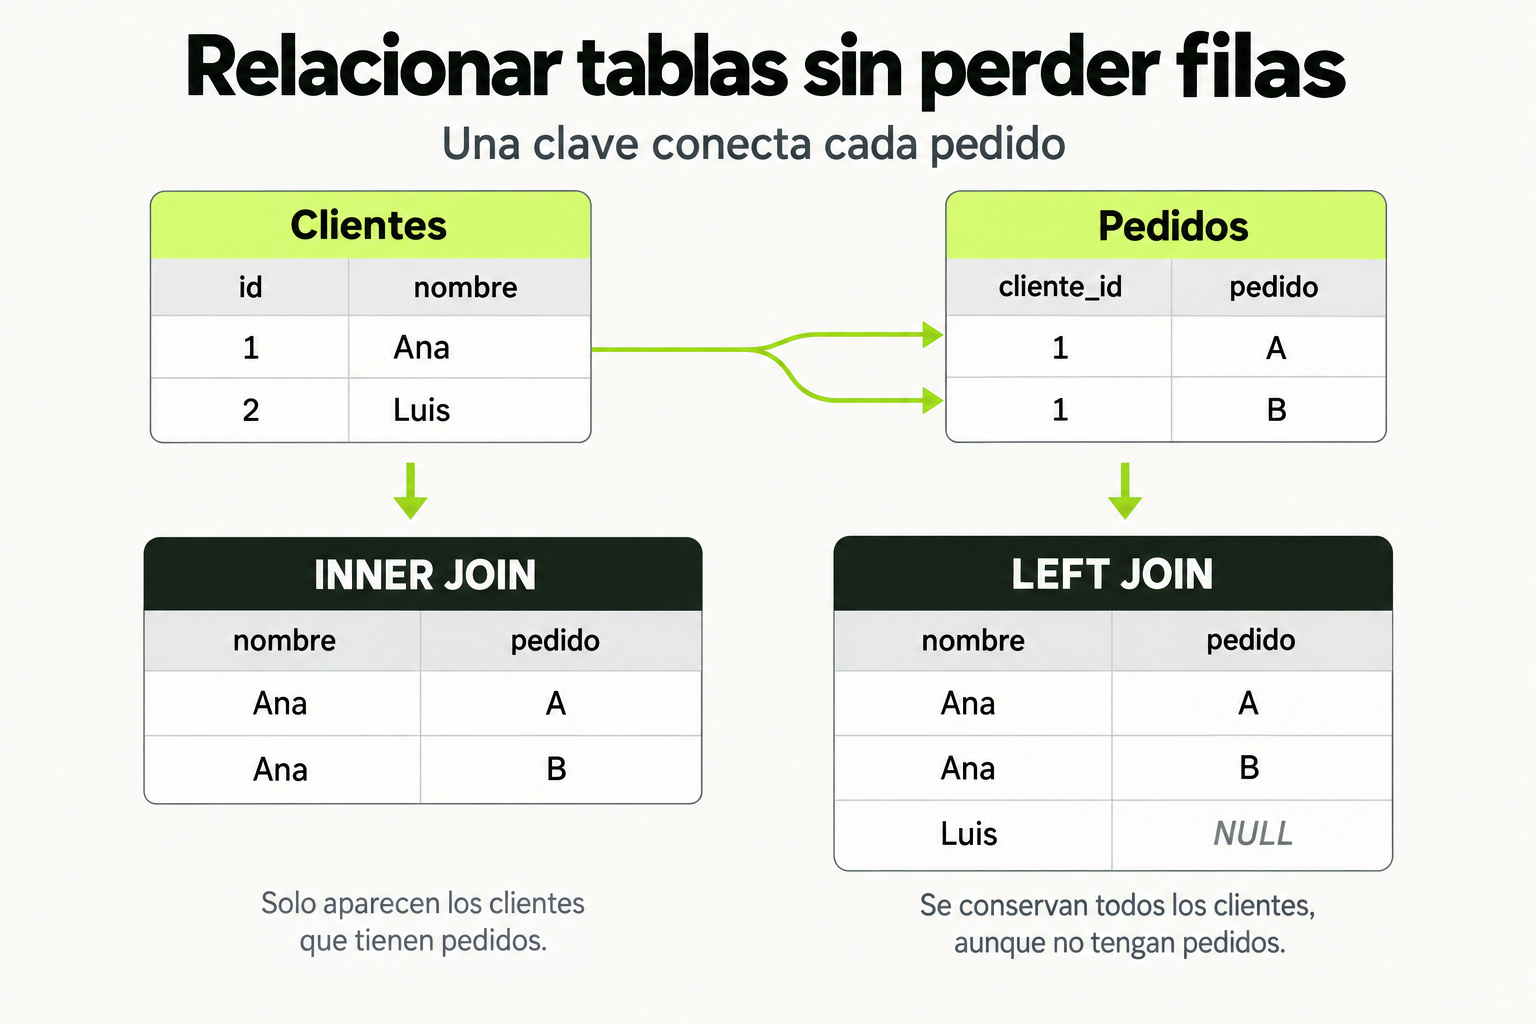
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Tipo de lección: Video
Concepto clave
En aplicaciones de alta concurrencia, los joins y subqueries mal optimizados son como cuellos de botella en una autopista: cada consulta lenta bloquea recursos y afecta a miles de usuarios simultáneos. PostgreSQL ofrece múltiples estrategias de ejecución, pero elegir la correcta requiere entender cómo el motor procesa los datos internamente.
Imagina que tienes dos tablas: pedidos (con millones de registros) y clientes (con miles). Un join simple entre ambas puede generar un producto cartesiano temporal enorme si no está bien indexado, consumiendo memoria y CPU. Las subqueries, por otro lado, pueden ejecutarse una vez por fila (correlacionadas) o una sola vez (no correlacionadas), impactando drásticamente el rendimiento.
Cómo funciona en la práctica
PostgreSQL evalúa los joins usando algoritmos como Nested Loop, Hash Join y Merge Join. Para decidir, el planificador analiza estadísticas, índices y tamaños de tabla. Por ejemplo, un Nested Loop es eficiente para tablas pequeñas, mientras que un Hash Join escala mejor con grandes volúmenes si hay memoria suficiente.
Paso a paso: al ejecutar SELECT * FROM pedidos JOIN clientes ON pedidos.cliente_id = clientes.id, PostgreSQL: 1) Analiza las cláusulas WHERE y JOIN, 2) Consulta las estadísticas de las tablas, 3) Elige un algoritmo basado en costos estimados, 4) Ejecuta y devuelve resultados. Si falta un índice en cliente_id, podría forzar un escaneo secuencial costoso.
Código en acción
Antes: Subquery correlacionada ineficiente (ejecutada por cada fila):
-- Lento en alta concurrencia
SELECT nombre,
       (SELECT COUNT(*) FROM pedidos WHERE pedidos.cliente_id = clientes.id) AS total_pedidos
FROM clientes
WHERE ciudad = 'Madrid';
Después: Refactorizado a join con agregación (ejecutado una vez):
-- Optimizado para concurrencia
SELECT c.nombre, COUNT(p.id) AS total_pedidos
FROM clientes c
LEFT JOIN pedidos p ON c.id = p.cliente_id
WHERE c.ciudad = 'Madrid'
GROUP BY c.id, c.nombre;
Errores comunes
- Usar subqueries correlacionadas en bucles grandes: Ejecutan N veces, agotando recursos. Solución: Convertir a joins o usar CTEs.
- Olvidar índices en columnas de join: Sin ellos, PostgreSQL recurre a escaneos secuenciales. Crea índices B-tree en claves foráneas.
- Ignorar el tipo de join: INNER JOIN vs LEFT JOIN afecta el plan de ejecución. Usa EXPLAIN ANALYZE para comparar.
- Sobrecargar CTEs (WITH clauses): En PostgreSQL < 12, se materializan como tablas temporales, añadiendo sobrecarga. Evalúa si necesitas materialización.
- No actualizar estadísticas: Con tablas muy dinámicas, el planificador toma decisiones erróneas. Ejecuta
ANALYZE tabla;periódicamente.
Checklist de dominio
- ¿Usas EXPLAIN ANALYZE para ver planes de ejecución reales?
- ¿Tienes índices en todas las columnas involucradas en joins y WHERE?
- ¿Convertiste subqueries correlacionadas a joins cuando es posible?
- ¿Probaste diferentes tipos de join (INNER, LEFT) para optimizar?
- ¿Monitorizas el uso de memoria en operaciones de hash join?
- ¿Actualizas estadísticas con ANALYZE tras cambios masivos?
- ¿Consideras particionamiento para joins en tablas gigantes?
Optimización de un reporte de ventas con joins complejos
En una base de datos de e-commerce, tienes las tablas: orders (id, user_id, amount, created_at), users (id, country, signup_date), y order_items (id, order_id, product_id, quantity). El reporte actual es lento bajo alta concurrencia.
- Analiza la consulta original:
SELECT u.country, SUM(o.amount) FROM users u JOIN orders o ON u.id = o.user_id WHERE o.created_at >= '2023-01-01' GROUP BY u.country; - Usa EXPLAIN ANALYZE para identificar cuellos de botella (ejecuta en un entorno de prueba).
- Refactoriza: Añade índices necesarios, considera reescribir con subqueries o CTEs si mejora el rendimiento.
- Prueba con datos simulados (ej., 1M de órdenes) y mide el tiempo antes/después.
- Documenta los cambios y el impacto en un README breve.
Pistas
- Revisa si los índices en user_id y created_at están presentes y son usados.
- Considera si un índice compuesto en (user_id, created_at) podría ayudar.
- Prueba a pre-filtrar orders con una subquery antes del join para reducir datos.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.