

Lección 6 de 25 · Lectura y práctica
Estrategias para Queries Concurrentes
Concepto claveEn aplicaciones de alta concurrencia, múltiples usuarios ejecutan queries simultáneamente sobre la misma base de datos. PostgreSQL maneja esto mediante MVCC (Multi-Version Concurrency Control), que crea versiones de.
Del concepto a la práctica
Taller de esta lección
Una query concurrente debe reducir tanto el trabajo como el tiempo durante el que retiene recursos. READ COMMITTED toma un snapshot por sentencia, mientras que una transacción más larga puede conservar decisiones y locks durante más tiempo. La elección depende de la invariancia requerida: no se debe usar SERIALIZABLE como acelerador, sino cuando la aplicación necesita detectar y reintentar anomalías de serialización.
Ejemplo resuelto
Para reclamar una tarea pendiente, dos trabajadores ejecutan una selección con FOR UPDATE SKIP LOCKED, ordenan por id y actualizan solo la fila obtenida. El trabajador segundo salta la fila retenida y toma la siguiente, evitando una cola innecesaria.
Selecciona una tarea en una transacción breve.
Bloquea solo la fila elegida.
Cambia su estado y confirma.
Reintenta únicamente errores transitorios documentados.
Error frecuente: usar SKIP LOCKED cuando ninguna tarea puede omitirse. Corrección: reserva la técnica para colas donde el orden o la espera sean tolerables.
Fixture: tareas1,2,3 con estado pendiente. A reclama1 y conserva la transacción; B reclama2 y confirma. Una forma atómica es:
WITH elegida AS (
  SELECT id FROM tareas WHERE estado='pendiente'
  ORDER BY id FOR UPDATE SKIP LOCKED LIMIT 1
)
UPDATE tareas t SET estado='procesando'
FROM elegida e WHERE t.id=e.id RETURNING t.id;
El orden pertenece al SELECT, pero SKIP LOCKED puede saltar trabajo temporalmente; no ofrece fairness absoluto. Comprobar locks sin actualizar/confirmar la reclamación permitiría recoger la misma tarea después. Estados procesando necesitan recuperación de un worker que muere, con lease/timeout e idempotencia del trabajo.
Pruébalo
Carga tres tareas, bloquea la primera en una sesión y ejecuta dos trabajadores con el patrón indicado.
Comprueba tu resultado
El primer trabajador toma la tarea 1; mientras siga bloqueada, el siguiente recibe2 en el fixture fijo y una tercera reclamación recibe3 si las anteriores ya están en procesando; no existe garantía general de exactly-once del trabajo ante fallos/reintentos.
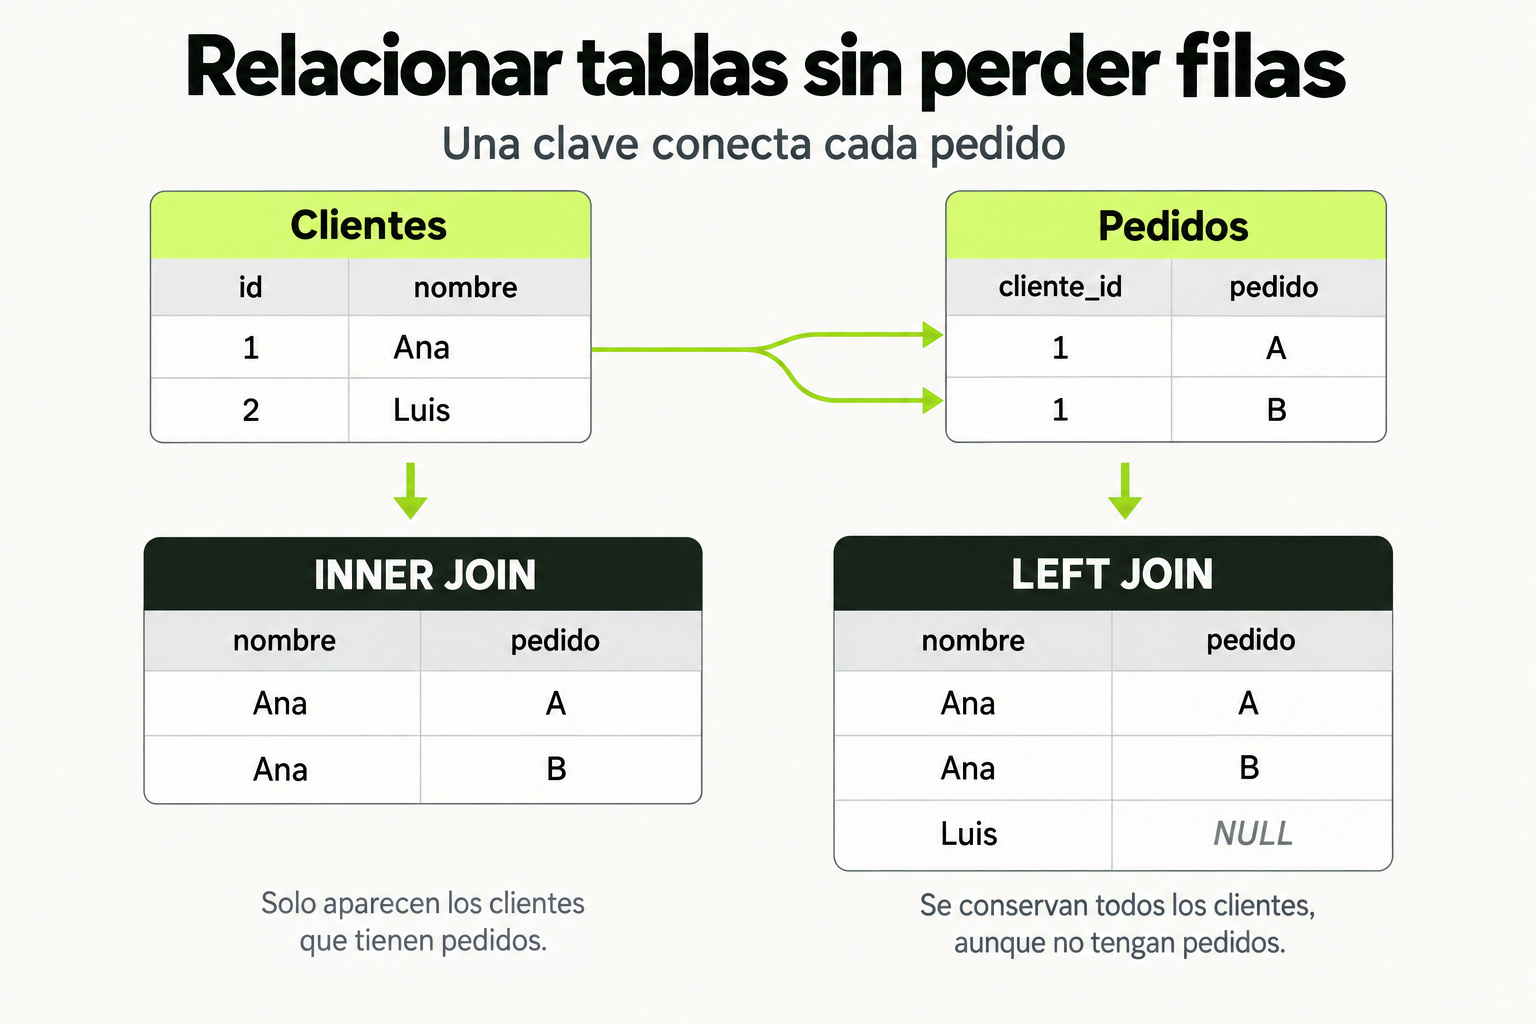
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
En aplicaciones de alta concurrencia, múltiples usuarios ejecutan queries simultáneamente sobre la misma base de datos. PostgreSQL maneja esto mediante MVCC (Multi-Version Concurrency Control), que crea versiones de filas para evitar bloqueos innecesarios. Imagina una biblioteca donde varios lectores pueden consultar el mismo libro sin esperar, pero solo un escritor puede modificarlo a la vez. La clave está en minimizar conflictos entre lecturas y escrituras, optimizando el acceso concurrente para mantener la velocidad y consistencia.
Las estrategias para queries concurrentes se centran en tres pilares: aislamiento de transacciones (niveles como READ COMMITTED o SERIALIZABLE), bloqueos inteligentes (evitando deadlocks) y diseño de queries que reduzcan tiempos de ejecución. Un error común es pensar que más concurrencia siempre es mejor; en realidad, se trata de balancear carga y recursos para evitar cuellos de botella que ralenticen toda la aplicación.
Cómo funciona en la práctica
Supongamos una aplicación de e-commerce con miles de usuarios viendo productos y realizando compras al mismo tiempo. Un query mal optimizado, como una búsqueda compleja en inventario, puede bloquear tablas y hacer que otros usuarios esperen. Paso a paso, primero identificamos queries problemáticos usando herramientas como pg_stat_statements. Luego, aplicamos técnicas como:
- Usar índices adecuados para acelerar lecturas.
- Reducir tiempos de transacción con COMMIT rápido.
- Implementar particionamiento para distribuir carga.
- Ajustar parámetros como max_connections y work_mem según la concurrencia esperada.
Por ejemplo, en lugar de un query que escanea toda una tabla de órdenes, creamos un índice en la columna user_id y usamos cláusulas WHERE específicas para limitar los datos procesados, liberando recursos para otros queries.
Codigo en accion
Antes: Un query lento que bloquea recursos debido a falta de índices y transacción larga.
-- Transacción que puede causar bloqueos
BEGIN;
UPDATE inventario SET cantidad = cantidad - 1 WHERE producto_id = 100;
-- Otras operaciones lentas aquí
COMMIT;
Después: Optimizado con índice y transacción más corta.
-- Crear índice para acelerar el UPDATE
CREATE INDEX idx_inventario_producto ON inventario(producto_id);

-- Transacción optimizada
BEGIN;
UPDATE inventario SET cantidad = cantidad - 1 WHERE producto_id = 100;
COMMIT; -- COMMIT inmediato para liberar bloqueos
Errores comunes
- No usar índices en queries frecuentes: Sin índices, PostgreSQL realiza escaneos secuenciales que bloquean tablas más tiempo. Solución: Analizar queries con EXPLAIN y agregar índices en columnas usadas en WHERE y JOIN.
- Transacciones demasiado largas: Mantener transacciones abiertas por mucho tiempo aumenta el riesgo de deadlocks y bloqueos. Solución: Dividir operaciones en transacciones más pequeñas y usar COMMIT rápido.
- Ignorar el nivel de aislamiento Usar SERIALIZABLE cuando no es necesario puede ralentizar la aplicación. Solución: Evaluar requisitos de consistencia y usar READ COMMITTED para mayor concurrencia.
- Sobrecargar max_connections: Configurar demasiadas conexiones simultáneas agota recursos. Solución: Ajustar max_connections según la capacidad del servidor y usar pools de conexiones.
- No monitorear deadlocks: Los deadlocks pueden pasar desapercibidos y degradar el rendimiento. Solución: Habilitar logging de deadlocks en PostgreSQL y revisar logs regularmente.
Checklist de dominio
- ¿Identificaste queries lentos usando pg_stat_statements o EXPLAIN ANALYZE?
- ¿Implementaste índices apropiados para queries concurrentes frecuentes?
- ¿Optimizaste transacciones para que sean cortas y con COMMIT rápido?
- ¿Configuraste niveles de aislamiento (ej., READ COMMITTED) según necesidades de la aplicación?
- ¿Ajustaste parámetros como work_mem y max_connections para la carga esperada?
- ¿Probaste escenarios de alta concurrencia con herramientas como pgbench?
- ¿Estableciste un plan de monitoreo para deadlocks y bloqueos?
Optimización de un Query Concurrente en una Tabla de Usuarios
En este ejercicio, optimizarás un query en una tabla de usuarios para mejorar el rendimiento en alta concurrencia. Sigue estos pasos:
- Crea una tabla de prueba llamada usuarios con al menos 10,000 filas, incluyendo columnas como id, nombre, email, y last_login.
- Simula un query concurrente problemático: Escribe un query que actualice last_login para múltiples usuarios basado en una condición compleja (ej., WHERE nombre LIKE '%a%'), y ejecútalo desde múltiples sesiones simultáneas usando pgbench o scripts.
- Analiza el rendimiento: Usa EXPLAIN ANALYZE para identificar cuellos de botella, como falta de índices o bloqueos.
- Optimiza el query: Aplica estrategias como agregar un índice en la columna nombre, refactorizar la condición WHERE, o acortar la transacción.
- Verifica la mejora: Ejecuta el query optimizado en las mismas condiciones y compara tiempos de ejecución y bloqueos.
Pistas
- Considera usar CREATE INDEX CONCURRENTLY para evitar bloquear la tabla durante la creación.
- Prueba a dividir el UPDATE en lotes más pequeños para reducir el tiempo de bloqueo.
- Revisa el nivel de aislamiento de la transacción; READ COMMITTED suele ser suficiente para este caso.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.