

Lección 2 de 25 · Lectura y práctica
Configuración de Parámetros de Rendimiento
Concepto claveLa configuración de parámetros de rendimiento en PostgreSQL es como ajustar el motor de un coche de carreras para diferentes circuitos. No existe una configuración universal óptima; depende de tu hardware.
Del concepto a la práctica
Taller de esta lección
Los parámetros de rendimiento son decisiones condicionadas por memoria, conexiones y patrón de trabajo. work_mem se aplica a operaciones concretas, no una sola vez por servidor; varias conexiones con varios ordenamientos pueden multiplicar su consumo. Por eso conviene calcular un límite conservador antes de cambiarlo.
Ejemplo resuelto
Un entorno tiene 8 GiB de RAM, 40 conexiones máximas y se permiten como máximo 6 operaciones de memoria simultáneas por conexión. Si se reserva 2 GiB para PostgreSQL compartido y sistema, queda un presupuesto de 6 GiB. Un techo teórico para work_mem sería 6 GiB / (40×6)=25,6 MiB; se elige 16 MiB para margen, no 64 MiB.
Anota RAM y procesos ajenos a PostgreSQL.
Estima conexiones realmente activas, no solo usuarios registrados.
Cuenta operaciones simultáneas plausibles.
Divide el presupuesto y valida bajo carga controlada.
Error frecuente: multiplicar work_mem solo por max_connections. Corrección: incluir operaciones por consulta y dejar margen al sistema.
Estos cálculos son presupuestos simplificados, no límites duros seguros. Hashes pueden multiplicar work_mem por hash_mem_multiplier y workers paralelos añadir consumo; también quedan memoria por backend, caches y otros procesos. Declara esos supuestos y reduce el valor si no caben. 6 GiB son6144 MiB;6144/240=25,6, no26,2. Prueba ajustes SET LOCAL dentro de una transacción del laboratorio antes de cambiar configuración global.
Pruébalo
Con 16 GiB, 60 conexiones y 4 operaciones por conexión, reserva 5 GiB para el resto y calcula un valor prudente inferior al límite matemático.
Comprueba tu resultado
El límite es 11 GiB/240=46,9 MiB; una elección prudente puede ser 32 MiB, explicando el margen.
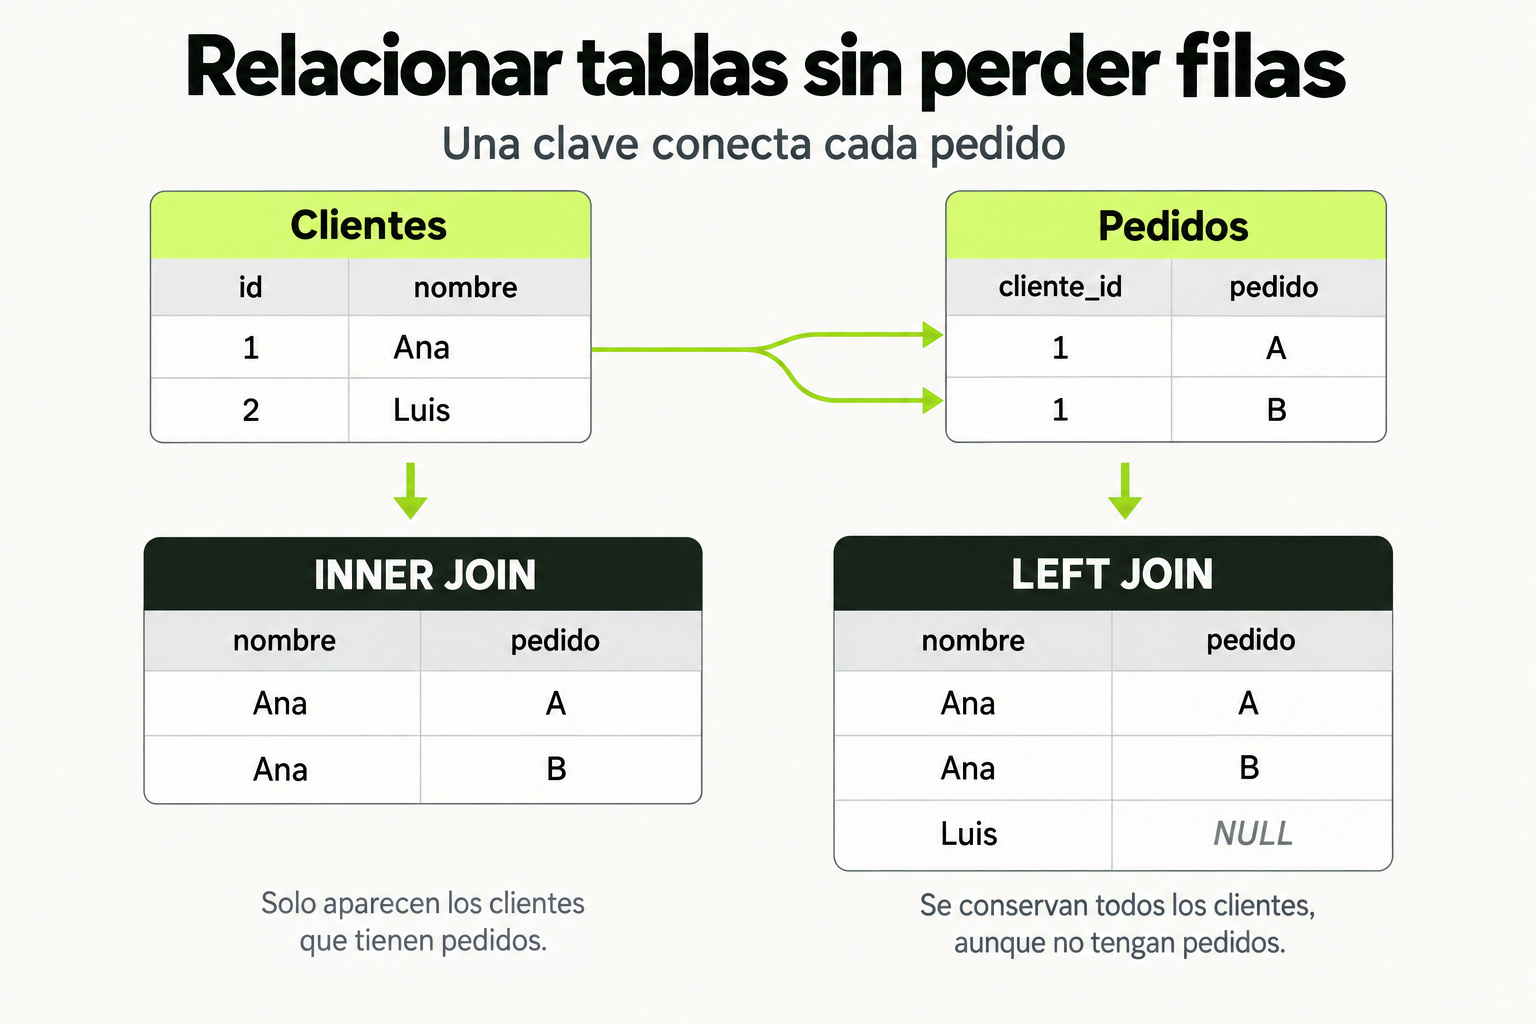
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
La configuración de parámetros de rendimiento en PostgreSQL es como ajustar el motor de un coche de carreras para diferentes circuitos. No existe una configuración universal óptima; depende de tu hardware específico, patrones de carga de trabajo y objetivos de rendimiento. Los parámetros controlan cómo PostgreSQL asigna memoria, gestiona conexiones concurrentes y optimiza la ejecución de consultas.
Para aplicaciones de alta concurrencia, el enfoque debe estar en maximizar el throughput (consultas por segundo) manteniendo una latencia baja y estable. Esto requiere un equilibrio delicado entre recursos compartidos como shared_buffers (caché en memoria) y work_mem (memoria por operación). Un error común es asignar demasiada memoria a un parámetro, dejando insuficiente para el sistema operativo u otros procesos.
Cómo funciona en la práctica
Imagina una aplicación web con 500 usuarios concurrentes ejecutando consultas complejas. Primero, identifica los cuellos de botella usando herramientas como pg_stat_statements. Luego, ajusta parámetros clave paso a paso:
- Configura max_connections basado en tu pool de conexiones (ej: 200 para 500 usuarios con pooling).
- Ajusta shared_buffers al 25% de la RAM del sistema para caché eficiente.
- Establece work_mem considerando operaciones de ordenación y unión por conexión concurrente.
- Optimiza maintenance_work_mem para operaciones de mantenimiento como VACUUM.
Monitorea el rendimiento después de cada cambio usando pg_stat_activity y ajusta según sea necesario.
Código en acción
Configuración básica en postgresql.conf (antes):
# Configuración por defecto (ineficiente para alta concurrencia)
max_connections = 100
shared_buffers = 128MB
work_mem = 4MB
maintenance_work_mem = 64MB
Configuración optimizada (después) para un servidor con 16GB RAM:
# Configuración optimizada
max_connections = 200
shared_buffers = 4GB  # 25% de 16GB
work_mem = 8MB        # Ajustado para ~10 operaciones concurrentes por conexión
maintenance_work_mem = 1GB
# Parámetros adicionales críticos
effective_cache_size = 12GB  # Estimación de caché del sistema
random_page_cost = 1.1       # Para SSDs
Errores comunes
- Configurar shared_buffers demasiado alto: Puede causar swapping si excede la memoria disponible. Limítalo al 40% de RAM como máximo.
- Ignorar effective_cache_size: PostgreSQL usa este valor para estimar costos de planificación. Establécelo al 50-75% de la RAM total.
- Usar work_mem excesivo: En alta concurrencia, work_mem * max_connections puede exceder la RAM. Calcula: (work_mem * operaciones concurrentes estimadas) < RAM disponible.
- No ajustar random_page_cost para SSDs: El valor por defecto (4.0) es para discos mecánicos. Para SSDs, usa 1.1-1.5.
- Olvidar monitorear después de cambios: Los ajustes deben validarse con métricas reales. Usa pg_stat_bgwriter para verificar eficiencia de escritura.
Checklist de dominio
- ¿Has calculado shared_buffers como porcentaje de tu RAM total (15-25%)?
- ¿Has ajustado work_mem considerando la concurrencia máxima esperada?
- ¿Has configurado effective_cache_size para reflejar la caché del sistema operativo?
- ¿Has optimizado random_page_cost para tu tipo de almacenamiento (HDD/SSD)?
- ¿Has establecido límites de conexión realistas con pooling en mente?
- ¿Has probado los cambios con cargas de trabajo simuladas?
- ¿Has documentado la configuración y su justificación?
Optimización de parámetros para un escenario real
En este ejercicio, optimizarás la configuración de PostgreSQL para una aplicación de comercio electrónico con alta concurrencia.
- Escenario: Servidor con 32GB RAM, SSD NVMe, 1000 usuarios concurrentes máximos. La aplicación tiene un pool de conexiones con máximo 150 conexiones activas.
- Tarea 1: Calcula valores óptimos para estos parámetros:
- max_connections
- shared_buffers
- work_mem (asume 5 operaciones de ordenación concurrentes por conexión)
- maintenance_work_mem
- effective_cache_size
- random_page_cost
- Tarea 2: Crea un archivo postgresql.conf con tus valores calculados.
- Tarea 3: Explica brevemente por qué elegiste cada valor, enfocándote en el balance entre concurrencia y recursos.
Pistas
- Considera que el pool de conexiones limita las conexiones simultáneas reales, no uses max_connections = 1000.
- Para work_mem, calcula: (RAM total - shared_buffers - overhead) / (max_connections * operaciones concurrentes).
- effective_cache_size debe ser mayor que shared_buffers pero menor que la RAM total.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.