

Lección 1 de 25 · Lectura y práctica
Arquitectura de PostgreSQL para Alta Concurrencia
Concepto claveLa arquitectura de PostgreSQL para alta concurrencia se basa en un modelo de procesos por conexión y un sistema de control de concurrencia multiversión (MVCC). Imagina una biblioteca donde cada lector (proceso).
Del concepto a la práctica
Taller de esta lección
La conexión de un cliente no es una consulta abstracta: en el modelo habitual de PostgreSQL implica un proceso servidor que mantiene memoria y participa en el snapshot de cada transacción. MVCC permite que una lectura vea una versión válida mientras otra transacción crea una versión nueva. La consecuencia práctica es que una transacción abierta durante mucho tiempo puede conservar versiones antiguas y retrasar su limpieza.
Ejemplo resuelto
Dos sesiones consultan inventario con stock=4. La sesión A actualiza a 3 sin confirmar; B, bajo READ COMMITTED, todavía puede leer 4. Tras el commit de A, una nueva sentencia de B verá 3. La diferencia está en el momento del snapshot, no en una copia permanente.
Abre dos sesiones locales autorizadas.
Inicia una transacción en A y actualiza una fila.
Lee la misma fila desde B antes y después del commit.
Registra qué versión observa cada sentencia.
Error frecuente: afirmar que MVCC elimina todos los bloqueos. Corrección: las escrituras sobre la misma fila aún esperan o se serializan.
Fixture: inventario(id1,stock4); actualiza esa fila en A dentro de BEGIN y consulta por id1 en B. En READ COMMITTED una transacción ociosa después de un SELECT terminado no conserva automáticamente el snapshot de esa sentencia. Para observar retención de una versión vieja, inicia REPEATABLE READ en B y ejecuta SELECT ANTES del UPDATE de A; mantén esa transacción hasta terminar la observación y después ciérrala.
Pruébalo
Repite el escenario con una transacción A que permanece abierta y anota cuándo puede limpiarse la versión anterior.
Comprueba tu resultado
Debes obtener 4 antes del commit y 3 después, además de identificar la transacción abierta como causa de retención.
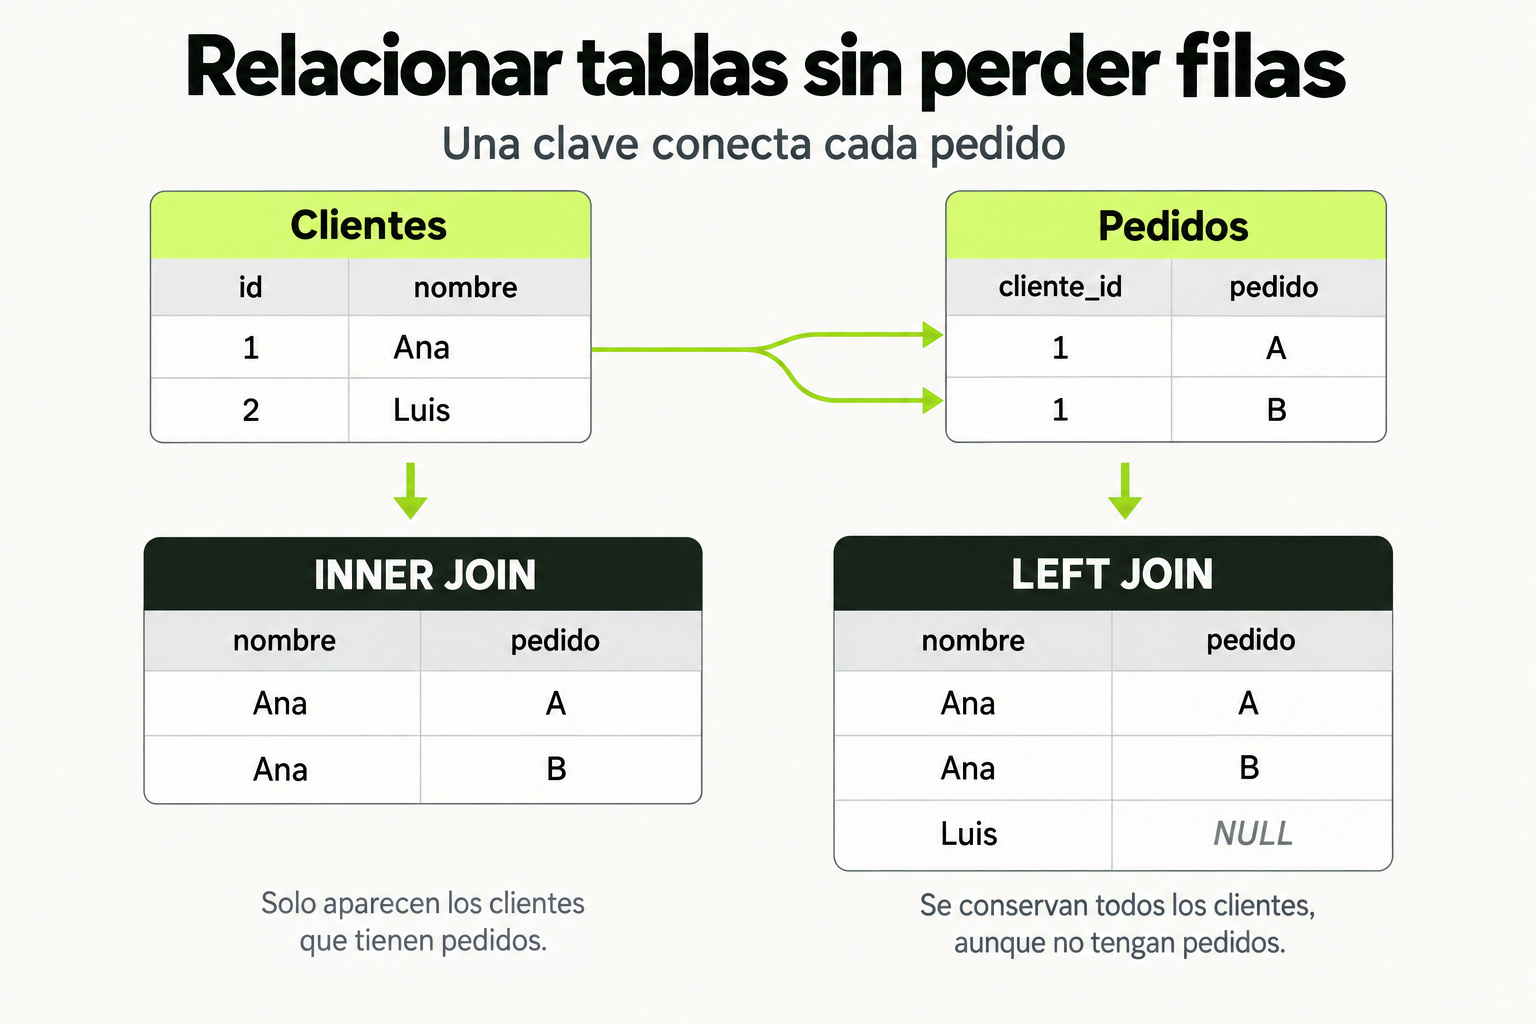
 Mapa de práctica
Una clave conecta cada pedido con su cliente. INNER JOIN devuelve las coincidencias y puede producir varias filas por cliente. LEFT JOIN conserva también los clientes sin pedido y representa los campos ausentes con NULL.
Ver la infografía en tamaño completo ↗Concepto clave
La arquitectura de PostgreSQL para alta concurrencia se basa en un modelo de procesos por conexión y un sistema de control de concurrencia multiversión (MVCC). Imagina una biblioteca donde cada lector (proceso) tiene su propia copia temporal de las páginas que está consultando, permitiendo que múltiples personas lean simultáneamente sin bloquearse, mientras los escritores actualizan copias separadas que se sincronizan cuidadosamente.
PostgreSQL maneja la concurrencia mediante snapshots que capturan el estado de la base de datos en un momento dado, y transacciones que aseguran aislamiento. Esto es crucial para aplicaciones como plataformas de comercio electrónico donde miles de usuarios pueden estar viendo productos y realizando compras al mismo tiempo, sin que las lecturas interfieran con las escrituras.
Cómo funciona en la práctica
Cuando una aplicación con alta concurrencia, como un sistema de reservas de vuelos, ejecuta múltiples transacciones simultáneas, PostgreSQL asigna un proceso separado para cada conexión. Cada transacción ve una versión consistente de los datos gracias al MVCC, que mantiene múltiples versiones de las filas. Por ejemplo, si un usuario está actualizando un asiento mientras otro lo consulta, el segundo verá la versión anterior hasta que la transacción se complete.
Paso a paso: 1) Un cliente se conecta y PostgreSQL crea un nuevo proceso backend. 2) El proceso inicia una transacción y toma un snapshot. 3) Las lecturas acceden a las versiones de filas visibles en ese snapshot. 4) Las escrituras crean nuevas versiones de filas, marcando las antiguas para limpieza posterior. 5) Al commit, los cambios se hacen visibles para nuevas transacciones.
Código en acción
Ejemplo de configuración para alta concurrencia en postgresql.conf:
-- Aumentar el número máximo de conexiones concurrentes
max_connections = 200

-- Ajustar la memoria compartida para manejar más procesos
shared_buffers = 4GB

-- Optimizar el trabajo de autovacuum para mantener el MVCC eficiente
autovacuum_max_workers = 3
autovacuum_vacuum_scale_factor = 0.05

-- Configurar el tiempo de espera para evitar conexiones colgadas
idle_in_transaction_session_timeout = '10min'
Ejemplo de transacción con aislamiento REPEATABLE READ para consistencia:
-- Antes: Lectura inconsistente bajo alta concurrencia
BEGIN;
SELECT asientos_disponibles FROM vuelos WHERE id = 123; -- Podría cambiar antes del UPDATE
UPDATE vuelos SET asientos_disponibles = asientos_disponibles - 1 WHERE id = 123;
COMMIT;

-- Después: Usar REPEATABLE READ para snapshot consistente
BEGIN TRANSACTION ISOLATION LEVEL REPEATABLE READ;
SELECT asientos_disponibles FROM vuelos WHERE id = 123; -- Snapshot fijo
UPDATE vuelos SET asientos_disponibles = asientos_disponibles - 1 WHERE id = 123;
COMMIT;
Errores comunes
- Configurar max_connections demasiado alto: Esto puede agotar la memoria y degradar el rendimiento. En su lugar, usa connection pooling como PgBouncer.
- Ignorar autovacuum: Sin un mantenimiento adecuado, el MVCC acumula versiones muertas, causando bloat y lentitud. Monitoriza con pg_stat_user_tables.
- Usar niveles de aislamiento incorrectos: READ COMMITTED puede causar non-repeatable reads en alta concurrencia. Evalúa si necesitas REPEATABLE READ o SERIALIZABLE.
- No limitar transacciones largas: Las transacciones que duran mucho retienen snapshots y bloquean la limpieza. Configura timeouts como idle_in_transaction_session_timeout.
- Olvidar índices en condiciones WHERE: En alta concurrencia, las consultas sin índices causan sequential scans que bloquean tablas. Usa EXPLAIN ANALYZE para identificar cuellos de botella.
Checklist de dominio
- ¿Has configurado max_connections basado en los recursos del servidor y usado connection pooling?
- ¿Monitorizas regularmente el bloat de tablas y ajustas autovacuum parameters?
- ¿Seleccionas el nivel de aislamiento de transacción apropiado para tu caso de uso?
- ¿Has implementado timeouts para prevenir transacciones colgadas?
- ¿Optimizas índices para consultas concurrentes frecuentes?
- ¿Usas EXPLAIN ANALYZE para analizar el impacto de consultas bajo carga?
- ¿Probaste la configuración con herramientas de estrés como pgbench?
Optimización de una tabla de pedidos para alta concurrencia
En este ejercicio, mejorarás una tabla de pedidos en una aplicación de e-commerce que experimenta picos de 100+ transacciones por segundo.
- Crea una tabla de ejemplo:
CREATE TABLE pedidos ( id SERIAL PRIMARY KEY, usuario_id INT, monto DECIMAL(10,2), estado VARCHAR(20), creado_en TIMESTAMP DEFAULT NOW() ); - Simula alta concurrencia insertando 10,000 filas con pgbench o un script.
- Identifica problemas ejecutando consultas concurrentes de actualización y lectura. Usa:
-- En una sesión BEGIN; UPDATE pedidos SET estado = 'procesado' WHERE id = 1; -- En otra sesión simultánea SELECT * FROM pedidos WHERE id = 1; - Optimiza la tabla:
- Añade índices a usuario_id y estado si son usados en WHERE.
- Ajusta los parámetros de autovacuum para la tabla.
- Cambia el nivel de aislamiento a REPEATABLE READ si es necesario.
- Mide la mejora comparando tiempos de ejecución antes y después.
Pistas
- Usa pg_stat_user_tables para ver n_live_tups y n_dead_tups después de la carga concurrente.
- Considera usar índices parciales si solo ciertos estados son consultados frecuentemente.
- Prueba con pgbench para simular múltiples clientes ejecutando transacciones.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Práctica acompañada: Datos pequeños, preguntas claras
Consultas SQL y control de calidad. Usa este cuaderno como práctica complementaria de la ruta; el material original de la lección continúa siendo tu referencia.
Práctica: modifica una condición
Filtra ahora las ventas del día 2026-09-02. Debes obtener 3 unidades y 2800 centavos. Después agrega otra fila de Papelería: una unidad a 500 centavos. Antes de ejecutar, predice cómo cambiarán el total y el resultado por categoría.
Repite el análisis en una tabla dinámica o con fórmulas de tu hoja de cálculo. Las dos herramientas deben producir el mismo resultado a partir de las mismas filas. Guarda por separado el archivo original y tu variante. Anota también una pregunta que estos datos no permiten responder; por ejemplo, margen de beneficio sin conocer el costo de cada producto.
Comprueba tu entrega
Entrega la consulta, el conjunto de datos y una tabla pequeña con los resultados. Incluye tres controles: número de filas, suma total y comprobación manual de una categoría. Evita gráficos tridimensionales o ejes que oculten la escala.
Sigue con PostgreSQL Avanzado: Optimización para Aplicaciones de Alta Concurrencia
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.