

Lección 2 de 20 · Lectura y práctica
Estructura de Proyectos y Configuración Básica
Concepto claveLa estructura de proyectos en dbt Cloud es el esqueleto organizativo que determina cómo se gestionan tus transformaciones de datos. Imagina que estás construyendo una casa: los archivos de configuración son los.
Del concepto a la práctica
Taller de esta lección
Una estructura útil separa el origen externo de la transformación. models/staging puede limpiar nombres y tipos, mientras models/marts responde preguntas analíticas. La configuración debe reflejar esa intención sin ocultar dónde se materializa cada modelo.
Ejemplo resuelto
Un proyecto llamado tienda_analitica contiene models/staging/stg_orders.sql, models/marts/fct_orders.sql, tests/ y models/schema.yml. En fct_orders.sql, una referencia a stg_orders crea la dependencia; no se copia manualmente el nombre físico de la tabla.
Pruébalo
Dibuja las carpetas y asigna una responsabilidad a cada una.
Escribe un
dbt_project.ymlmínimo con nombre y rutas de modelos.Coloca un modelo de staging y otro final en carpetas distintas.
Ejecuta la validación del proyecto antes de construirlo.
Comprueba tu resultado
Error frecuente: guardar tests dentro de models sin distinguirlos de los archivos SQL. Corrígelo usando tests/ para consultas singulares y schema.yml para configuración documental y tests de columna.
Ejercicio: crea dos modelos, stg_orders y fct_orders, donde el segundo dependa del primero. El resultado esperado es una estructura legible y una única dependencia stg_orders -> fct_orders (flujo de dependencia hacia el consumidor), sin referencias directas repetidas a la tabla cruda.
Un dbt_project.yml de la práctica puede declarar:
name: tienda_analitica
version: "1.0.0"
config-version: 2
model-paths: ["models"]
test-paths: ["tests"]
La conexión se configura aparte. Usa dbt parse para revisar el proyecto y dbt compile para inspeccionar SQL generado; el parse no ejecuta consultas de los modelos.
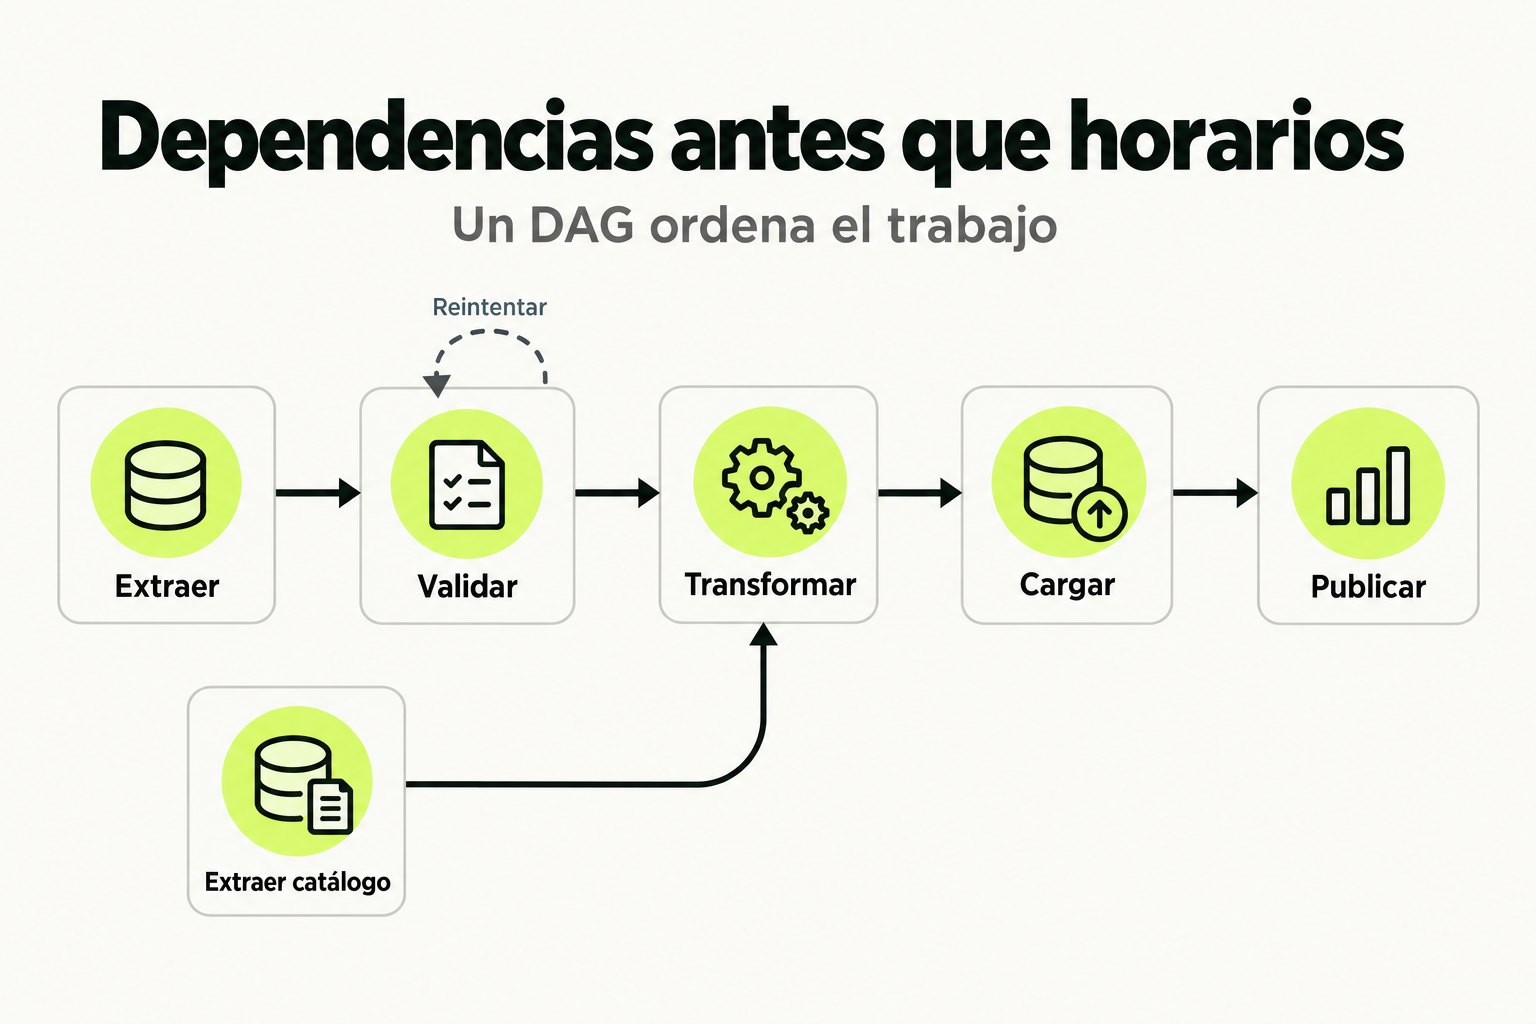
 Mapa de práctica
Un DAG expresa dependencias entre tareas, sin ciclos. Una transformación puede esperar a varias entradas y la publicación debe esperar a que la carga esté lista. El orden depende de los datos necesarios, no solo de una hora del reloj.
Ver la infografía en tamaño completo ↗Concepto clave
La estructura de proyectos en dbt Cloud es el esqueleto organizativo que determina cómo se gestionan tus transformaciones de datos. Imagina que estás construyendo una casa: los archivos de configuración son los planos, los modelos son las habitaciones, y las dependencias entre ellos son las tuberías y cables que conectan todo. Un proyecto bien estructurado te permite escalar de transformaciones simples a pipelines complejos manteniendo la claridad.
En dbt, todo gira alrededor del archivo dbt_project.yml, que actúa como el punto de entrada principal. Este archivo define el nombre de tu proyecto, la versión de dbt, y cómo se organizan los diferentes componentes. La estructura típica incluye carpetas para modelos (transformaciones SQL), tests (validaciones de calidad), documentación (explicaciones de negocio), y macros (funciones reutilizables). La clave está en mantener esta estructura consistente desde el primer día.
Cómo funciona en la práctica
Cuando inicias un proyecto en dbt Cloud, lo primero que haces es configurar tu conexión al data warehouse (como Snowflake, BigQuery o Redshift). Luego, creas la estructura básica de carpetas. Un flujo típico sería:
- Crear el archivo dbt_project.yml con la configuración básica
- Organizar modelos por dominio de negocio (ej: marketing, ventas, finanzas)
- Definir sources.yml para mapear tus tablas fuente
- Configurar profiles.yml para las credenciales de conexión
- Establecer tests básicos para validar datos críticos
Por ejemplo, si estás modelando datos de e-commerce, podrías tener una carpeta 'staging' para limpieza inicial, otra 'marts' para tablas finales de negocio, y dentro de estas, subcarpetas por departamento. Esta organización refleja cómo tu equipo analiza los datos, no solo cómo están almacenados técnicamente.
Codigo en accion
Veamos un ejemplo real de configuración inicial. Primero, el archivo dbt_project.yml básico:
# dbt_project.yml
name: 'ecommerce_analytics'
version: '1.0.0'
config-version: 2

profile: 'ecommerce_profile'

model-paths: ["models"]
test-paths: ["tests"]
analysis-paths: ["analyses"]
macro-paths: ["macros"]
seed-paths: ["data"]

models:
  ecommerce_analytics:
    staging:
      materialized: view
    marts:
      materialized: table
      marketing:
        materialized: incremental
        unique_key: campaign_id
Ahora, un modelo SQL simple en models/staging/stg_orders.sql:
-- models/staging/stg_orders.sql
{{ config(materialized='view') }}

with source as (
    select * from {{ source('raw_data', 'orders') }}
),

transformed as (
    select
        order_id,
        customer_id,
        order_date,
        amount,
        status,
        -- Limpieza y estandarización
        lower(trim(status)) as status_clean,
        amount * 1.16 as amount_with_tax  -- Ejemplo de transformación
    from source
)

select * from transformed
Errores comunes
1. Estructura plana sin organización: Poner todos los modelos en una sola carpeta. Solución: Organizar por capas (staging, intermediate, marts) desde el inicio.
2. Configuración inconsistente entre entornos: Usar diferentes configuraciones en desarrollo vs producción. Solución: Usar variables de entorno y perfiles específicos para cada ambiente.
3. Falta de documentación inicial: Posponer la documentación hasta el final. Solución: Documentar cada modelo con comentarios y un archivo .yml desde el primer commit.
4. Dependencias circulares: Crear referencias que forman ciclos entre modelos. Solución: Usar el comando 'dbt compile' para detectarlas temprano y diseñar un DAG claro.
5. Ignorar los tests básicos: No configurar tests de nulos o unicidad en columnas clave. Solución: Incluir tests mínimos en el schema.yml de cada modelo nuevo.
Checklist de dominio
- ✓ Tengo un dbt_project.yml configurado con nombre, versión y paths definidos
- ✓ Mis modelos están organizados en carpetas lógicas (staging, marts, etc.)
- ✓ Configure correctamente el archivo profiles.yml para mi data warehouse
- ✓ Defini sources.yml para mapear mis tablas fuente originales
- ✓ Establecí al menos un test básico por modelo importante
- ✓ Documenté cada modelo en su correspondiente archivo .yml
- ✓ Verifiqué que no hay dependencias circulares con dbt compile
Configura tu primer proyecto dbt Cloud desde cero
En este ejercicio, configurarás un proyecto dbt Cloud básico para analítica de ventas. Sigue estos pasos:
- Crea un nuevo proyecto en dbt Cloud conectado a tu data warehouse (usa Snowflake, BigQuery o Redshift según tu configuración).
- Configura el archivo dbt_project.yml con:
- Nombre: 'sales_analytics'
- Versión: '1.0.0'
- Define model-paths, test-paths, y macro-paths
- Configura materializaciones: staging como views, marts como tables
- Crea la estructura de carpetas:
- models/staging/
- models/marts/
- tests/
- macros/
- Implementa tu primer modelo: En models/staging/, crea stg_customers.sql que:
- Seleccione de una tabla fuente 'raw_customers'
- Limpie el campo email (trim y lowercase)
- Convierta fecha de registro a formato estándar
- Agrega documentación: Crea models/staging/schema.yml documentando stg_customers con:
- Descripción del modelo
- Descripción de cada columna
- Un test de not_null en customer_id
- Ejecuta dbt run para compilar y verificar que todo funciona.
Pistas
- Recuerda que en dbt_project.yml, la indentación en YAML es crucial. Usa 2 espacios, no tabs.
- Para referenciar una tabla fuente en SQL, usa {{ source('nombre_schema', 'nombre_tabla') }}
- Puedes verificar tu estructura con 'dbt debug' antes de ejecutar el primer run completo.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Modelado de Datos en dbt Cloud: Tests, Documentación y Práctica
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.