

Lección 11 de 16 · Lectura y práctica
Manejo de Datos Desbalanceados y Técnicas de Samplinge
Manejo de Datos Desbalanceados y Técnicas de Samplinge Esta leccion pertenece al curso Machine Learning Práctico con Scikit-Learn y esta pensada para que avances con criterio profesional, no solo con teoria. Primero entiende el.
Del concepto a la práctica
Taller de esta lección
Con clases desbalanceadas, la exactitud puede ocultar que nunca detectas la minoritaria. El muestreo debe ocurrir dentro del entrenamiento de cada pliegue; la evaluación conserva la distribución observada para medir el escenario real.
Ejemplo resuelto
Evaluación: 90 negativos, 10 positivos
Modelo: 85 negativos correctos, 5 positivos correctos
La exactitud es (85+5)/100 = 0,90; el recall positivo es 5/10 = 0,50. Ambas cifras describen aspectos distintos.
Cuenta clases antes de transformar.
Elige recall, precisión o balanced accuracy según el coste.
Aplica sobremuestreo solo al entrenamiento.
Reporta matriz de confusión y distribución.
Error frecuente: sobremuestrear también validación. Corrígelo dejando intactas sus 100 filas.
Pruébalo
Para un segundo modelo sobre las mismas 100 filas, usa TP=5, FP=3, FN=5 y TN=87. Calcula precisión, recall y exactitud.
Comprueba tu resultado
En el segundo modelo, precisión=5/(5+3)=0,625, recall=5/(5+5)=0,50 y exactitud=(87+5)/100=0,92. El primer ejemplo implica FP=5 y FN=5: no mezcles su matriz con la del segundo modelo.
Si introduces un sampler con fit_resample, usa el Pipeline de imbalanced-learn con el sampler dentro de cada entrenamiento de pliegue; el Pipeline ordinario de scikit-learn no lo trata como un transformador común. No calcules SMOTE antes de separar: las muestras sintéticas pueden aprovechar vecinos de evaluación. Sus vecinos y tamaño de clase minoritaria deben ser compatibles con cada pliegue, o el ajuste falla. Compara primero class_weight o una referencia sin muestreo y conserva la distribución original de evaluación. Muestreo.
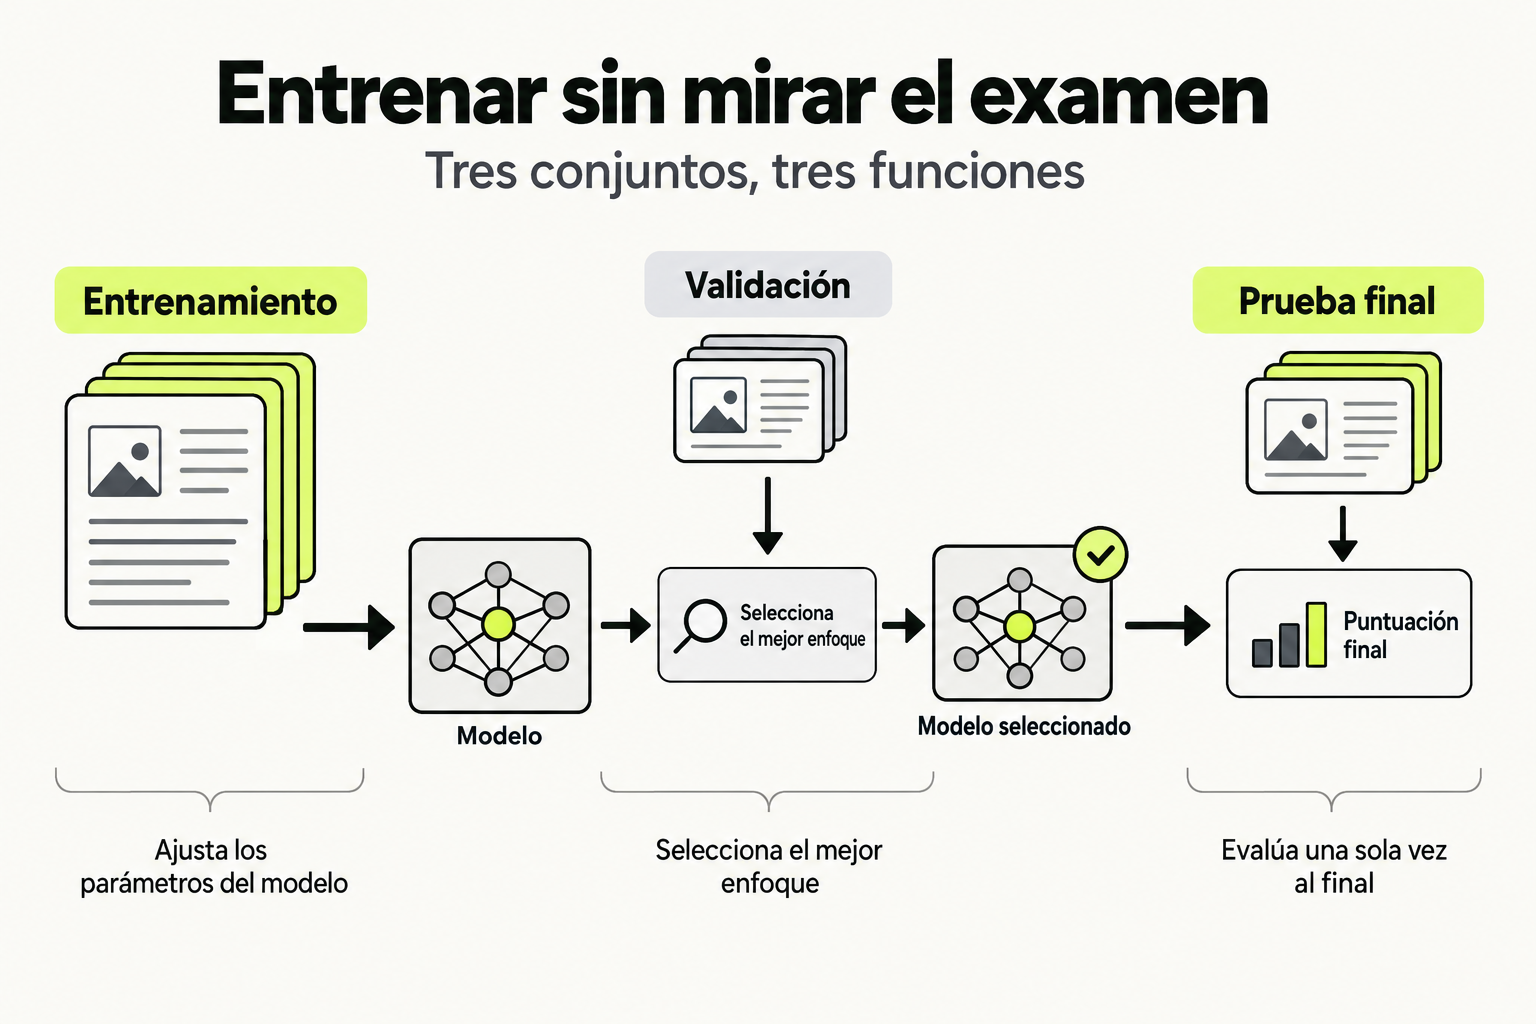
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Fuentes para profundizar
Manejo de Datos Desbalanceados y Técnicas de Samplinge
Esta leccion pertenece al curso Machine Learning Práctico con Scikit-Learn y esta pensada para que avances con criterio profesional, no solo con teoria. Primero entiende el concepto, despues aplicalo en una situacion concreta y finalmente deja evidencia de lo que aprendiste.
Objetivo practico
Al terminar, deberias poder explicar el tema con tus palabras, reconocer cuando usarlo y construir una version simple que sirva como base para un proyecto real.
Pasos recomendados
- Lee el concepto y escribi una definicion breve.
- Identifica un caso de uso laboral donde aparezca este problema.
- Construye un ejemplo pequeno y documenta las decisiones.
- Compara tu resultado con el checklist de la leccion.
Sigue con Machine Learning Práctico con Scikit-Learn
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.