

Lección 13 de 16 · Lectura y práctica
Análisis Exploratorio y Preparación de Datos para Churn
Define churn sin fuga de información, separa entrenamiento y evaluación, y prepara variables con un pipeline que puedas revisar.
Del concepto a la práctica
Taller de esta lección
Preparar churn empieza por fijar unidad, corte y ventana. Si hay una fila por cuenta y corte, renovo_30d pertenece a los 30 días posteriores y nunca entra como predictor. El análisis inicial debe detectar duplicados, nulos y frecuencias antes del modelado.
Ejemplo resuelto
cuenta_id | fecha_corte | meses_activa | plan   | renovo_30d
A1        | 2025-01-01  | 3            | basico | 0
A2        | 2025-01-01  | 12           | pro    | 1
A3        | 2025-01-01  | 7            | pro    | 1
Hay tres cuentas, una etiqueta negativa y dos positivas; la tasa de no renovación es 1/3.
Verifica unicidad por cuenta y corte.
Separa etiqueta e identificador.
Cuenta nulos y clases.
Divide antes de ajustar transformadores.
Error frecuente: usar la fecha de cancelación como predictor. Corrígelo manteniéndola fuera de las variables del corte.
Pruébalo
Añade una cuarta fila con renovo_30d=0 y recalcula la tasa.
Comprueba tu resultado
Hay cuatro filas, dos ceros y dos unos; la tasa de no renovación es 2/4 = 0,50.
La tabla codifica renovación con 1. Si la clase positiva del modelo debe ser churn, define churn_30d = 1 - renovo_30d, excluye ambas etiquetas de los predictores y comunica cuál se usa en recall y precisión. El recuento de ceros en la tabla representa no renovación, no la clase positiva de renovo_30d.
La etiqueta exige observar toda la ventana posterior de30 días. Si una fila se extrajo antes de acabarla o perdió seguimiento, no marques automáticamente churn=0 ni1; identifica la observación incompleta y aplica la política de elegibilidad. Al validar por tiempo, separa también ventanas de etiqueta que se solapen cuando puedan compartir información del futuro; GroupKFold por sí solo no impone orden temporal.
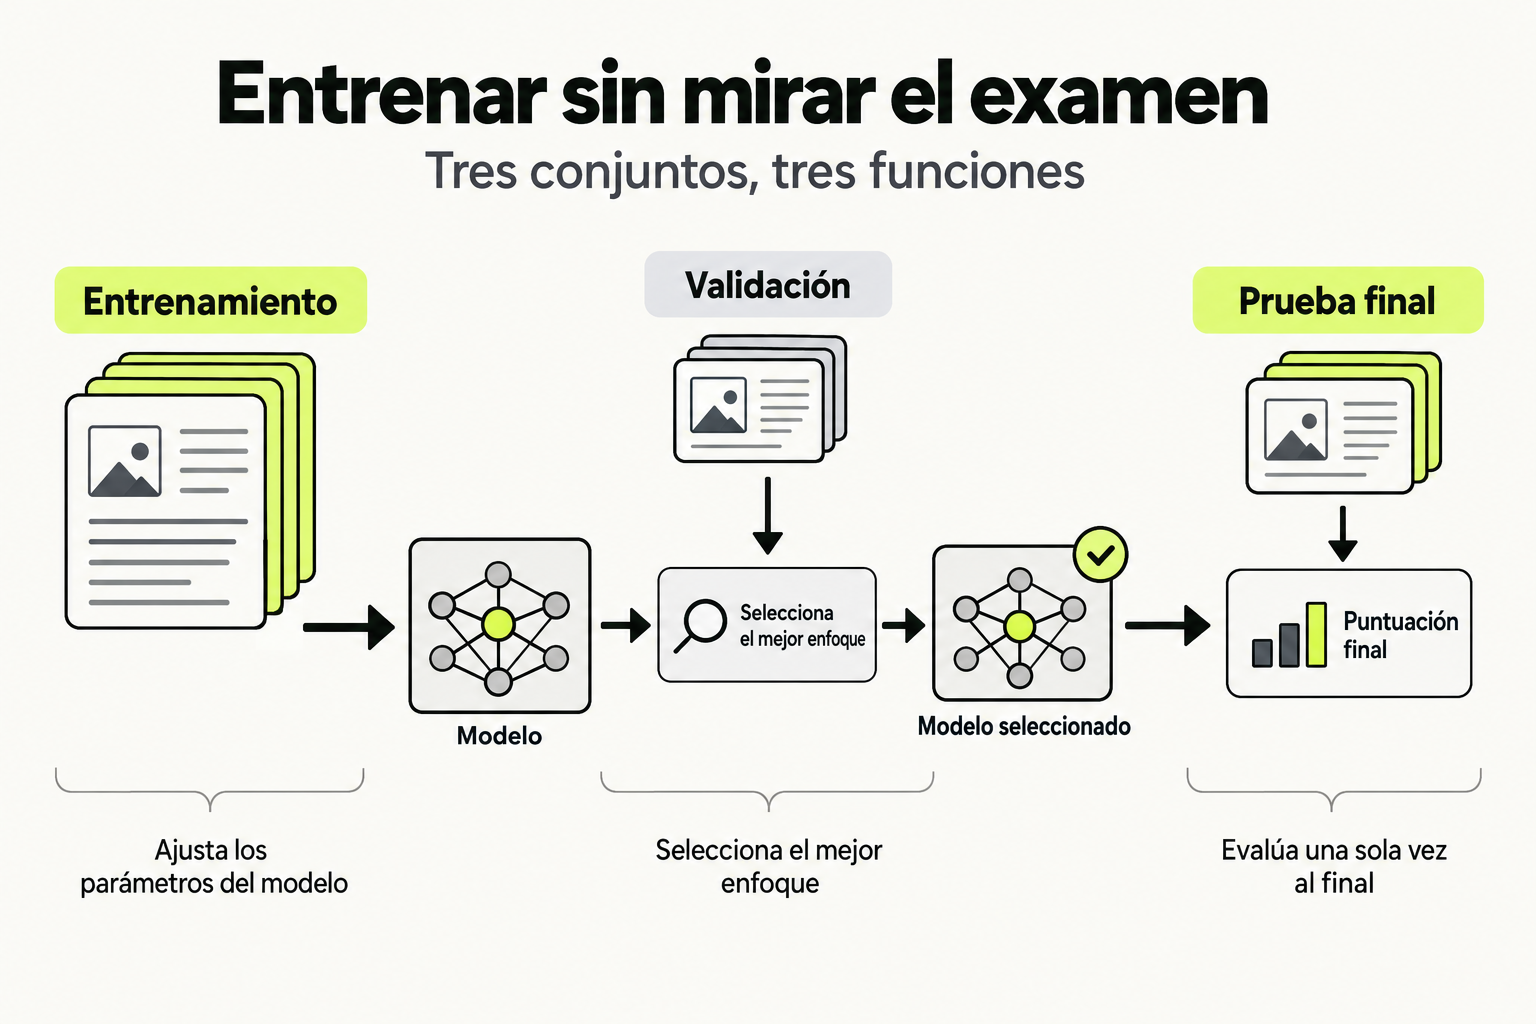
 Mapa de práctica
El entrenamiento ajusta los parámetros del modelo. La validación ayuda a elegir el enfoque sin utilizar la prueba final. Reserva la prueba para evaluar la decisión terminada y evita que sus resultados vuelvan al ajuste.
Ver la infografía en tamaño completo ↗Define qué quieres predecir y cuándo
Para esta práctica, churn significa que una cuenta no renueva en los 30 días posteriores a una fecha de corte ficticia. Las variables solo pueden usar lo que se conocía hasta esa fecha. Si incluyes una fecha de cancelación posterior, el modelo recibe la respuesta disfrazada de variable.
Diccionario del conjunto de práctica
| Campo | Momento disponible | Uso propuesto |
|---|---|---|
| cuenta_id | Identificador | Agrupar registros; no usar como predictor |
| fecha_corte | Inicio de la ventana | Separación temporal |
| meses_activa | Hasta la fecha de corte | Variable numérica |
| contactos_soporte | Antes del corte | Variable numérica |
| plan | En la fecha de corte | Variable categórica |
| renovo_30d | Después del corte | Etiqueta; nunca predictor |
Antes de entrenar, cuenta filas, cuentas distintas, nulos y frecuencia de la etiqueta. Busca duplicados por cuenta y fecha. Una fila por transacción no equivale a una fila por cuenta. Si existen varias observaciones de la misma cuenta, evita que aparezca a ambos lados de una separación sin justificarlo.
Preparación propuesta con scikit-learn
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression

numericas = Pipeline([
    ("imputar", SimpleImputer(strategy="median")),
    ("escalar", StandardScaler()),
])
preparar = ColumnTransformer([
    ("numericas", numericas, ["meses_activa", "contactos_soporte"]),
    ("plan", OneHotEncoder(handle_unknown="ignore"), ["plan"]),
])
modelo = Pipeline([
    ("preparar", preparar),
    ("clasificar", LogisticRegression(max_iter=1000)),
])
# X_train e y_train deben venir de la separación definida.
# modelo.fit(X_train, y_train)
Ajusta el preprocesamiento con entrenamiento, no con toda la tabla antes de separar. El pipeline ayuda a aplicar la misma transformación a evaluación sin volver a aprender sus estadísticas. El fragmento no descarga datos ni reporta un modelo entrenado.
Exploración y práctica
- Escribe la definición de churn, fecha de corte y ventana en una frase.
- Construye una muestra ficticia con un nulo, una categoría nueva y dos filas duplicadas.
- Decide qué harás con cada problema y guarda la tabla de decisiones.
- Separa datos según el uso: temporal si quieres predecir un período posterior; por cuenta cuando corresponda.
- Compara una referencia sencilla con el modelo usando la misma separación y una métrica justificada.
Revisión de tu entregable
- Ninguna columna usa información posterior al corte.
- La etiqueta no aparece en los predictores.
- El preprocesador se ajusta solo con entrenamiento.
- Una categoría no vista y un nulo tienen comportamiento definido.
- Guardas tamaños de los conjuntos, decisión de separación y resultados reales; no una cifra inventada.
Referencias para comprobar la implementación
- scikit-learn: errores comunes y fuga de información
- scikit-learn: pipelines y transformadores compuestos
Documentación consultada el 2 de octubre de 2026. Comprueba también las versiones y condiciones de tu proyecto.
Sigue con Machine Learning Práctico con Scikit-Learn
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.