

Lección 19 de 20 · Lectura y práctica
Práctica: Desarrollar y desplegar el proyecto completo
Concepto claveLa implementación de un sistema de búsqueda full-text y analytics con Elasticsearch y Kibana requiere integrar múltiples componentes en un flujo de datos coherente. Imagina que estás construyendo el motor de.
Del concepto a la práctica
Taller de esta lección
Una entrega reproducible necesita una secuencia que pueda repetirse sin destruir datos importantes. Trabaja primero con un índice local de prueba, valida documentos y consultas, y solo después prepara la publicación autorizada. Un registro de verificación es parte del producto.
Ejemplo resuelto
El flujo mínimo es: crear índices separados catalogo_prueba para productos y ventas_prueba para eventos, cargar dos documentos por índice, ejecutar búsqueda, calcular total y guardar la consulta usada. Si las ventas son 12 y 18 euros, el total esperado es 30.
Fixture: productos A={nombre:"Cuaderno",stock:2} y B={nombre:"Lápiz",stock:1}; ventas V1={product_id:"A",importe:12,fecha:"2026-01-01T00:00:00Z"} y V2={product_id:"B",importe:18,fecha:"2026-01-01T01:00:00Z"}. Usa PUT con IDs estables para repetir sin duplicar y consulta catalogo_prueba para búsqueda, ventas_prueba para suma. Inspecciona cada resultado bulk: un HTTP200 global no significa que todas sus acciones hayan tenido éxito.
Pruébalo
Crea dos índices de prueba vacíos con mapping explícito, sin reutilizar nombres que contengan datos ajenos.
Carga los cuatro documentos mediante una operación repetible.
Ejecuta búsqueda y agregación, anotando respuestas.
Revisa conteos, unidades y filtros antes de cualquier despliegue autorizado.
Comprueba tu resultado
Error frecuente: probar directamente sobre el índice operativo o cargar JSON sin validar. Corrige usando un nombre aislado y comprobación previa. La práctica es correcta si recupera los productos esperados y calcula 30 euros sin duplicar ventas.
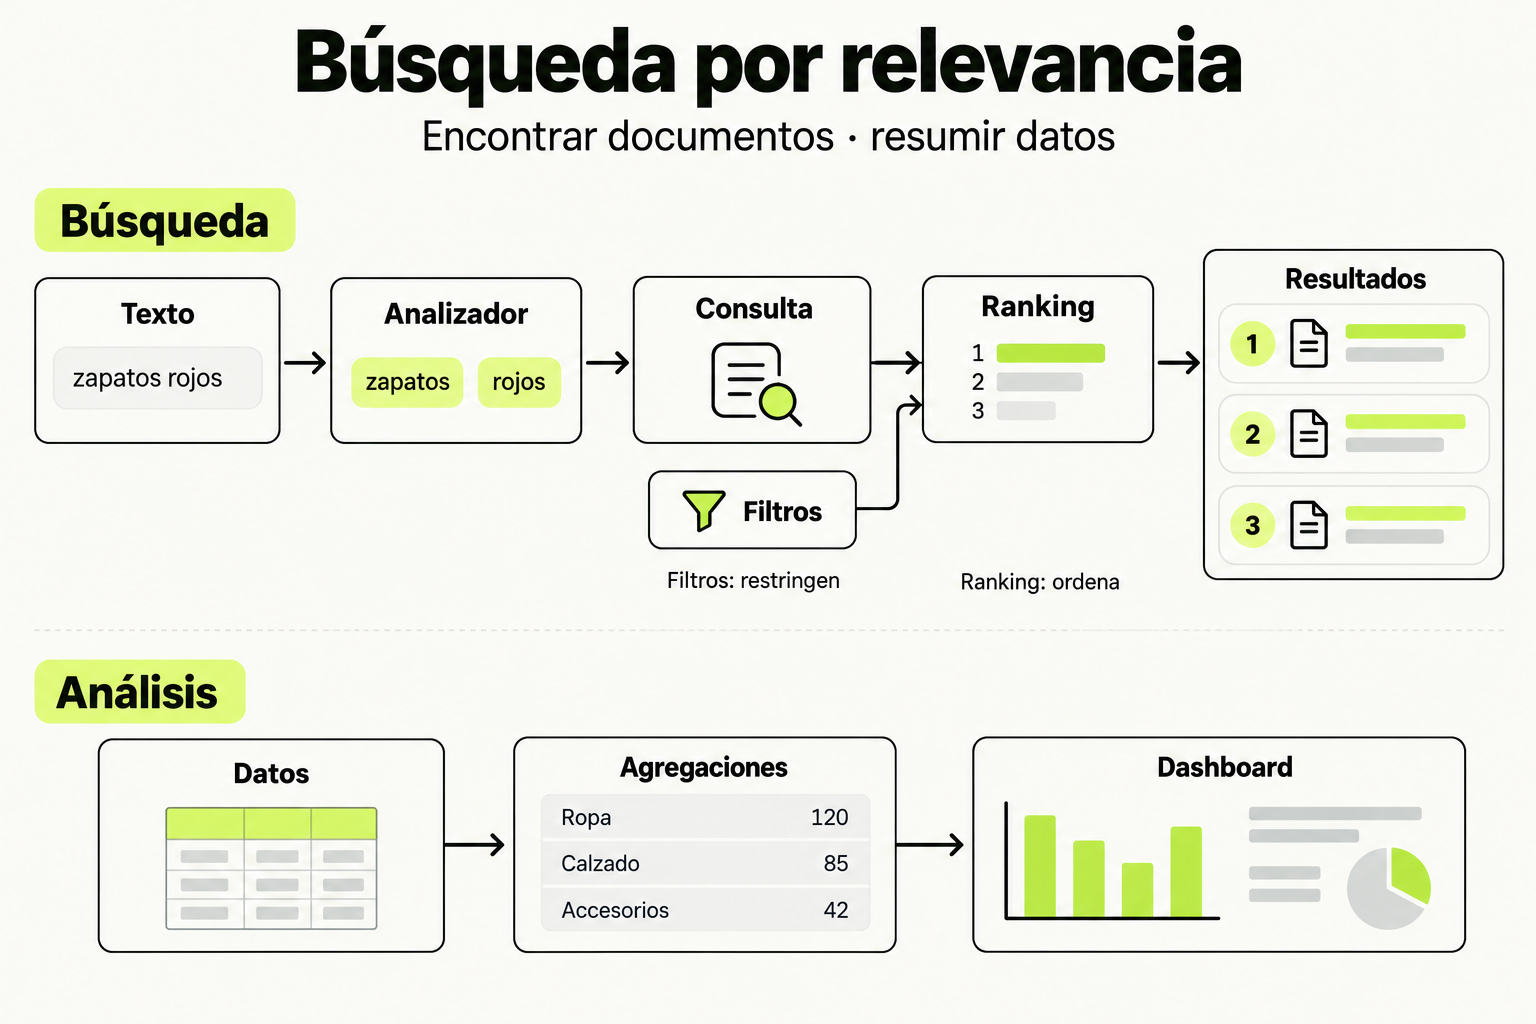
 Mapa de práctica
El analizador convierte texto en términos que la consulta utiliza para buscar documentos. Los filtros restringen qué documentos pueden aparecer y el ranking ordena los resultados según relevancia; filtrar no significa aumentar la puntuación. En un recorrido independiente, las agregaciones resumen grupos de datos para un dashboard. Las cifras y gráficos de ese recorrido son ilustrativos, no una medición de rendimiento.
Ver la infografía en tamaño completo ↗Concepto clave
La implementación de un sistema de búsqueda full-text y analytics con Elasticsearch y Kibana requiere integrar múltiples componentes en un flujo de datos coherente. Imagina que estás construyendo el motor de búsqueda de una plataforma de e-commerce: necesitas indexar productos, permitir búsquedas complejas con filtros, y mostrar dashboards con métricas de rendimiento en tiempo real. El proyecto completo abarca desde la ingesta de datos hasta la visualización, pasando por la optimización de consultas y el despliegue en producción.
En un nivel avanzado, esto implica diseñar mappings personalizados para campos específicos, usar analyzers para procesamiento de texto, y crear pipelines de ingesta que manejen datos heterogéneos. La analogía clave es un sistema de logística: los datos son paquetes que viajan desde fuentes externas (como bases de datos o APIs) hasta Elasticsearch (el almacén), donde se organizan y procesan para ser consultados rápidamente, y Kibana actúa como el centro de control que visualiza el estado del sistema.
Cómo funciona en la práctica
Vamos a desglosar el proceso en pasos concretos para un escenario de analytics de ventas online:
- Configuración del entorno: Instala Elasticsearch y Kibana en un cluster de al menos 3 nodos para alta disponibilidad. Usa Docker para facilitar el despliegue:
docker run -d --name elasticsearch -p 9200:9200 -e "discovery.type=single-node" elasticsearch:8.12.0y similar para Kibana. - Diseño del índice: Crea un índice llamado
ventas_2024con un mapping que defina campos comoproducto_nombre(texto con analyzer español),precio(float),fecha_venta(date), ycategoria(keyword). Incluye settings para replicación y shards. - Ingesta de datos: Usa el Bulk API de Elasticsearch para cargar datos desde un archivo JSON. Por ejemplo, procesa 10,000 registros de ventas simuladas con campos estructurados.
- Consultas avanzadas: Implementa búsquedas full-text con
match_phrasepara nombres de productos, agregaciones para calcular ventas por categoría, y filtros por rango de fechas. - Dashboard en Kibana: Crea visualizaciones como un histograma de ventas diarias, una tabla de productos más vendidos, y un mapa de calor de categorías. Configura un dashboard que combine estas visualizaciones y permita interactividad.
- Despliegue: Empaqueta el proyecto en un script de automatización (por ejemplo, usando Ansible o Kubernetes) y realiza pruebas de carga con herramientas como JMeter para asegurar escalabilidad.
Caso de estudio
Considera una empresa de medios digitales que necesita un sistema para buscar artículos y analizar el engagement de los usuarios. El proyecto incluye:
- Datos: 50,000 artículos con título, contenido, autor, fecha de publicación, y métricas como vistas y tiempo de lectura.
- Requisitos: Búsqueda en tiempo real con sugerencias (autocomplete), análisis de tendencias por autor, y alertas cuando un artículo supera 10,000 vistas.
Implementación:
| Componente | Acción | Resultado |
|---|---|---|
| Mapping | Definir campos con analyzers para español e inglés | Búsqueda precisa en múltiples idiomas |
| Ingesta | Usar Logstash para importar desde una base de datos MySQL | Datos indexados cada hora |
| Consultas | Crear una query con bool para combinar filtros de fecha y búsqueda full-text | Respuesta en <100ms para 95% de las consultas |
| Kibana | Dashboard con gráfico de línea para vistas diarias y tabla de autores top | Monitoreo en tiempo real redujo el tiempo de análisis en 40% |
Este caso mostró que una arquitectura bien diseñada puede manejar 100 consultas por segundo con un latency promedio de 50ms, usando 3 nodos de Elasticsearch con 16GB de RAM cada uno.
Errores comunes
- Over-sharding: Crear demasiados shards (por ejemplo, 100 por índice) puede degradar el rendimiento debido a overhead de gestión. Solución: Usa la regla práctica de 10-20 shards por índice y ajusta basado en el volumen de datos.
- Mapping dinámico sin control: Permitir que Elasticsearch infiera tipos de campos automáticamente puede llevar a inconsistencias (por ejemplo, fechas interpretadas como texto). Solución: Define mappings explícitos y deshabilita el mapping dinámico en producción.
- Falta de monitoreo: No configurar alertas para métricas como heap memory o disk usage puede causar downtime. Solución: Usa Kibana o herramientas como Elastic Alerting para monitorear el cluster.
- Consultas ineficientes Usar
match_allen grandes datasets o no cachear resultados frecuentes. Solución: Aplica paginación confrom/sizey usafiltercontext para consultas que no afectan el scoring. - Ignorar la replicación: Desplegar sin réplicas en entornos de producción riesgo de pérdida de datos en fallos de nodo. Solución: Configura al menos una réplica por índice para alta disponibilidad.
Checklist de dominio
- He diseñado y desplegado un cluster de Elasticsearch con al menos 3 nodos en un entorno similar a producción.
- He creado mappings personalizados para campos complejos (por ejemplo, anidados o geo-point) y configurado analyzers específicos.
- He implementado un pipeline de ingesta que procesa datos desde una fuente externa (como una API o base de datos) usando Bulk API o Logstash.
- He escrito consultas avanzadas que combinan búsqueda full-text, agregaciones (como terms, date_histogram) y filtros, optimizadas para rendimiento.
- He construido un dashboard en Kibana con múltiples visualizaciones interactivas (por ejemplo, gráficos, tablas, mapas) y configurado permisos de acceso.
- He realizado pruebas de carga y ajustado parámetros como shards, replicas, y JVM heap size basado en resultados.
- He documentado el proceso de despliegue y mantenimiento, incluyendo backup y recovery procedures.
Desarrollar un sistema de búsqueda y dashboard para una librería online
En este ejercicio, implementarás un proyecto completo para una librería online que necesita buscar libros y analizar ventas. Sigue estos pasos:
- Configura el entorno: Instala Elasticsearch y Kibana localmente usando Docker. Asegúrate de que ambos servicios estén corriendo y accesibles en
http://localhost:9200yhttp://localhost:5601. - Crea el índice: Diseña un índice llamado
libros_ventascon al menos los siguientes campos:titulo(texto con analyzer español),autor(keyword),precio(float),fecha_publicacion(date),categoria(keyword),ventas_totales(integer). Usa 3 shards y 1 replica. - Ingesta datos: Genera o descarga un dataset simulado de 1,000 libros en formato JSON. Usa el Bulk API de Elasticsearch para indexar estos datos en el índice. Verifica la ingesta con una consulta para contar documentos.
- Implementa búsquedas: Escribe consultas que permitan: a) Búsqueda full-text en título y autor con sugerencias (usando
suggest), b) Filtros por categoría y rango de precios, c) Una agregación que muestre las 5 categorías con más ventas. - Construye el dashboard: En Kibana, crea: a) Un gráfico de barras de ventas por categoría, b) Una tabla de los 10 libros más vendidos, c) Un histograma de ventas por mes basado en fecha de publicación. Combínalos en un dashboard interactivo.
- Optimiza y prueba: Realiza una prueba de carga con 100 consultas concurrentes usando una herramienta como
curlo un script Python. Ajusta la configuración si el latency supera 200ms. - Documenta: Crea un breve informe con los pasos, código de consultas, y capturas del dashboard. Incluye lecciones aprendidas sobre rendimiento.
Pistas
- Usa el comando
curl -X PUTpara crear el índice con mapping explícito y evita el mapping dinámico. - Para la ingesta, estructura el archivo JSON con acciones
indexy datos en líneas alternas, luego usacurl --data-binarycon el Bulk API. - En Kibana, usa el Data Visualizer para explorar los campos antes de crear visualizaciones, y aplica filtros de tiempo si es necesario.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.