

Lección 12 de 20 · Lectura y práctica
Implementar pipeline aggregations para cálculos avanzados
Concepto claveLas pipeline aggregations en Elasticsearch son agregaciones que toman como entrada los resultados de otras agregaciones para realizar cálculos adicionales. A diferencia de las agregaciones métricas o de buckets que.
Del concepto a la práctica
Taller de esta lección
Una pipeline aggregation trabaja con resultados ya agrupados. Para calcular crecimiento no basta restar: debes declarar periodo anterior y actual, conservar unidades y evitar división entre cero. Con ventas mensuales de enero 100 y febrero 125, el aumento absoluto es 25 y el relativo 25%.
Ejemplo resuelto
Agrupa por mes, calcula sum de ventas y calcula la diferencia mediante serial_diff con lag1. bucket_selector elimina buckets según un predicado y no devuelve por sí solo una nueva métrica de crecimiento. La fórmula relativa es (125 - 100) / 100 * 100 = 25%.
Con fecha como date e importe numérico, indexa J1={fecha:"2026-01-15T00:00:00Z",importe:100} y F1={fecha:"2026-02-15T00:00:00Z",importe:125}. Esta consulta devuelve las sumas y la diferencia de febrero frente a enero:
{"size":0,"aggs":{"meses":{"date_histogram":{"field":"fecha","calendar_interval":"month","time_zone":"UTC","min_doc_count":0},"aggs":{"total":{"sum":{"field":"importe"}},"cambio":{"serial_diff":{"buckets_path":"total","lag":1}}}}}}El primer bucket no tiene anterior y no se interpreta como crecimiento cero. El segundo tiene diferencia25; calcula aparte25/100×100=25%. Si la base fuera cero, informa porcentaje no definido en vez de dividir por cero.
Pruébalo
Inserta dos documentos, uno por mes, con importes 100 y 125.
Crea buckets temporales.
Expón la suma de cada bucket.
Calcula la diferencia y el porcentaje indicando que la base es enero.
Comprueba tu resultado
Error frecuente: llamar 25% a la diferencia 25 euros. Corrige mostrando ambos valores y sus unidades. El ejercicio debe producir diferencia absoluta 25 euros y variación relativa 25%, con una condición explícita si la base vale cero.
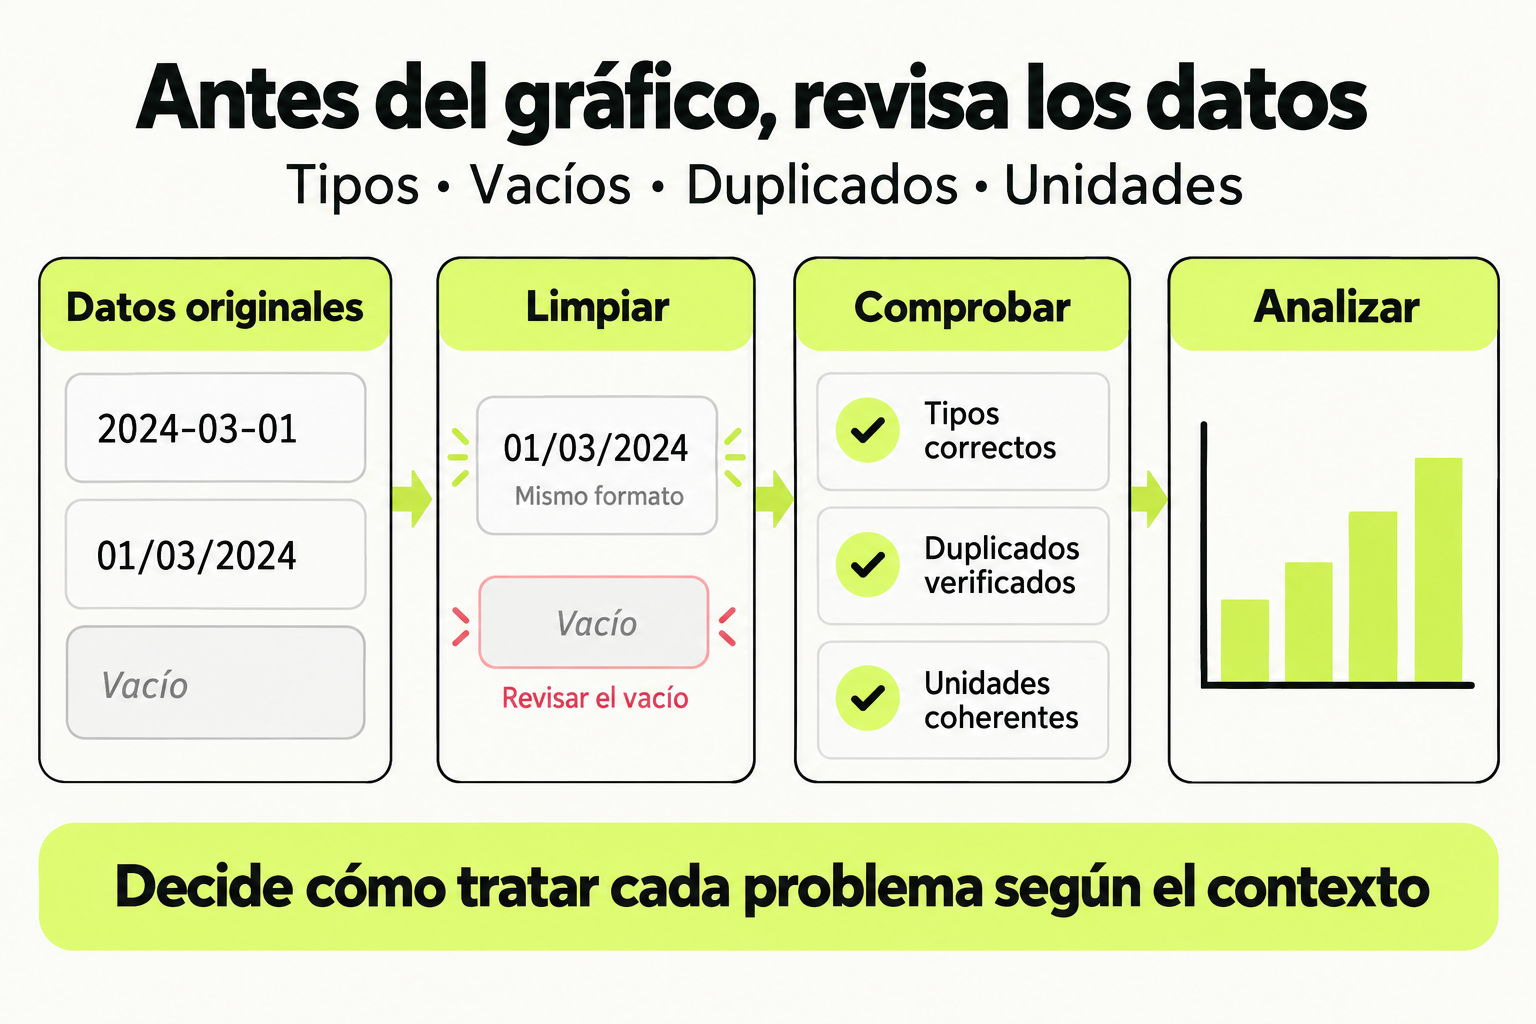
 Mapa de práctica
Antes de analizar, comprueba los tipos, valores vacíos, duplicados y unidades. Decide cómo tratar cada problema según el contexto y conserva la trazabilidad del cambio. Un gráfico solo es útil si los datos de entrada son coherentes.
Ver la infografía en tamaño completo ↗Concepto clave
Las pipeline aggregations en Elasticsearch son agregaciones que toman como entrada los resultados de otras agregaciones para realizar cálculos adicionales. A diferencia de las agregaciones métricas o de buckets que operan directamente sobre documentos, las pipeline aggregations operan sobre los resultados de agregaciones previas en el pipeline de procesamiento.
Imagina que estás analizando ventas de una tienda online. Primero agrupas las ventas por categoría (agregación de buckets), luego calculas el total de ventas por categoría (agregación métrica). Una pipeline aggregation te permitiría calcular, por ejemplo, la diferencia porcentual entre las ventas de cada categoría y el promedio general, o identificar qué categoría tiene el crecimiento más rápido comparando períodos diferentes.
Estas agregaciones son esenciales para análisis avanzados porque permiten:
- Comparar resultados entre diferentes buckets
- Calcular derivados como tasas de crecimiento o diferencias
- Normalizar datos para análisis comparativos
- Identificar outliers o tendencias anómalas
Cómo funciona en la práctica
Veamos un ejemplo paso a paso usando datos de ventas mensuales. Supongamos que tenemos un índice ventas-2024 con documentos que contienen fecha, producto, categoria, y monto.
Primero, creamos una agregación básica para obtener ventas totales por categoría:
GET ventas-2024/_search
{
  "size": 0,
  "aggs": {
    "ventas_por_categoria": {
      "terms": {
        "field": "categoria.keyword",
        "size": 10
      },
      "aggs": {
        "total_ventas": {
          "sum": {
            "field": "monto"
          }
        }
      }
    }
  }
}
Ahora, agregamos una pipeline aggregation para calcular qué porcentaje representa cada categoría del total general:
GET ventas-2024/_search
{
  "size": 0,
  "aggs": {
    "ventas_por_categoria": {
      "terms": {
        "field": "categoria.keyword",
        "size": 10
      },
      "aggs": {
        "total_ventas": {
          "sum": {
            "field": "monto"
          }
        },
        "porcentaje_del_total": {
          "bucket_script": {
            "buckets_path": {
              "ventas_categoria": "total_ventas"
            },
            "script": "params.ventas_categoria / _aggs.total_ventas.value * 100"
          }
        }
      }
    },
    "total_ventas": {
      "sum_bucket": {
        "buckets_path": "ventas_por_categoria>total_ventas"
      }
    }
  }
}
En este ejemplo:
ventas_por_categoriaagrupa por categoría y calcula el total de ventas por cada unatotal_ventas(al nivel raíz) suma todos los buckets para obtener el total generalporcentaje_del_totales una pipeline aggregation de tipobucket_scriptque calcula el porcentaje usando el total de la categoría y el total general
Caso de estudio
Una plataforma de streaming necesita identificar qué géneros de contenido están creciendo más rápido para guiar decisiones de adquisición de licencias. Tienen datos diarios de visualizaciones por género durante los últimos 90 días.
Objetivo: Calcular la tasa de crecimiento semanal para cada género y rankearlos.
Solución con pipeline aggregations:
GET visualizaciones/_search
{
  "size": 0,
  "aggs": {
    "por_semana": {
      "date_histogram": {
        "field": "fecha",
        "calendar_interval": "week"
      },
      "aggs": {
        "por_genero": {
          "terms": {
            "field": "genero.keyword"
          },
          "aggs": {
            "visualizaciones_semanales": {
              "sum": {
                "field": "duracion_minutos"
              }
            }
          }
        },
        "crecimiento_generos": {
          "bucket_script": {
            "buckets_path": {
              "current": "por_genero['Acción']>visualizaciones_semanales",
              "previous": "por_genero['Acción']>visualizaciones_semanales[1]"
            },
            "script": "(params.current - params.previous) / params.previous * 100"
          }
        }
      }
    }
  }
}
Este pipeline:
- Agrupa datos por semana y dentro de cada semana por género
- Calcula visualizaciones totales por género por semana
- Usa
bucket_scriptpara comparar la semana actual con la anterior - Calcula el porcentaje de crecimiento para cada género
Resultado en tabla:
| Género | Semana 1 | Semana 2 | Crecimiento |
|---|---|---|---|
| Acción | 15,000 min | 18,000 min | 20% |
| Comedia | 12,000 min | 13,200 min | 10% |
| Drama | 8,000 min | 7,200 min | -10% |
Las pipeline aggregations permiten calcular métricas derivadas en tiempo real sin necesidad de post-procesamiento externo, lo que es crucial para dashboards interactivos en Kibana.
Errores comunes
1. Referenciar buckets que no existen: Al usar buckets_path, asegúrate de que la agregación referenciada existe y devuelve valores. Un error común es referenciar un bucket que podría estar vacío para algunos documentos.
2. No manejar valores nulos o división por cero: En scripts de bucket_script, siempre incluye validaciones. Por ejemplo: params.previous != 0 ? (params.current - params.previous) / params.previous * 100 : 0
3. Confundir el nivel de la pipeline aggregation: Algunas pipeline aggregations deben estar al nivel raíz (como avg_bucket), mientras otras deben estar dentro de buckets específicos. Revisa la documentación de Elasticsearch para cada tipo.
4. Olvidar que pipeline aggregations no pueden ser anidadas: No puedes poner una pipeline aggregation dentro de otra pipeline aggregation directamente. Necesitas estructurar tu pipeline correctamente.
5. No optimizar para performance: Pipeline aggregations pueden ser costosas computacionalmente. Usa size para limitar buckets cuando sea posible y considera usar composite aggregations para datasets grandes.
Checklist de dominio
- Puedo explicar la diferencia entre agregaciones métricas y pipeline aggregations
- Sé usar al menos 3 tipos diferentes de pipeline aggregations (bucket_script, derivative, moving_avg)
- Puedo construir un pipeline que compare resultados entre diferentes períodos de tiempo
- Sé cómo manejar casos edge como valores nulos o división por cero en scripts
- Puedo identificar cuándo una pipeline aggregation debe estar al nivel raíz vs dentro de un bucket
- Sé optimizar queries con pipeline aggregations para mantener buen performance
- Puedo visualizar los resultados de pipeline aggregations en Kibana correctamente
Analizar tendencias de precios en tiempo real con pipeline aggregations
Implementa un sistema de monitoreo de precios para un marketplace de electrónicos. Tienes un índice precios-productos con documentos que contienen: timestamp, producto_id, categoria, precio, y vendedor.
Objetivo: Crear una agregación que identifique qué categorías tienen la mayor volatilidad de precios (diferencia entre precio máximo y mínimo como porcentaje del precio promedio) en las últimas 24 horas.
Pasos:
- Crea una agregación que agrupe por categoría para las últimas 24 horas
- Para cada categoría, calcula: precio mínimo, precio máximo, y precio promedio
- Usa una pipeline aggregation para calcular la volatilidad como:
(max - min) / avg * 100 - Ordena las categorías por volatilidad descendente
- Limita los resultados a las top 5 categorías más volátiles
- Incluye manejo de errores para evitar división por cero
Requisitos técnicos:
- Usa
rangequery para filtrar últimas 24 horas - Usa
termsaggregation para agrupar por categoría - Usa
min,max, yavgmetric aggregations - Implementa la pipeline aggregation con
bucket_script - Usa
bucket_sortpara ordenar y limitar resultados
Pistas
- Recuerda que necesitas calcular el promedio antes de poder usarlo en el cálculo de volatilidad
- Presta atención a la estructura de buckets_path para acceder a las métricas calculadas
- Considera usar un script condicional para manejar el caso donde avg sea 0
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.