

Lección 17 de 20 · Lectura y práctica
Implementar índices y búsquedas avanzadas para el dataset
Concepto claveLa implementación de índices y búsquedas avanzadas en Elasticsearch es el núcleo de cualquier sistema de búsqueda full-text y analytics. Imagina que estás construyendo un motor de búsqueda para una plataforma de.
Del concepto a la práctica
Taller de esta lección
La implementación debe seguir el orden mapping, datos, consulta y comprobación. Separar esos pasos ayuda a localizar si un resultado vacío proviene de una carga incompleta, un campo mal tipado o una condición demasiado estricta.
Ejemplo resuelto
Para dos productos, cámara compacta disponible y trípode compacta agotado, un nombre ficticio elegido para compartir exactamente el token compacta, busca compacta, filtra disponibilidad y excluye stock cero. La consulta debe tocar texto en nombre y usar un campo numérico para el stock.
El fixture es C1={nombre:"cámara compacta",stock:2} y T1={nombre:"trípode compacta",stock:0}. Sin stemming, compacto y compacta son tokens distintos; por eso una versión del ejercicio con trípode compacto no recuperaría necesariamente ambos. Después de cargar espera visibilidad de búsqueda mediante refresh=wait_for en la operación de indexación del laboratorio antes de contar.
Pruébalo
Crea el índice con
nombrecomotextystockcomo entero.Indexa los dos documentos.
Ejecuta
matchy después añade el filtrostock > 0.Registra el total de coincidencias en cada etapa.
Comprueba tu resultado
Error frecuente: crear el mapping después de indexar y esperar que cambie el tipo existente. Corrige creando un índice de prueba nuevo y cargando de nuevo los datos. El primer paso recupera dos documentos y el filtrado final solo uno.
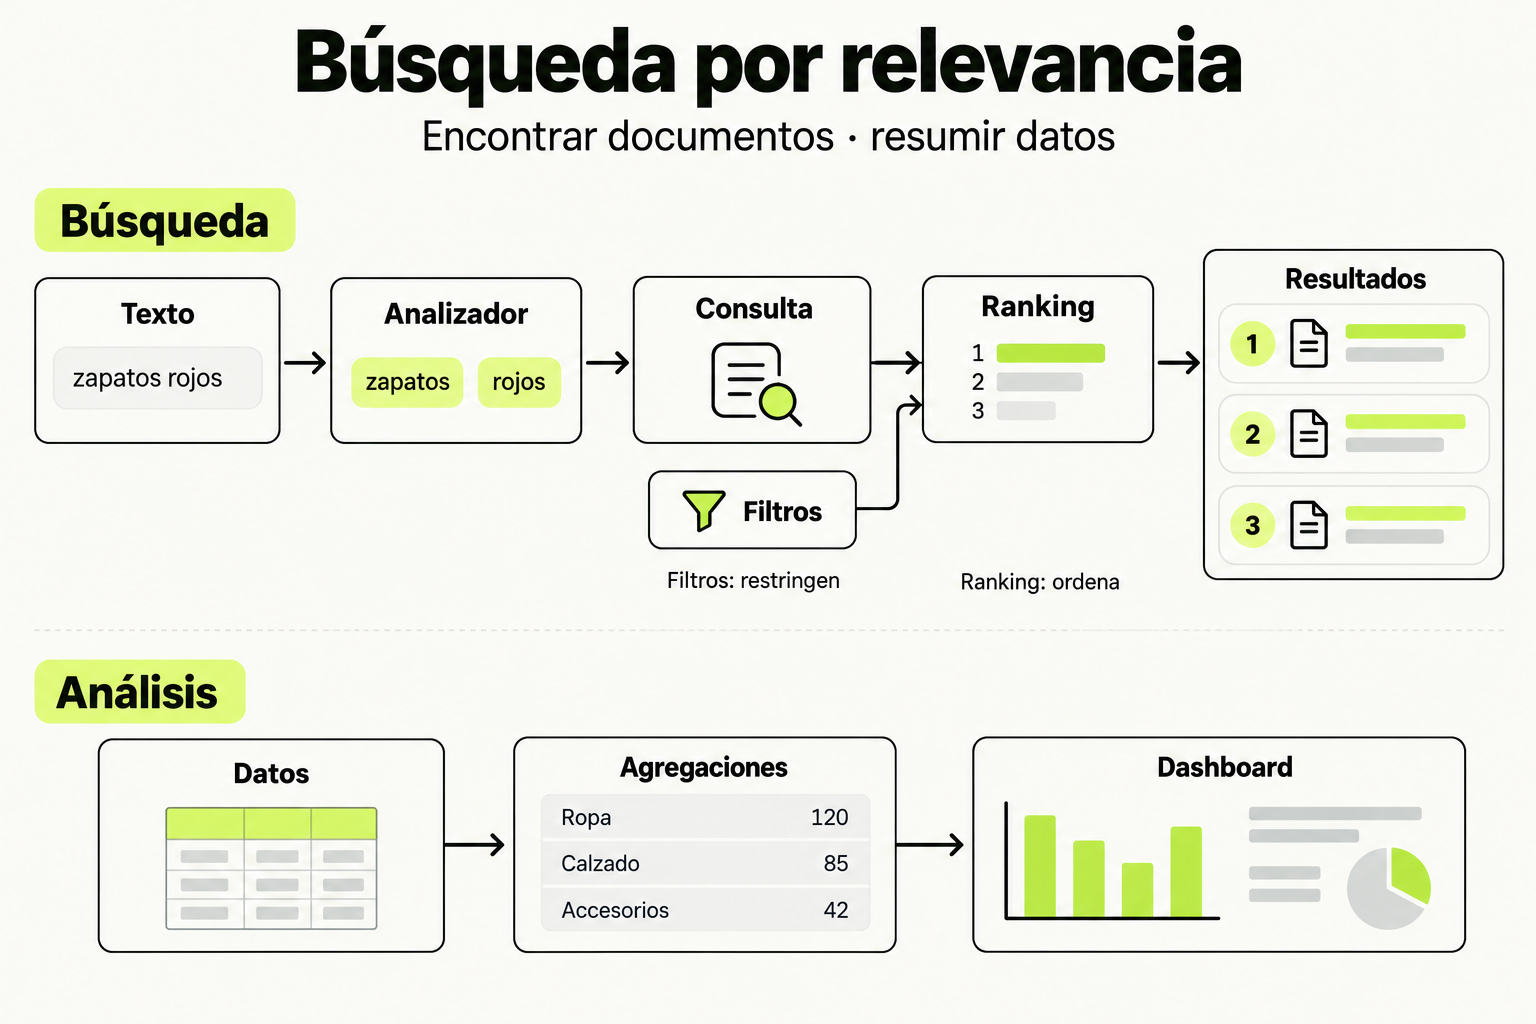
 Mapa de práctica
El analizador convierte texto en términos que la consulta utiliza para buscar documentos. Los filtros restringen qué documentos pueden aparecer y el ranking ordena los resultados según relevancia; filtrar no significa aumentar la puntuación. En un recorrido independiente, las agregaciones resumen grupos de datos para un dashboard. Las cifras y gráficos de ese recorrido son ilustrativos, no una medición de rendimiento.
Ver la infografía en tamaño completo ↗Concepto clave
La implementación de índices y búsquedas avanzadas en Elasticsearch es el núcleo de cualquier sistema de búsqueda full-text y analytics. Imagina que estás construyendo un motor de búsqueda para una plataforma de e-commerce con millones de productos. No basta con buscar por palabras clave simples; necesitas que los usuarios encuentren productos relevantes incluso cuando escriben consultas ambiguas, con errores tipográficos, o en diferentes idiomas. Los índices en Elasticsearch no son solo almacenes de datos; son estructuras optimizadas que determinan cómo se indexan, almacenan y recuperan los documentos. Las búsquedas avanzadas van más allá del match simple, incorporando análisis de texto (como tokenización y stemming), puntuación de relevancia (usando algoritmos como BM25), y funcionalidades como fuzzy search o synonyms para mejorar la precisión y recall.
En un contexto avanzado, esto implica diseñar mappings personalizados que definan tipos de campos (text, keyword, date, etc.) y analizadores específicos. Por ejemplo, para un campo de descripción de producto, podrías usar un analizador que convierta el texto a minúsculas, elimine stopwords (palabras comunes como "el" o "y"), y aplique stemming para reducir palabras a su raíz (ej., "corriendo" a "corr"). Las búsquedas avanzadas utilizan queries como multi-match para buscar en múltiples campos, bool queries para combinar condiciones lógicas (AND, OR, NOT), y aggregations para analytics en tiempo real, como calcular el precio promedio de productos en una categoría. Esto no es solo teoría; en la industria, sistemas como los de Amazon o Netflix dependen de estas técnicas para ofrecer resultados personalizados y rápidos.
Cómo funciona en la práctica
Vamos a implementar un índice para un dataset de reseñas de productos, con el objetivo de permitir búsquedas full-text y analytics. Supongamos que tenemos datos en formato JSON con campos como "product_name", "review_text", "rating", "category", y "timestamp". Primero, definimos el mapping en Elasticsearch para optimizar la búsqueda. Usamos el Kibana Dev Tools o la API REST de Elasticsearch.
PUT /product_reviews
{
  "mappings": {
    "properties": {
      "product_name": {
        "type": "text",
        "fields": {
          "keyword": {
            "type": "keyword"
          }
        }
      },
      "review_text": {
        "type": "text",
        "analyzer": "spanish"
      },
      "rating": {
        "type": "integer"
      },
      "category": {
        "type": "keyword"
      },
      "timestamp": {
        "type": "date"
      }
    }
  }
}
Explicación paso a paso: Creamos un índice llamado "product_reviews". En el mapping, "product_name" es de tipo text para búsqueda full-text, pero también tiene un subcampo keyword para agregaciones exactas. "review_text" usa el analizador "spanish" predefinido en Elasticsearch, que aplica tokenización, lowercasing, y stemming en español. "category" es keyword para filtros rápidos, y "timestamp" es date para rangos temporales. Luego, indexamos algunos documentos:
POST /product_reviews/_doc/1
{
  "product_name": "Smartphone XYZ",
  "review_text": "El telefono tiene una camara excelente y bateria duradera.",
  "rating": 5,
  "category": "electronics",
  "timestamp": "2023-10-01T10:00:00"
}
Para búsquedas avanzadas, ejecutamos una query multi-match que busca en múltiples campos con boosting (mayor peso):
GET /product_reviews/_search
{
  "query": {
    "multi_match": {
      "query": "camara buena",
      "fields": ["review_text^2", "product_name"],
      "type": "best_fields"
    }
  },
  "aggs": {
    "avg_rating_by_category": {
      "terms": {
        "field": "category"
      },
      "aggs": {
        "avg_rating": {
          "avg": {
            "field": "rating"
          }
        }
      }
    }
  }
}
Esta query busca "camara buena" en review_text (con peso 2) y product_name, usando el tipo best_fields para devolver el mejor match por documento. Además, incluye una aggregation para calcular el rating promedio por categoría, útil para dashboards en Kibana.
Caso de estudio
Considera una empresa de medios que tiene un dataset de artículos de noticias con campos como "title", "content", "author", "tags", "publish_date", y "view_count". El objetivo es implementar un sistema de búsqueda que permita a los usuarios encontrar artículos relevantes y analizar tendencias. Usamos un índice con mapping avanzado:
| Campo | Tipo | Configuración | Propósito |
|---|---|---|---|
| title | text | analyzer: spanish, fields: keyword | Búsqueda full-text y filtros exactos |
| content | text | analyzer: spanish con custom stopwords | Búsqueda en el cuerpo del artículo |
| tags | keyword | - | Agrupación y filtrado rápido |
| publish_date | date | format: yyyy-MM-dd | Rangos temporales para analytics |
| view_count | integer | - | Métricas para dashboards |
Implementamos una búsqueda que combine full-text con filtros y aggregations. Por ejemplo, para encontrar artículos sobre "tecnologia" publicados en el último mes y ordenados por relevancia, con un análisis de tags populares:
GET /news_articles/_search
{
  "query": {
    "bool": {
      "must": [
        {
          "multi_match": {
            "query": "tecnologia",
            "fields": ["title", "content"]
          }
        }
      ],
      "filter": [
        {
          "range": {
            "publish_date": {
              "gte": "now-1M"
            }
          }
        }
      ]
    }
  },
  "aggs": {
    "top_tags": {
      "terms": {
        "field": "tags",
        "size": 5
      }
    }
  },
  "sort": [
    {
      "_score": {
        "order": "desc"
      }
    }
  ]
}
Esta query usa una bool query con must para la búsqueda full-text y filter para el rango de fechas, asegurando que solo artículos recientes sean considerados. La aggregation "top_tags" identifica los tags más comunes en los resultados, útil para un dashboard en Kibana que muestre tendencias. En producción, esto podría escalar a millones de documentos, con índices particionados por tiempo (usando ILM - Index Lifecycle Management) para optimizar el rendimiento.
En sistemas reales, el diseño de índices y búsquedas avanzadas puede reducir el tiempo de respuesta de segundos a milisegundos, impactando directamente la experiencia del usuario y las métricas de negocio.
Errores comunes
Al implementar índices y búsquedas avanzadas, los Search Engineers suelen cometer estos errores:
- Usar el mapping por defecto sin personalización: Elasticsearch asigna tipos automáticamente, pero esto puede llevar a problemas como campos de texto tratados como keyword, limitando la búsqueda full-text. Solución: Siempre define un mapping explícito basado en el uso de los campos, probando con datos de muestra.
- Ignorar el análisis de texto para idiomas específicos: Si tu dataset está en español, no uses el analizador estándar (que está optimizado para inglés), ya que no maneja bien acentos o stemming en español. Solución: Usa analizadores predefinidos como "spanish" o crea custom analyzers con filtros como asciifolding para normalizar caracteres.
- Sobrecargar las búsquedas con aggregations complejas en tiempo real: Incluir muchas aggregations en cada query puede ralentizar la respuesta, especialmente con grandes volúmenes de datos. Solución: Separa las búsquedas de las aggregations cuando sea posible, usando índices rollup o consultas asíncronas para analytics pesados.
- No probar la relevancia de los resultados Confiar en la configuración por defecto de scoring (como BM25) sin ajustar parámetros como boost o usar funciones de scoring personalizadas puede dar resultados poco relevantes. Solución: Realiza pruebas A/B con consultas reales y ajusta los pesos de los campos o usa script scoring si es necesario.
- Olvidar la gestión del ciclo de vida de los índices En datasets que crecen con el tiempo, como logs o eventos, no implementar ILM puede llevar a índices enormes que afecten el rendimiento. Solución: Configura políticas de ILM para rotar, fusionar o eliminar índices basados en edad o tamaño.
Checklist de dominio
Para verificar que dominas esta lección, asegúrate de poder:
- Diseñar un mapping personalizado para un dataset real, definiendo tipos de campos y analizadores apropiados.
- Implementar una búsqueda multi-match con boosting en múltiples campos y explicar cómo afecta la relevancia.
- Usar bool queries para combinar búsquedas full-text con filtros (ej., por rango de fechas o categorías).
- Agregar aggregations a una query de búsqueda para calcular métricas como promedios o términos más frecuentes.
- Indexar documentos en Elasticsearch usando la API REST o Kibana Dev Tools, y verificar el mapping creado.
- Identificar y corregir errores comunes en mappings, como campos mal tipados o analizadores incorrectos.
- Integrar los resultados de búsqueda y aggregations en un dashboard de Kibana para visualización.
Implementar un índice y búsqueda avanzada para un dataset de ventas
En este ejercicio, trabajarás con un dataset simulado de ventas de una tienda online. Tu objetivo es crear un índice en Elasticsearch, indexar datos, y ejecutar búsquedas avanzadas con aggregations. Sigue estos pasos:
- Prepara el dataset: Usa los siguientes datos en formato JSON (puedes copiarlos en Kibana Dev Tools):
[ {"order_id": 1, "product": "Laptop Gaming", "category": "electronics", "price": 1200, "quantity": 2, "sale_date": "2023-09-15", "customer_rating": 4}, {"order_id": 2, "product": "Camiseta Deportiva", "category": "clothing", "price": 25, "quantity": 5, "sale_date": "2023-09-20", "customer_rating": 5}, {"order_id": 3, "product": "Libro de Programación", "category": "books", "price": 40, "quantity": 1, "sale_date": "2023-10-01", "customer_rating": 3}, {"order_id": 4, "product": "Auriculares Inalámbricos", "category": "electronics", "price": 80, "quantity": 3, "sale_date": "2023-10-05", "customer_rating": 4}, {"order_id": 5, "product": "Zapatos Running", "category": "clothing", "price": 60, "quantity": 2, "sale_date": "2023-10-10", "customer_rating": 4} ] - Crea el índice: Define un mapping para el índice "sales_data" con los siguientes campos: "product" (text con subcampo keyword), "category" (keyword), "price" (integer), "quantity" (integer), "sale_date" (date), "customer_rating" (integer). Usa la API PUT en Kibana Dev Tools.
- Indexa los datos: Inserta los documentos en el índice usando la API POST. Verifica que los documentos se hayan indexado correctamente con una búsqueda simple.
- Implementa una búsqueda avanzada: Ejecuta una query que:
- Busque productos que contengan la palabra "gaming" en el campo product (usando match query).
- Filtre por ventas en el mes de septiembre de 2023 (usando range query en sale_date).
- Incluya una aggregation para calcular el precio total por categoría (suma de price * quantity).
- Ordene los resultados por customer_rating descendente.
- Analiza los resultados: Observa los documentos devueltos y los resultados de la aggregation. ¿Cuál categoría tiene el mayor precio total? Explica brevemente en un comentario.
Entrega: Proporciona el código JSON del mapping, la query de búsqueda, y una captura de pantalla o texto de los resultados en Kibana.
Pistas
- Recuerda que para fechas, puedes usar formatos como "yyyy-MM-dd" en el mapping y consultas con "gte" y "lte" en range queries.
- En la aggregation para precio total, necesitarás usar una scripted metric o calcular sum(price * quantity); considera usar una pipeline aggregation si es más simple.
- Si no ves resultados en la búsqueda, verifica que los datos se indexaron correctamente y que el mapping permite búsqueda full-text en el campo product.
Evalua tu comprension
Completa el quiz interactivo de arriba para ganar XP.
Sigue con Implementación Avanzada de Búsqueda Full-Text y Analytics con Elasticsearch y Kibana
Esta lección forma parte de un curso de Cursalo. Revisa su programa y elige entre la compra individual o el acceso a toda la escuela.
Si ya tenías acceso a este curso, entra con tu cuenta: tus derechos y tu progreso se conservan. No necesitas comprarlo de nuevo.